> For the complete documentation index, see [llms.txt](https://docs.maiagent.ai/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.maiagent.ai/tech/ja/quickstart/rag.md).
# RAG ナレッジベース検索システム
RAG(Retrieval-Augmented Generation、検索拡張生成)は、ナレッジベースから関連する段落を取得し、大規模言語モデルに渡して回答を生成します。本ページでは MaiAgent のデータ処理と検索の流れとして、解析、ベクトル化、ハイブリッド検索、Reranker、類似度しきい値、ラベルフィルタリングを説明します。
RAG(Retrieval-Augmented Generation、検索拡張生成)では、大規模言語モデルが回答する前に、ナレッジベースから質問に関連する段落を取得し、その内容に基づいて回答します。これにより、モデルは学習データだけに頼らず、組織独自の文書を参照できます。
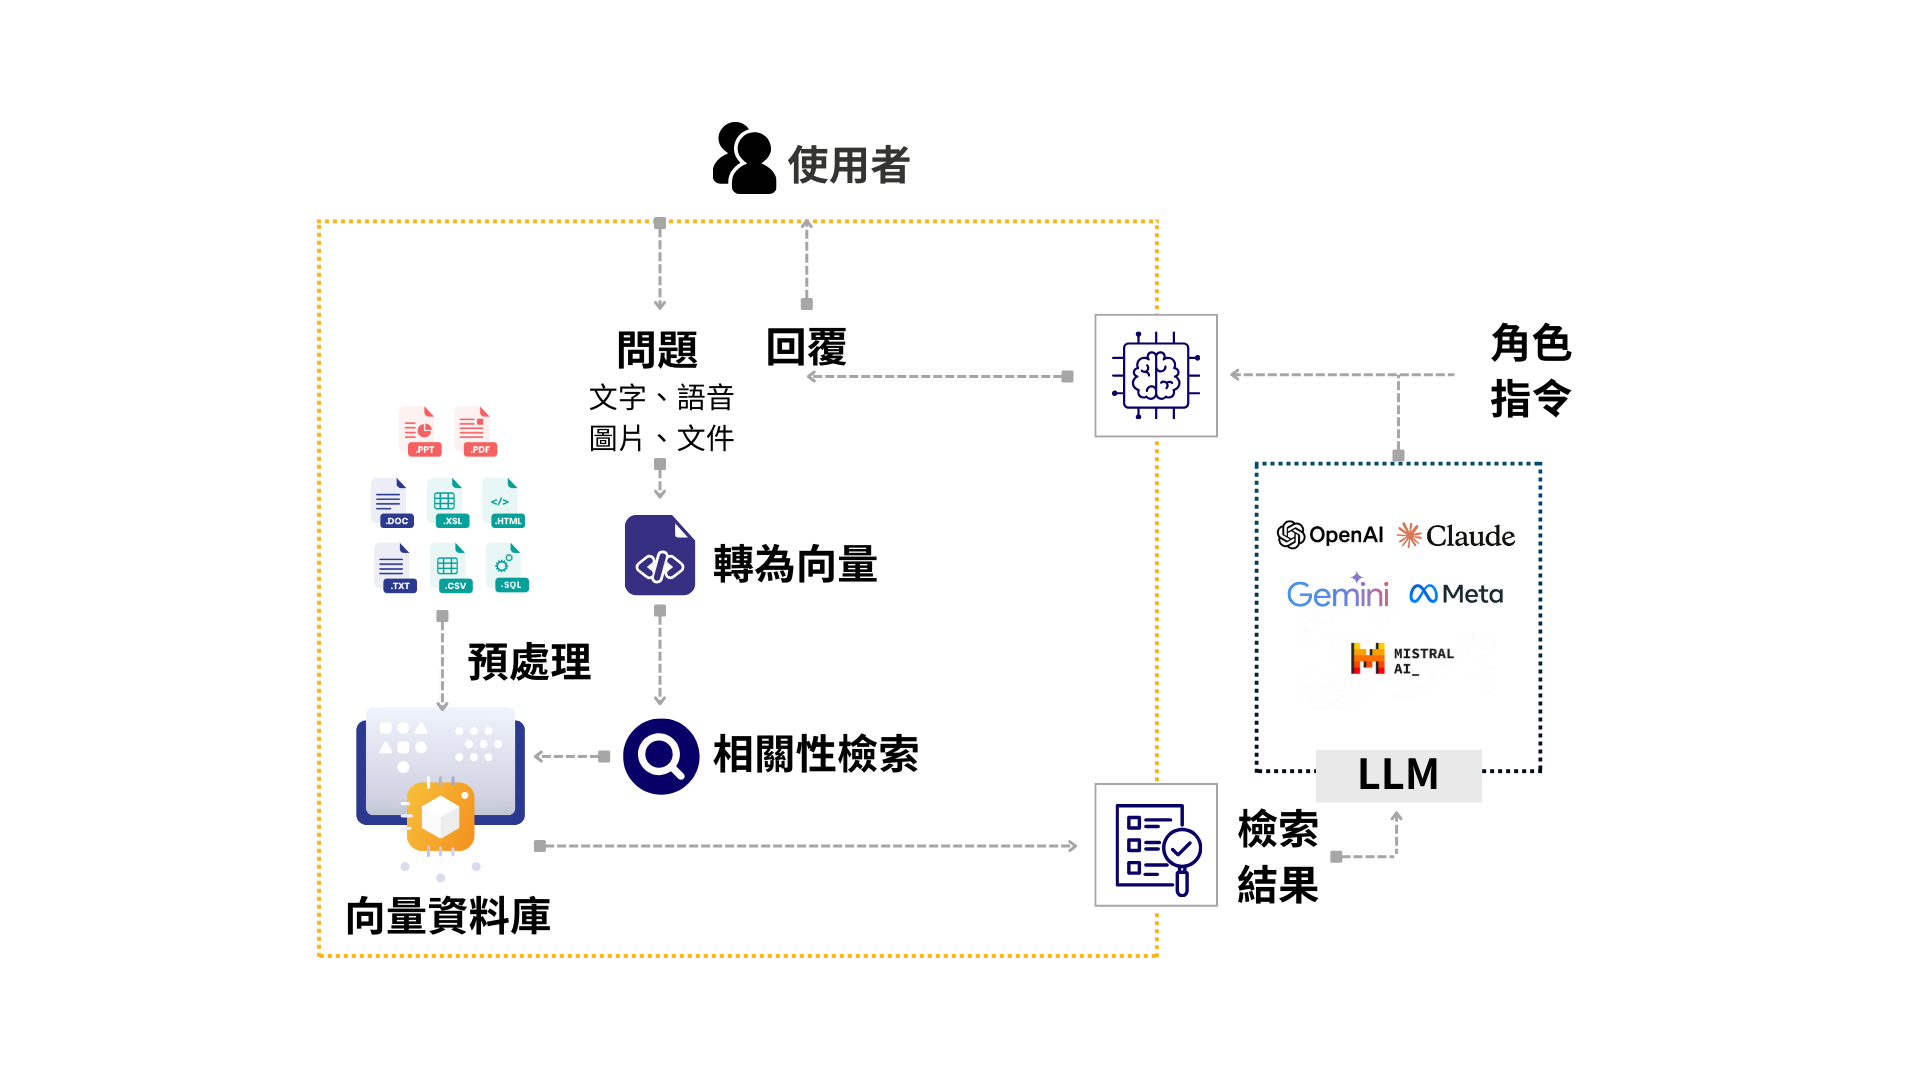
RAG の処理フロー
RAG は、資料の持ち込みが可能な試験に例えられます。モデルがすべての資料を暗記する必要はなく、回答するたびにナレッジベースを調べ、質問に最も関連する段落を根拠として使います。そのため、ナレッジベースには Agent のタスクに関連する資料だけを入れることをおすすめします。無関係な内容もコンテキストとして検索される可能性があり、かえって回答の精度を下げる場合があります。
本ページでは、MaiAgent の実際の処理フローと調整できるパラメーターを説明します。管理画面の操作手順は、ユーザーマニュアルの [ナレッジベースの概要](https://docs.maiagent.ai/build/knowledge-base/km) をご覧ください。
## データがナレッジベースに取り込まれる流れ
ナレッジベースにアップロードされたファイルは、順に以下の処理を受けます。
1. **解析**:パーサーがファイルをテキストに変換します(必要に応じてテーブルや画像も処理します)。[Parser 解析ツール](/tech/ja/quickstart/parser.md) をご覧ください。
2. **チャンク分割**:テキストを段落(チャンク)に分割します。その後の検索と引用は、この段落を単位として行います。
3. **ベクトル化**:ナレッジベースで選択した Embedding モデルが各段落をベクトルに変換します。[Embedding モデル](/tech/ja/quickstart/embedding.md) をご覧ください。
4. **ベクトルデータベースへの書き込み**:段落のテキストとベクトルを一緒にベクトルデータベースへ書き込みます。デフォルトではプラットフォーム内蔵のデータベースを使用しますが、独自のデータベースにも接続できます。[独自のベクトルデータベースの利用](/tech/ja/platform-development/bring-your-own-vector-db.md) をご覧ください。
ファイルのステータスが `done` になってから、内容が検索対象になります。
## 1 回の検索の流れ
### 1. 検索範囲の決定
検索前に、プラットフォームが今回検索できるナレッジベース、ファイル、ラベルを決定し、その条件をベクトルデータベースのクエリに直接適用します。範囲外の段落は検索結果に含まれず、モデルにも渡されません。
範囲は、メッセージ → 会話 → 連絡先のクエリメタデータ(Query Metadata)の順に取得します。いずれも設定されていない場合は Agent のデフォルトのラベルフィルターを適用し、それもなければナレッジベース全体を検索します。設定方法は [Query Metadata の概要](/tech/ja/identity-and-access/zhi-shi-guan-li-quan-xian-query-metadata-cha-xun-yuan-zi-liao-zong-lan.md) と、ユーザーマニュアルの [ナレッジベースのラベルフィルタリング](https://docs.maiagent.ai/build/agent/label-filter) をご覧ください。
{% hint style="warning" %}
「誰がどの文書を閲覧できるか」を制限するには、クエリメタデータまたはラベルフィルターを使用し、システムプロンプトだけに頼らないでください。システムプロンプトは検索後にモデルに渡すテキストであり、すでに検索された段落を遮断することはできません。
{% endhint %}
### 2. ハイブリッド検索
デフォルトでは、**ハイブリッド検索**で 2 種類のクエリを同時に実行します。
* **ベクトル検索**:質問のベクトルを使って意味の近い段落を探します。表現が異なっていても見つけられます。
* **キーワード検索(BM25)**:語句を照合します。製品の型番、固有名詞、コードの検索に適しています。
ナレッジベースで Reciprocal Rank Fusion を有効化(RRF)をオンにすると、2 種類の結果を RRF によって順位に基づいて統合します。Elasticsearch で RRF を使用するには、Enterprise、Platinum、Trial のいずれかのライセンスが必要です。独自の Elasticsearch に該当ライセンスがない場合、管理画面でこのオプションが自動的に無効になります。プラットフォームでハイブリッド検索が無効になっている場合は、ベクトル検索のみを使用します。
Agent との会話では、常にプラットフォームの設定に従って検索し、別のモードは選べません。一方、管理画面の [検索テスト](https://docs.maiagent.ai/build/knowledge-base/test-search-result#search-modes) と [ナレッジベース検索 API](/tech/ja/api-integration/knowledge-base-api.md#search-knowledge-base) では、ベクトルのみ(セマンティック検索、`semantic`)またはキーワードのみ(キーワード検索、`keyword`、Elasticsearch のみ)を指定し、それぞれが何を取得するか比較できます。
### 3. Reranker による並べ替え
ナレッジベースで 検索結果の並べ替えを有効化 (Reranking) をオンにすると、最初の段階で多めに候補段落を取得します(取得チャンク数 × プラットフォーム設定の倍率。デフォルトは 7 倍です)。その後、Reranker モデルが質問と各段落を比較して再評価し、スコアが高い順に 取得チャンク数 件だけを残します。[Reranker モデル](/tech/ja/quickstart/reranker.md) をご覧ください。
組織の Credits がプラットフォームのしきい値を下回ると、その会話では Reranker をスキップし、最初の段階の結果をそのまま使用します。
### 4. 類似度しきい値
類似度しきい値(0-1) は、Reranker のスコアがしきい値を下回る段落を除外します。デフォルトは 0 で、フィルタリングしません。このしきい値は Reranker のスコアに適用されるため、**Reranker が有効な場合のみ機能します**。高く設定しすぎると段落が 1 件も残らず、モデルが参照できる資料がなくなる場合があります。
### 5. 複数のナレッジベースの統合
Agent に複数のナレッジベースが接続されている場合、各ナレッジベースの結果を統合し、Agent の 最大取得ブロック数 に従って、最終的にモデルへ渡す段落数を決定します。今回検索したナレッジベースのうち 1 つでも Reranker が有効であれば、統合後の結果をもう一度並べ替えます。
### 6. モデルへの送信と引用の表示
選択した段落を、Agent のシステムプロンプトと一緒に大規模言語モデルへ送信します。ファイルのメタデータフィールドで 検索時に使用 をオンにしている場合、その値もモデルへ渡され、回答の判断材料になります。回答内の引用から、元の段落とファイルにアクセスできます。
## Agentic RAG:Agent モードでの検索
上記のフローは「1 回の検索、1 回の生成」です。各メッセージで必ず検索してから回答し、モデルは検索するかどうかや何を検索するかを決定しません。Agentic RAG では、検索の判断をモデルに委ねます。回答中に検索を複数回呼び出し、前回の結果に応じてクエリを調整したり、キーワードを変更したり、別のファイルを読んだりしたうえで、回答をまとめることができます。
MaiAgent では、この 2 つの方式は Agent の回答モードに対応します。
| 回答モード | 検索方法 |
| ----------------------------------- | --------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| RAG Q\&A(API の `replyMode: normal`) | 1 回の検索:各メッセージで本ページのフローに従って 1 回検索し、段落を直接モデルへ渡します |
| Agent モード(`replyMode: agent`) | Agentic RAG:ナレッジベースをツールとしてモデルに提供します。同じターン内で段落を複数回検索し、ファイル名やメタデータでファイルを絞り込み、キーワードでファイル内容を検索し、ファイル全体を読むことができます。各呼び出しは本ページの検索フローに従います(Query Metadata による範囲制限を含みます) |
Agent モードの検索回数は Agent の実行上限によって制限されます([Function Calling:実行上限](/tech/ja/advanced-genai-tech/function-calling.md#limits) をご覧ください)。遅延と使用量も 1 回の検索より増えます。回答が 1 つの段落にある Q\&A 用途では RAG Q\&A で十分です。複数の文書を比較したり、ファイルを探してから詳しく読んだりする用途には Agent モードを使用してください。
## 会話モードと Agent モードでのナレッジベース検索
前節を踏まえて、2 つのモードの違いを項目ごとに比較します。
| | RAG Q\&A(会話モード、`replyMode: normal`) | Agent モード(`replyMode: agent`) |
| ---------------------------------- | ---------------------------------------------------------------------------------------------------------------------------- | -------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| 検索のタイミング | 各メッセージに回答する前に、モデルの判断を介さず**必ず** 1 回検索します | 検索は**ツール**です。モデルが質問に応じて、呼び出すかどうか、回数、クエリ文字列を決定します |
| 取得件数 | 各ナレッジベースでそれぞれの 取得チャンク数 を取得し、統合後に Agent の 最大取得ブロック数 で切り詰めます | `retrieve_text_nodes` ツールの `top_k` はモデルが指定します(デフォルトは 3)。そのため、通常は取得チャンク数より少なくなります。Agent で 完全な検索範囲の使用を強制 をオンにした場合は、常に 最大取得ブロック数 を使用します |
| 利用できるツール | ありません。今回取得した段落だけを使用します | `retrieve_text_nodes`(セマンティック/ハイブリッド検索)、`query_files`(ファイルとメタデータの一覧)、`grep_files`(ファイル内容の文字列照合)、`read_file`(ファイル全体の読み取り)、`get_surrounding_context`(段落の前後のコンテキスト取得)、`image_search`(マルチモーダルのナレッジベースでの画像検索。ツール設定で無効化できます) |
| クエリメタデータ、ラベルフィルター、Reranker、類似度しきい値 | 両モードに同じルールで適用されます | |
| 会話中にアップロードした添付ファイル | アップロード時に直ちに解析とインデックス作成を行い、回答時にナレッジベースと一緒に検索します。取得件数には Agent の最大取得ブロック数を使います | アップロード時には解析しません。Agent が質問に応じて添付ファイルツール(`parse_attachment_content`、`read_attachment_full_text`、`ingest_attachment`)で読み取りやインデックス作成を行います。[メッセージの添付ファイルの処理](/tech/ja/api-integration/api_knowledge.md#attachment-processing) をご覧ください |
| 検索結果が不十分な場合 | ナレッジベースのパラメーターと Agent の最大取得ブロック数を調整します | まずモデルが検索ツールを呼び出したか確認します([会話詳細と実行タイムライン](https://docs.maiagent.ai/build/agent-ops/evaluations/trace-timeline)でツール呼び出しを確認できます)。その後、パラメーターを調整するか、システムプロンプトで先にナレッジベースを検索するよう指示します |
{% hint style="warning" %}
Agent で ツール検索機能を有効化(動的ツール検索)をオンにすると、ナレッジベースのツールも「検索してから読み込む」対象になります。Text to SQL や API ツールと同様に、先に `tool_searching_tool` を呼び出す必要があります。モデルが検索をスキップし、「ナレッジベース検索ツールがない」と回答して他のツールだけを使う場合があります。その際は、システムプロンプトに「回答前に `retrieve_text_nodes` でナレッジベースを検索してください」と明記するか、ツール検索を無効にしてすべてのツールを直接利用できるようにしてください。ナレッジベースを接続するだけでは自動検索は行われず、検索ツールを別途作成する必要もありません。
{% endhint %}
## 調整できるパラメーター
| パラメーター | 設定場所 | デフォルト値 | 説明 |
| ------------------------------------------------------------ | ------- | --------------- | --------------------------------------------------------------- |
| Embedding モデル | ナレッジベース | プラットフォーム設定によります | 作成後は管理画面で変更できません。変更するには別のナレッジベースを作成するか、MaiAgent の担当者にお問い合わせください |
| 取得チャンク数 | ナレッジベース | 12 | 各ナレッジベースから取得する段落の最大数です。最小値は 1 です |
| 検索結果の並べ替えを有効化 (Reranking) | ナレッジベース | 有効 | 有効にすると、ナレッジベースで選択した Reranker モデルを使用します |
| 類似度しきい値(0-1) | ナレッジベース | 0 | Reranker が有効な場合のみ機能します |
| Reciprocal Rank Fusion を有効化 | ナレッジベース | プラットフォーム設定によります | ハイブリッド検索の結果を統合する方法です。OpenSearch のハイブリッド検索では有効化が必須です |
| 最大取得ブロック数 | Agent | 12 | 会話時に最終的にモデルへ渡す段落数です。画面では 5~15 が推奨され、数値が高いほど遅延が増えます |
特定の質問でどの段落が取得されるか確認するには、管理画面の [検索テスト](https://docs.maiagent.ai/build/knowledge-base/test-search-result) を使用するか、[ナレッジベース検索 API](/tech/ja/api-integration/knowledge-base-api.md#search-knowledge-base) を呼び出してください。
### 調整方法
チャンクのサイズと重なりはパーサーが決定し、管理画面には調整項目がありません。調整できるのは以下のパラメーターです。1 回に 1 項目だけを変更し、同じ質問セットを使って検索テストで比較してください。
| 症状 | 最初に確認すること | 次の調整 |
| ---------------------------------------- | --------------------------------------------------------------------- | ------------------------------------------------------------------------------- |
| 正しい段落が見つかるものの、順位が低いか切り捨てられます | 検索テストでの順位を確認します | Reranker を有効にします。それでも不十分な場合は取得チャンク数と最大取得ブロック数を増やします(遅延と token 使用量が増えます) |
| 無関係な段落が頻繁に含まれます | Reranker を有効にした後の段落順を確認します | 類似度しきい値を上げます(1 回に 0.05~0.1 ずつ。高すぎると結果がなくなります)。またはラベルフィルターで範囲を絞ります |
| 型番、コード、固有名詞が見つかりません | キーワード検索で見つかるか確認します | 文書の表記がユーザーと一致しているか確認します。ハイブリッド検索が無効な場合は有効に戻します(Elasticsearch には RRF ライセンスが必要です) |
| テーブルや長い文書について、部分的な回答しか得られません | チャンクがテーブルを分断していないか確認します | 別のパーサーで再解析するか、チャンク内にテーブルのヘッダーや章名を追加するか、Agent で完全な検索範囲の使用を強制する設定をオンにします |
| 回答で添付ファイルだけが使われ、ナレッジベースが使われません(またはその逆です) | Agent モードのツール呼び出し履歴を確認します | システムプロンプトで先にナレッジベースを検索するよう明記します。会話モードでは両方を一緒に検索するため、最大取得ブロック数を増やします |
| Reranker を有効にしても効果がありません | 組織の Credits がプラットフォームのしきい値を下回っていないか確認します(下回ると Reranker が自動的にスキップされます) | 先に Credits をチャージしてから比較します |
Embedding モデルは作成後に変更できず、モデルを変更するにはナレッジベースを再構築する必要があります。本番運用を開始する前に、検索テストで異なるモデルの結果を比較して決定してください。
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://docs.maiagent.ai/tech/ja/quickstart/rag.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.