> For the complete documentation index, see [llms.txt](https://docs.maiagent.ai/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.maiagent.ai/tech/ja/quickstart/parser.md).
# Parser 解析ツール
ナレッジベースの文書パーサーと音声文字起こしパーサーについて、対応形式、画像やスキャンファイルの処理方法、オフラインでの動作、自動検出の選択ルール、課金方式を説明します。
## Parser とは?
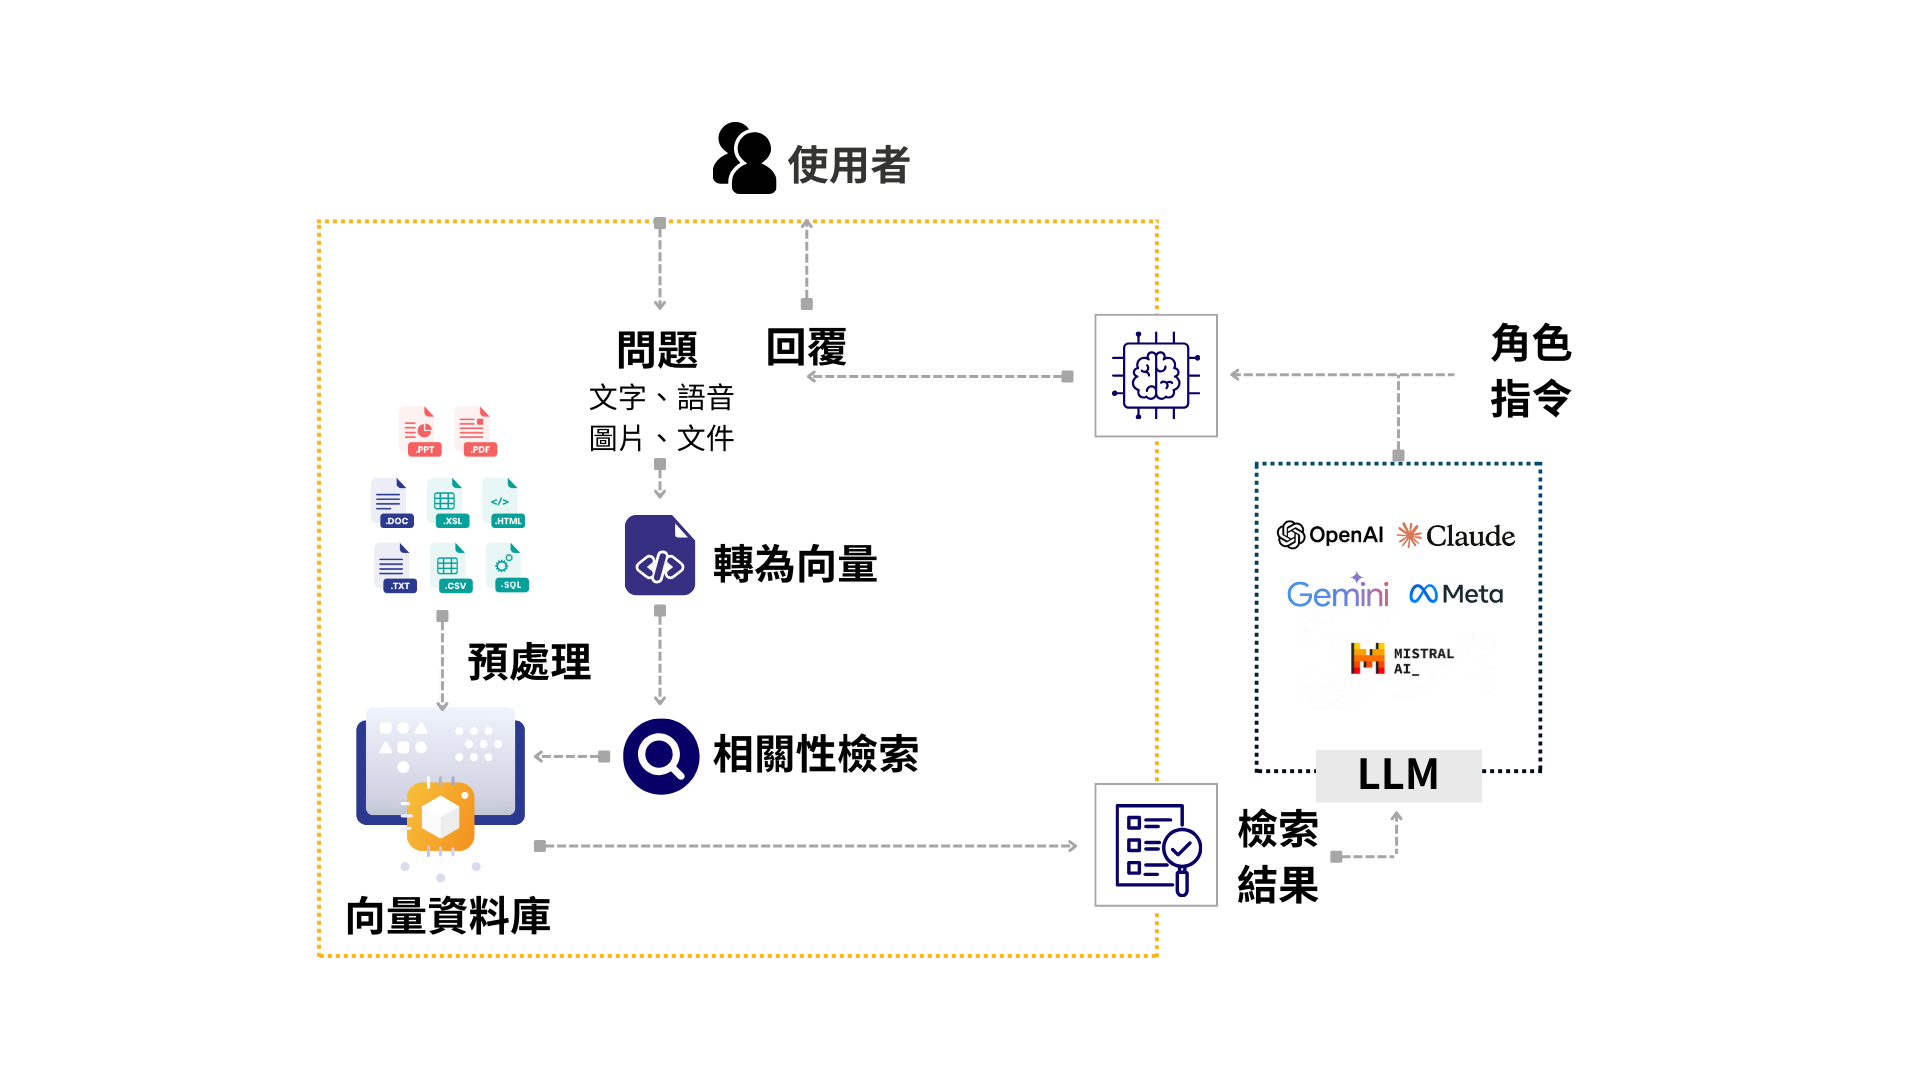
Parser(パーサー)は、ナレッジベースにアップロードされた元のファイルをテキストに変換し、ベクトル化と検索の前処理を行います。解析の品質は、その後に必要な内容を見つけられるかどうかに直結します。テーブルの構造が保持されるか、画像やスキャンページ内の文字が読み取られるかは、この段階で決まります。
RAG の処理フロー
アップロード時にファイルごとにパーサーを指定できます。管理画面での操作は、ユーザーマニュアルの [ナレッジベースの作成方法:基本設定](https://docs.maiagent.ai/build/knowledge-base/km-basic-settings) をご覧ください。各パーサーで利用できるファイル形式は、`GET /api/v1/allowed-file-specs/` でも取得できます。
***
## 文書パーサー
MaiAgent クラウドでは、現在 3 種類の文書パーサーを提供しています。
| 項目 | MaiAgent Parser(デフォルト) | MaiAgent Parser (Offline) | Vision Parser |
| ----------------- | ----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | ------------------------------------------- | -------------------------------------------------- |
| 処理方法 | ファイル内のテキスト、テーブル、画像を直接読み取ります | レイアウト解析によって文書構造(見出し、テーブル)を保持します | クラウドのマルチモーダルモデルが文書をページごとに視覚的に読み取り、Markdown に変換します |
| 画像とスキャンページ | 埋め込み画像を抽出します。テキストレイヤーのないベクトル図形のページには OCR を実行します | マルチモーダルモデルを設定すると、PDF に OCR と画像説明を追加します | 視覚理解によって画像、グラフ、スキャンページの内容を読み取ります |
| 大規模言語モデルの使用 | しません | マルチモーダルモデルを設定した場合のみ使用します | 使用します |
| オフライン(ネットワークなし)環境 | 利用できます | 利用できます。画像説明にはオンプレミスのマルチモーダルモデルが必要です | 利用できません。クラウドモデルへの接続が必要です |
| 対応形式 | `.pdf` `.doc` `.docx` `.odt` `.xls` `.xlsx` `.csv` `.ods` `.ppt` `.pptx` `.odp` `.epub` `.txt` `.json` `.jsonl` `.md` `.eml` および画像ファイル `.png` `.jpg` `.jpeg` `.gif` `.webp` `.tiff` | `.pdf` `.docx` `.pptx` `.md` `.html` `.htm` | `.pdf` `.doc` `.docx` `.odt` `.ppt` `.pptx` `.odp` |
* **画像ファイル**(`.png`、`.jpg` など)をナレッジベースに追加するには、マルチモーダルに対応した Embedding モデルを使用する必要があります。[Embedding モデル](/tech/ja/quickstart/embedding.md#before-you-choose) をご覧ください。
* MaiAgent Parser (Online) は現在、プラットフォーム全体で無効化されており、選択できません。
* オンプレミス環境で利用できるパーサーはデプロイ設定によって異なります。MaiAgent の担当者にお問い合わせください。
#### Gemini 画像認識パーサー
上記の 3 種類に加えて、**Gemini 3.1 Pro Preview**(Google Vertex AI 経由)で画像認識(OCR)を行うパーサーを有効にすることもできます。対応形式は Vision Parser と同じです(`.pdf`、Word、PowerPoint、OpenDocument 文書。Office ファイルは先に PDF に変換されます)。
| 項目 | 説明 |
| ----------------- | --------------------------------------------------------------------------------------------------------------- |
| 処理方法 | PDF 全体を一度にモデルへ送信して認識し、ページごとには分割しません |
| ファイルごとの上限 | 50 MB または 1,000 ページです |
| 文書全体の認識に失敗した場合 | 自動的に 50 ページずつに分けて再送信します |
| 課金 | モデルの実際の入力・出力使用量に応じて Credits を消費し、消費履歴には同様に `Vision parsing input: ファイル名`、`Vision parsing output: ファイル名` と記録されます |
| オフライン(ネットワークなし)環境 | 利用できません。Vertex AI への接続が必要です |
デフォルトのパーサーと「自動検出(デフォルト)」の選択ルールは変わりません。必要に応じて、アップロード画面または文書一覧の パーサー ドロップダウンから手動で選択してください。パーサー一覧はプラットフォーム側で設定されます。この選択肢が表示されない場合は、MaiAgent の担当者にお問い合わせください。
#### 「自動検出(デフォルト)」と解析の課金
PDF、Word(.docx)、PowerPoint(.pptx)をナレッジベースにアップロードする際、アップロード画面の各ファイル横にあるパーサーのドロップダウンは、デフォルトで 自動検出(デフォルト) になっています。常に MaiAgent Parser を使うわけではありません。アップロード後にファイル構造を読み取り、パーサーを決定します。
* テキストのみで、明確な画像コンテンツがないファイル → そのファイル形式のデフォルトパーサー(通常は MaiAgent Parser)を使用します。
* スキャンファイル(テキストレイヤーなし)、画像コンテンツを含むファイル(設計図やスキャン文書など)、PowerPoint → OCR または視覚理解に対応したパーサー(MaiAgent Parser (Offline)、Vision Parser)から選択します。適切なパーサーが見つからない場合は、デフォルトパーサーを使用します。
判定基準はファイル構造(テキストレイヤーの有無、画像やテーブルを含むページ数)であり、画像の枚数ではありません。Word ファイルは、画像が埋め込まれていれば画像コンテンツを含むものとして扱われます。そのため、画像が少ない文書でも上記のパーサーに切り替わる場合があります。実際に使用されたパーサーは、ナレッジベースの文書一覧にある パーサー 列で確認してください。
ポイントは、**実際に解析を完了したパーサー**に基づいて計算されます。各パーサーの課金単位、再解析やパーサー変更時のポイント消費ルールは、ユーザーマニュアルの [使用量の計算:各パーサーの課金単位](https://docs.maiagent.ai/others/usage#parser-billing-units) をご覧ください。照合時には、各解析料金が組織の Credits の 消費履歴 に以下の説明で記録されます(エクスポートした CSV の「説明」列です。検索 にファイル名を入力して調べることもできます)。
| パーサー | 消費履歴の説明 |
| ------------------------- | ------------------------------------------------------------ |
| MaiAgent Parser | `Document parsing (maiagent): ファイル名` |
| MaiAgent Parser (Offline) | `Document parsing (docling): ファイル名` |
| Vision Parser | `Vision parsing input: ファイル名`、`Vision parsing output: ファイル名` |
{% hint style="warning" %}
文書一覧でパーサーを変更すると(パーサーの一括変更 を含む)、確認画面なしで直ちに再解析されます。解析コストを一定に保ち、他のパーサーへの自動切り替えを避けるには、アップロード時に MaiAgent Parser(または指定のパーサー)を直接選択し、自動検出(デフォルト) は使用しないでください。
{% endhint %}
#### 大きすぎる画像による解析の失敗
文書に埋め込まれた画像にはサイズ上限があり、超過した場合の挙動はパーサーによって 2 種類に分かれます。
* **Vision Parser** は、一辺が 8,000 px を超える、または総画素数(幅 × 高さ)が 4,000 万を超える埋め込み画像をスキップし、ページ全体の画像のみを認識します。文書全体の解析が失敗することはありません。スキップされた画像に重要な内容がある場合は、画像を縮小してから再アップロードしてください。
* **その他のパーサー**では、巨大な画像のデコード時に文書全体の解析が失敗する場合があります。文書一覧の 失敗理由 に `total decoded image size must be at most … pixels` などのメッセージが表示された場合、文書内の画像の総画素数が、そのパーサーのデコード上限を超えています。元の文書内の画像を縮小または圧縮して再アップロードしてください。スキャンファイルは Vision Parser に切り替え、テキストだけが必要な場合は画像なしの文書を別途保存してください。
{% hint style="info" %}
上限はファイルサイズではなく総画素数で計算されます。8,000 × 8,000 のスクリーンショット(6,400 万画素)は、小さな JPEG に圧縮しても上限を超えます。縮小時は長辺を 4,000 px 以内に収めると最も確実です。
{% endhint %}
***
## 音声文字起こしパーサー
音声ファイルをナレッジベースにアップロードすると、音声文字起こしパーサーが文字起こしテキストに変換し、その後にインデックスを作成します。MaiAgent クラウドでは現在、以下を提供しています。
| パーサー(管理画面の名称) | サービス | 言語設定 | カスタムプロンプト | 動画ファイルのアップロード |
| --------------- | ---------------------- | ------------------------------ | --------- | ------------- |
| Azure Speech | Azure 音声サービス | 最大 4 言語を指定できます | 不可 | 不可 |
| WhisperGroq | Groq(Whisper large-v3) | 1 言語を指定、または自動検出できます | 可 | 可 |
| WhisperOpenAI | OpenAI(Whisper) | 1 言語を指定、または自動検出できます | 可 | 可 |
| Bronci (長問語音辨識) | Bronci | 台湾語、台湾華語、客家語(四県、海陸)から 1 つ選択します | 不可 | 不可 |
音声文字起こしは音声の秒数に応じて課金され、再文字起こしのたびに料金が発生します。ユーザーマニュアルの [使用量の計算:各パーサーの課金単位](https://docs.maiagent.ai/others/usage#parser-billing-units) をご覧ください。消費履歴の説明は `Audio parsing (サービスコード): ファイル名` で、たとえば `Audio parsing (azure): ファイル名` と記録されます。
オンプレミス環境の音声文字起こしは、デプロイパッケージで設定されます。新規デプロイでは、デフォルトでローカルの LocalAI サービスを使用します(モデルは Qwen3-ASR または Whisper で、GPU が必要です)。既存の環境では Whisper (Offline) を引き続き使用できます。どちらもオンプレミスで実行され、音声がクラウドに送信されることはありません。
音声の解析が完了すると、ナレッジベースで文字起こしテキストを確認し、TXT(プレーンテキスト)または SRT(字幕形式)でダウンロードできます。
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://docs.maiagent.ai/tech/ja/quickstart/parser.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.