> For the complete documentation index, see [llms.txt](https://docs.maiagent.ai/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.maiagent.ai/tech/ja/platform-development/architecture.md).

# デプロイアーキテクチャ

MaiAgent のデプロイアーキテクチャ：一体型と分散型の違い、サービスコンポーネントとデータフロー、およびデプロイパッケージの Docker 単一ホスト／Docker 分散型／Kubernetes の 3 つのデプロイ形態。

MaiAgent は、さまざまな用途に対応する拡張可能な生成 AI プラットフォームです。多様な業務要件やリソース構成に対応するため、**一体型デプロイ**と**分散型デプロイ**の 2 つの主要なデプロイ方式を提供しています。

この章では、両アーキテクチャの違い、適した用途、それぞれのメリットとデメリットを説明し、実際のデプロイに役立つ情報を提供します。プライベートクラウドやオンプレミスにデプロイパッケージでインストールする場合、一体型は「Docker 単一ホスト」、分散型は「Docker 分散型」または「Kubernetes」に対応します。このページの最後にある[デプロイパッケージの 3 つのデプロイ形態](#deployment-types-in-practice)をご覧ください。

## 一体型デプロイ

### アーキテクチャの説明

一体型デプロイでは、MaiAgent のすべての主要コンポーネント（メインサービス、タスクスケジューリングサービス、データストレージ、データベース、フロントエンドサービスなど）を同じサーバーにインストールして実行します。**一元管理**と簡単なデプロイが特長で、迅速な導入やテスト環境に適しています。

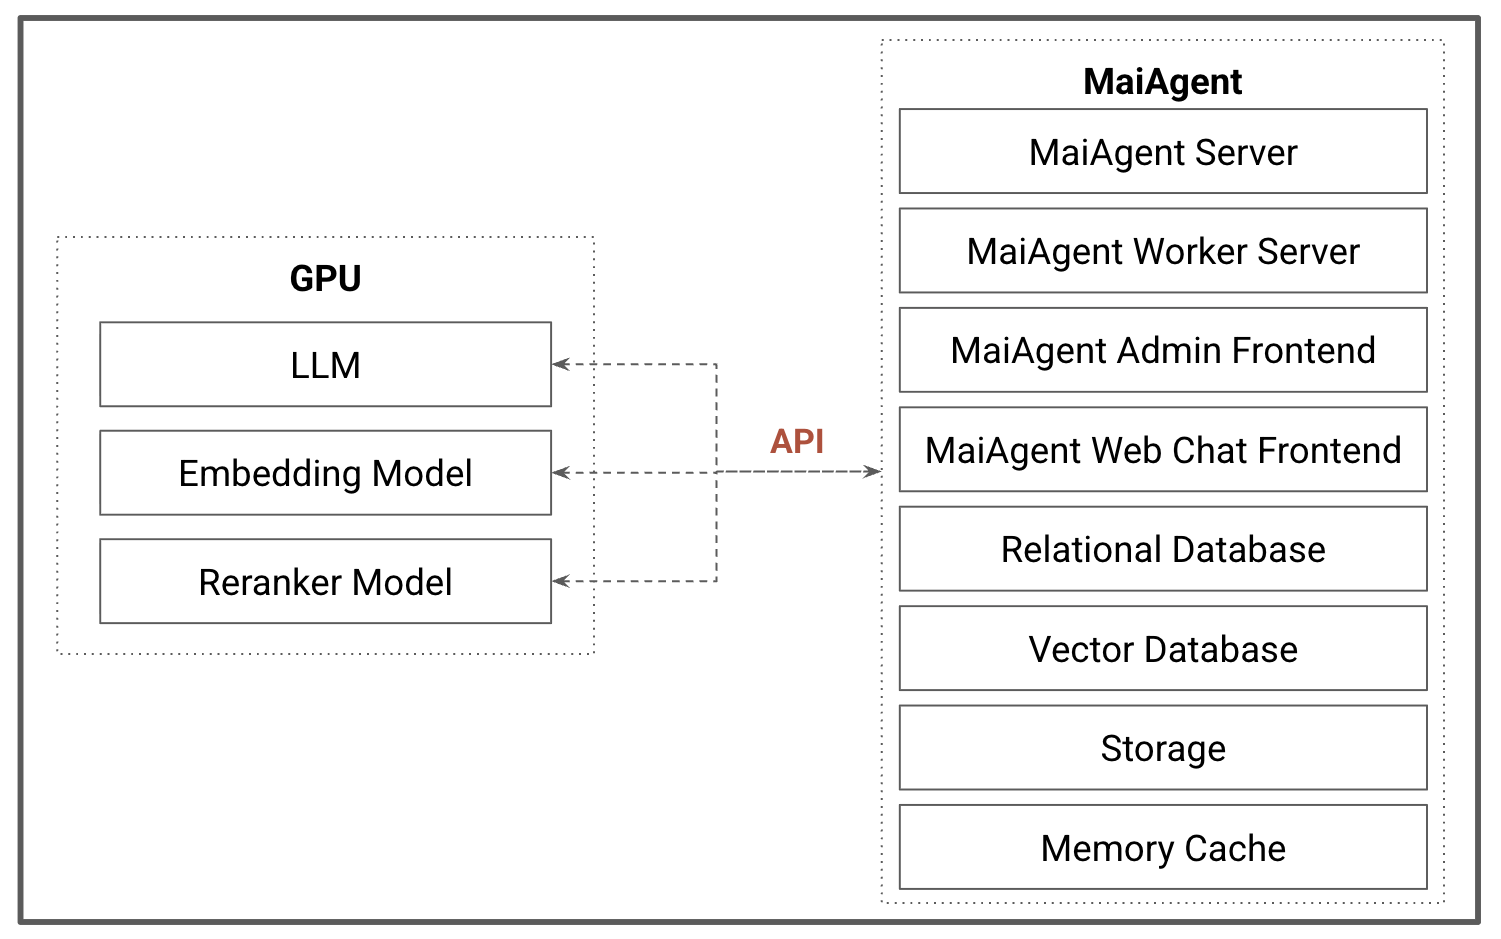
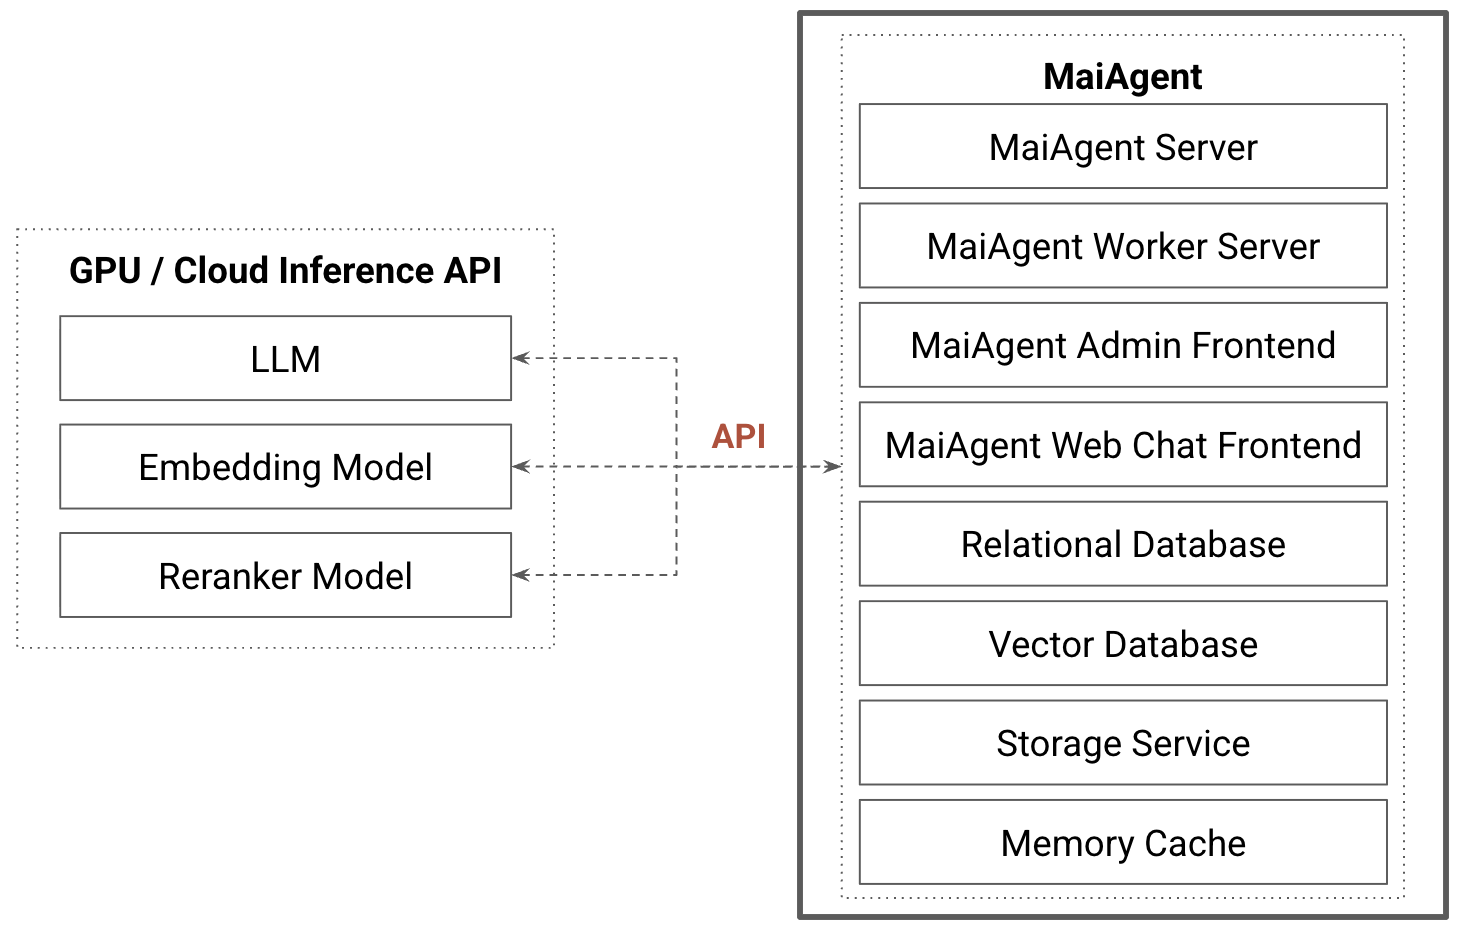
MaiAgent プラットフォームは GPU なしでも動作し、一般的な CPU 環境でスムーズにデプロイして実行できます。GPU リソースを備えたマシンでは、プラットフォームとモデルを同じ環境にデプロイして、ハードウェアアクセラレーションを十分に活用することもできます。以下に、よく使われる 2 つの構成図を示します。

### 構成図

1. GPU を搭載したサーバーへのデプロイ：

MaiAgent プラットフォームとモデルサービスを同じマシンにインストールします。プラットフォームは内部 API を通じてリクエストの調整とトラフィック制御を担当し、モデルは GPU を利用して効率的な推論を提供します。プラットフォームとモデルサービスを同じ場所に配置すれば、プラットフォーム専用の一般サーバーを追加購入する必要がなくなり、ハードウェア全体の費用を抑えられます。

<figure><img src="https://605688223-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FVYMUz6J7vDZ0QTvb1rbN%2Fuploads%2Fgit-blob-c44f0012dfa26a57f94b3502599ef95e0449b82b%2F%E6%88%AA%E5%9C%96%202025-09-07%20%E4%B8%8A%E5%8D%8810.45.02.png?alt=media" alt=""><figcaption></figcaption></figure>

2. GPU を搭載していないサーバーへのデプロイ：

MaiAgent を GPU のないサーバーにデプロイする場合もモデルサービスは必要なため、API を通じて GPU サーバーまたはクラウドの API 推論サービスに接続します。プラットフォームとモデルサービスを分離すると、それぞれを独立して拡張でき、必要に応じて計算リソースを増減できるため、柔軟性と保守性が向上します。

<figure><img src="https://605688223-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FVYMUz6J7vDZ0QTvb1rbN%2Fuploads%2Fgit-blob-ae088ec75c4ed0ad2b74d027af6f5afdae86dff2%2F%E6%88%AA%E5%9C%96%202025-09-07%20%E4%B8%8A%E5%8D%8811.35.32.png?alt=media" alt=""><figcaption></figcaption></figure>

## 分散型デプロイ

### アーキテクチャの説明

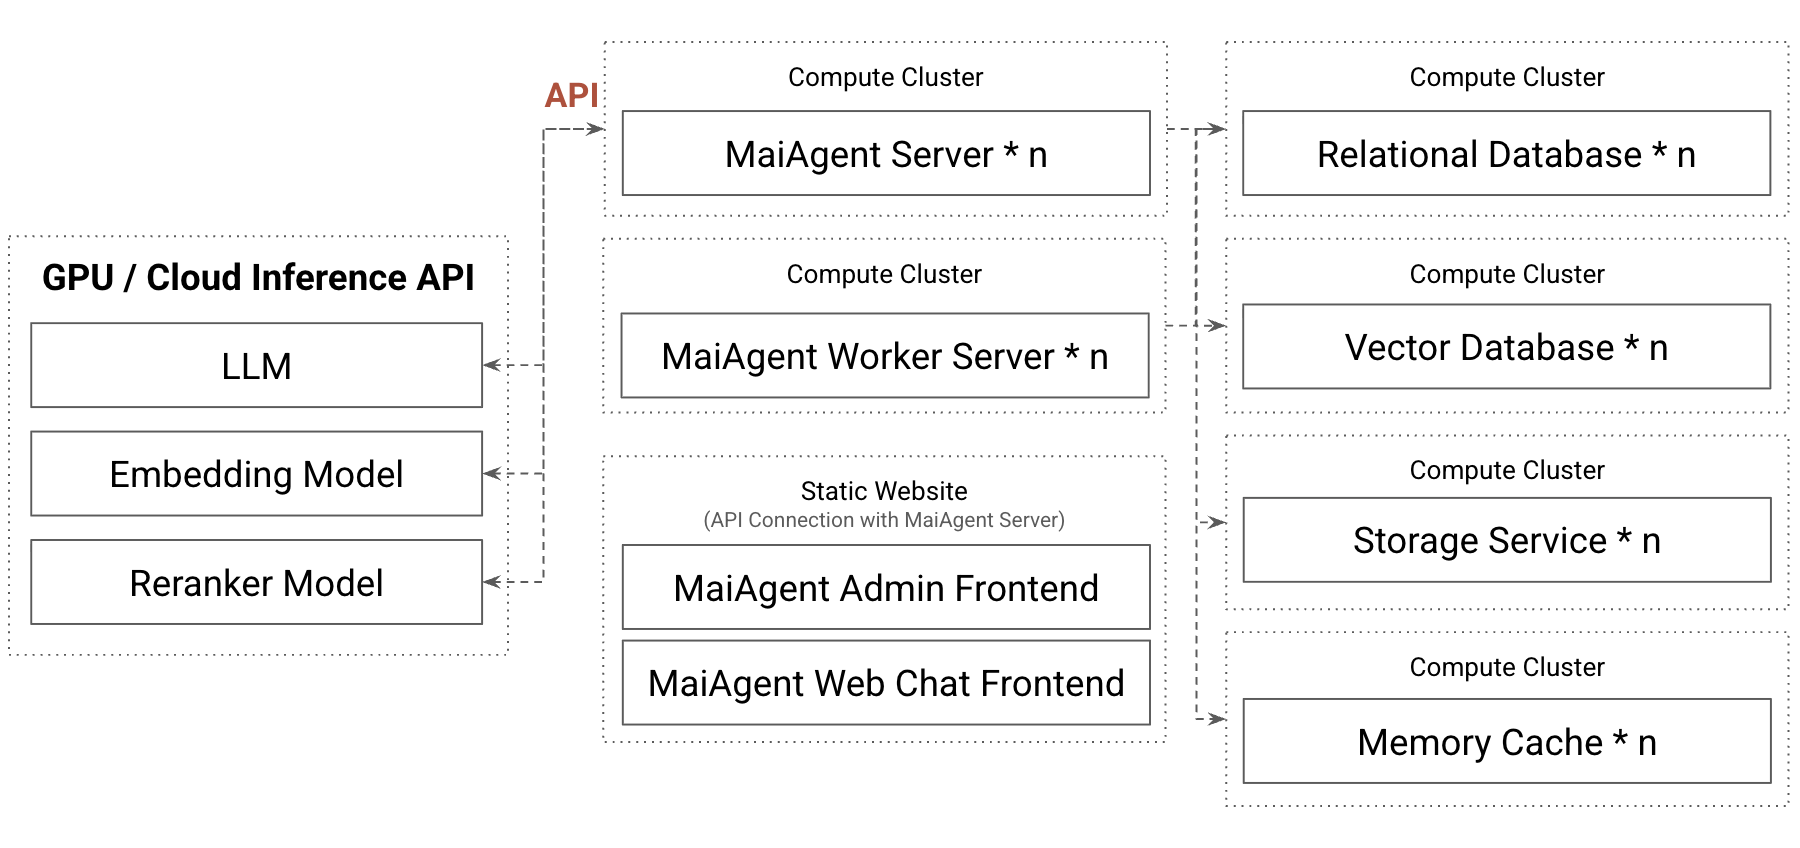
分散型デプロイでは、MaiAgent の主要モジュールを独立したサービスに分割し、複数のサーバーに配置します。各モジュールは必要に応じて水平スケーリングでき、高可用性と大規模な処理能力を実現します。

* **クラウドプラットフォーム（Cloud PaaS）環境**\
  パブリッククラウドやプライベートクラウドでは、Kubernetes（お客様の既存クラスターを含みます）、AWS ECS、GCP Cloud Run、Azure Container Apps などの Platform as a Service（PaaS）の機能を直接利用できます。これらのサービスはコンテナオーケストレーション、負荷分散、自動スケーリング（auto-scaling）、監視機能を提供し、分散モジュールの迅速なデプロイと動的なリソース調整を可能にして、インフラの運用負担を軽減します。
* **オンプレミス（On-Premise VM）環境**\
  オンプレミスの VM 環境でも、仮想マシンやベアメタルサーバー上にコンテナプラットフォームやアプリケーションサービスのフレームワークを構築すれば、クラウドと同様の分散管理と拡張性を実現できます。クラスターリソース、監視、冗長化の仕組みは自分で計画する必要がありますが、高可用性と柔軟なスケーリングを実現できます。

### 構成図

<figure><img src="https://605688223-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FVYMUz6J7vDZ0QTvb1rbN%2Fuploads%2Fgit-blob-b75d99c8b7d76847ec9ff2bd2c967640c156f6b3%2F%E6%88%AA%E5%9C%96%202025-09-07%20%E4%B8%8A%E5%8D%8811.28.15.png?alt=media" alt=""><figcaption></figcaption></figure>

## デプロイ方式の比較表

<table><thead><tr><th width="133.58203125">特性</th><th>一体型デプロイ</th><th>分散型デプロイ</th></tr></thead><tbody><tr><td><strong>アーキテクチャ設計</strong></td><td>すべてのコンポーネントを単一のサーバー／コンテナに集約します</td><td>各コンポーネントを独立したサービスに分割し、複数のノードに配置します</td></tr><tr><td><strong>インフラ費用</strong></td><td>低く、サーバー 1 台で対応できます</td><td>高く、複数のサーバーやクラウドリソースが必要です</td></tr><tr><td><strong>デプロイ費用</strong></td><td>低いです</td><td>高く、デプロイが複雑で DevOps チームが必要です</td></tr><tr><td><strong>保守費用</strong></td><td>低く、一元管理できます</td><td>高く、サーバーやサービスをまたいだ保守と監視が必要です</td></tr><tr><td><strong>拡張性</strong></td><td>なく、単一マシンのリソースに制限されます</td><td>あり、ボトルネックとなるモジュールを独立して拡張できます</td></tr><tr><td><strong>高可用性</strong></td><td>なく、単一障害点によってシステム全体が停止します</td><td>あり、単一サービスの障害はシステム全体に影響しません</td></tr><tr><td><strong>適した用途</strong></td><td>PoC、開発・テスト、小規模なアプリケーション</td><td>本番運用、大規模なアプリケーション、複数部門での利用</td></tr></tbody></table>

## サービスコンポーネントとデータフロー <a href="#components-and-data-flow" id="components-and-data-flow"></a>

上の構成図には主要なサービス種別のみを示しています。デプロイパッケージでインストールする場合、実際にデプロイされるコンポーネントと接続関係は以下のとおりです（Docker デプロイの例）：

```mermaid
flowchart LR
    User["ユーザーのブラウザー"] --> Proxy["リバースプロキシ Nginx"]
    Proxy --> Admin["管理画面フロントエンド"]
    Proxy --> WebChat["チャットページフロントエンド"]
    Proxy --> API["MaiAgent Server（Django API）"]
    Proxy --> Storage[("オブジェクトストレージ Garage または MinIO")]
    API --> Broker["メッセージキュー RabbitMQ"]
    Beat["スケジューラー Celery Beat"] --> Broker
    Broker --> Worker["Worker（通常、低優先度）"]
    API --> PgBouncer["接続プール PgBouncer"]
    Worker --> PgBouncer
    PgBouncer --> PG[("PostgreSQL")]
    API --> Redis[("Redis キャッシュ")]
    API --> ES[("Elasticsearch")]
    Worker --> ES
    API --> Storage
    Worker --> Storage
    API --> Models["モデルサービス LLM、Embedding、Reranker"]
    Worker --> Models
```

* **メッセージキュー（RabbitMQ）**：MaiAgent Server とスケジューラーがバックグラウンドタスクをキューに入れ、Worker が取り出して処理します。通常の Worker はメッセージのストリーミング出力などを処理し、低優先度の Worker はドキュメントのベクトル化など時間のかかる処理を担当します。
* **スケジューラー（Celery Beat）**：定期タスクを起動します。実行するインスタンスは常に 1 つです。
* **接続プール（PgBouncer）**：MaiAgent Server と Worker は、この接続プールを経由して PostgreSQL に接続します。
* **リバースプロキシ**：外部向けの HTTPS 入口です。ブラウザーでファイルをアップロード／ダウンロードする際は、リバースプロキシを経由してオブジェクトストレージに直接アクセスします（IP とポート番号で接続する場合はポート 9000）。Kubernetes デプロイでは Traefik または Cilium Gateway がこの役割を担い、サービス間はクラスター内部のアドレスで接続します。
* **モデルサービス**：ホスト上の vLLM、お客様の既存の OpenAI 互換サービス、またはクラウドモデルを利用できます。[オンプレミスのモデルサービス接続](/tech/ja/platform-development/onprem-model-services.md)をご覧ください。
* **データの保存先**：リレーショナルデータ（組織、Agent、会話、設定）は PostgreSQL、ナレッジベースやメモリ機能のベクトルとパッセージは Elasticsearch（ナレッジベースは[独自のベクトルデータベース](/tech/ja/platform-development/bring-your-own-vector-db.md)に変更できます）、アップロードされたファイルはオブジェクトストレージに保存します。Redis は API キャッシュと一時保存にのみ使用します。MaiAgent Server と Worker は各プロバイダーの SDK でモデルサービスを直接呼び出し、アーキテクチャ内に独立したモデルゲートウェイサービスはありません。モデル呼び出しを一元管理したい企業は、プラットフォームの [AI Gateway](/tech/ja/ai-gateway/ai-gateway-openai-compatible.md) 機能を利用できます。

各コンポーネントと AWS、GCP、デプロイパッケージの対応については[概要](/tech/ja/platform-development/gai-lan.md)をご覧ください。

## 分散型デプロイの高可用性とトラフィック経路 <a href="#ha-and-traffic-paths" id="ha-and-traffic-paths"></a>

デプロイパッケージの 3 つのデプロイ形態では、実現できる高可用性の水準が異なります：

|                | Docker 単一ホスト                                                                                   | Docker 分散型                                        | Kubernetes                                                                                                                                            |
| -------------- | ---------------------------------------------------------------------------------------------- | ------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------------------------------------- |
| 入口             | Nginx リバースプロキシ（ホスト上）                                                                           | Nginx（デプロイホスト上）                                   | Traefik または Cilium Gateway。複数ノードの場合は前段にロードバランサーを配置します                                                                                                 |
| アプリケーション層のレプリカ | API コンテナを複数に増やせます（Nginx が複数の API コンテナに自動で負荷を分散します）。通常の Worker はデフォルトで 2 つ、低優先度の Worker は 1 つです | 左と同じですが、サービスの種別ごとに別のホストに配置します                     | API はデフォルトで 2 レプリカ、通常の Worker は 2 つ、低優先度の Worker は 1 つです。スケジューラーは常に 1 つです                                                                             |
| データ層           | 単一インスタンスです                                                                                     | 単一インスタンスで、データホストに集約します                            | PostgreSQL、Redis、Elasticsearch、オブジェクトストレージが各 1 インスタンスです。データは Longhorn のレプリケーションストレージに保存します（複数ノードではデフォルトで 3 コピー）。ノード障害時はクラスターがデータサービスを別のノードに再スケジュールします |
| コントロールプレーン     | —                                                                                              | —                                                 | コントロールノードが 3 台の場合、VIP で高可用性を確保します（kube-vip、keepalived、またはお客様の既存の外部ロードバランサー）                                                                           |
| 単一ノードの障害       | システム全体が停止します                                                                                   | そのホストのサービスが停止します（例えばデータホストの障害ではシステム全体が利用できなくなります） | アプリケーション層は自動でレプリカを補充します。データ層の再スケジュール中は短時間の中断が発生します                                                                                                    |

**Kubernetes の外部向け入口**は、デプロイ設定のネットワーク環境に応じて次の 4 つから選択します：

| ネットワーク環境        | トラフィック経路                                                            | お客様が準備するもの                                |
| --------------- | ------------------------------------------------------------------- | ----------------------------------------- |
| クラウドロードバランサー    | DNS → クラウド ALB／NLB（またはお客様独自の Nginx リバースプロキシ）→ ノード → Ingress コントローラー | ロードバランサーとそのヘルスチェック、DNS                    |
| Cloudflare プロキシ | DNS → Cloudflare → ノードの 80／443 → Ingress コントローラー                    | Cloudflare 設定、DNS                         |
| オンプレミスの負荷分散     | DNS → Cilium が L2 または BGP で通知するサービス IP → Ingress コントローラー            | プラットフォーム用に予約した IP 範囲（既存アドレスとの競合を避けます）、DNS |
| 単一ホストへの直接接続     | DNS → ノードの 80／443 → Ingress コントローラー                                 | DNS                                       |

**計画時の注意事項**

* プラットフォームの API はストリーミング応答（SSE）と WebSocket 接続の両方を提供します。ロードバランサーとリバースプロキシでは長時間接続と WebSocket アップグレードを許可してください。アイドルタイムアウトを短くしすぎると、ストリーミング応答が途中で切断されます。
* Kubernetes は「サービスごとに 1 つのドメイン」のみをサポートします。お客様の DNS（オフライン環境では内部 DNS）にドメインを設定してください。証明書については[運用のポイント：ドメインと TLS 証明書](/tech/ja/platform-development/onprem-operations.md#tls-and-domain)をご覧ください。
* 必要な VIP、サービス IP 範囲、DNS 名、ファイアウォールルール、サブネットは、お客様のネットワークチームが決定し、「デプロイ設定確認表」に記入してください。ポートについては[システム要件：ポート](/tech/ja/platform-development/system-requirements.md#ports)をご覧ください。
* データセンターや可用性ゾーンをまたぐアクティブ・アクティブ構成、データベースの複数レプリカ、自動フェイルオーバーはデプロイパッケージの範囲外です。必要な場合は MaiAgent に評価をご依頼ください。
* プラットフォームはモデルサービスの高可用性を提供しません。ホスト上の vLLM が停止すると、そのモデルを使う会話はサービスが復旧するまで失敗します。

## デプロイパッケージの 3 つのデプロイ形態 <a href="#deployment-types-in-practice" id="deployment-types-in-practice"></a>

プライベートクラウドやオンプレミスにデプロイパッケージでインストールする場合、上記の 2 つのデプロイ方式は次のように実装します：

| デプロイ方式 | デプロイパッケージの形態 | 実装の概要                                                                                                               |
| ------ | ------------ | ------------------------------------------------------------------------------------------------------------------- |
| 一体型    | Docker 単一ホスト | すべてのサービスを同じホストにインストールします。400 人未満の本番環境で利用できます                                                                        |
| 分散型    | Docker 分散型   | 1 台のデプロイホストから SSH で複数のホストにサービスをインストールします。検証済みの構成は、アプリケーション、データ、バックグラウンド処理用の 3 台です                                   |
| 分散型    | Kubernetes   | インストーラーでクラスター（kubeadm、Cilium、Longhorn）を構築するか、Helm でお客様の既存クラスターにインストールします。デプロイ設定に応じて MaiAgent が生成する専用のデプロイパッケージが必要です |

形態の選び方、各形態の制限と機能の違いについては[デプロイ形態と機能の比較](/tech/ja/platform-development/onprem-deployment-types.md)、ホストの仕様については[システム要件](/tech/ja/platform-development/system-requirements.md)をご覧ください。


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://docs.maiagent.ai/tech/ja/platform-development/architecture.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.
