> For the complete documentation index, see [llms.txt](https://docs.maiagent.ai/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.maiagent.ai/tech/ja/api-integration/knowledge-base-api.md).
# ナレッジベースの利用—アップロード、検索、管理
API でナレッジベースにファイルをアップロードし、自然言語で内容を検索して関連チャンクを取得し、ナレッジベースのファイルを管理する方法を説明します。アップロード、解析完了の待機、検索の一連のサンプルも掲載しています。
## 概要
MaiAgent では、開発者が API を通じてナレッジベースのファイルを管理できます。ワークスペース内のナレッジベースで、次の操作を実行できます:
* ナレッジベースへの新しいファイルのアップロード
* ナレッジベース内の全ファイルの一覧取得
* 既存ファイルの情報の更新
* 単一ファイルの削除または一括削除
* ナレッジベースの内容の検索([ナレッジベースの検索](#search-knowledge-base)を参照)
{% hint style="info" %}
**📘 重要な注意事項**
すべての API 操作には、有効な API Key による認証が必要です。API Key に適切な権限があることを確認してください。
{% endhint %}
***
## ナレッジベースの操作
### ナレッジベースの作成
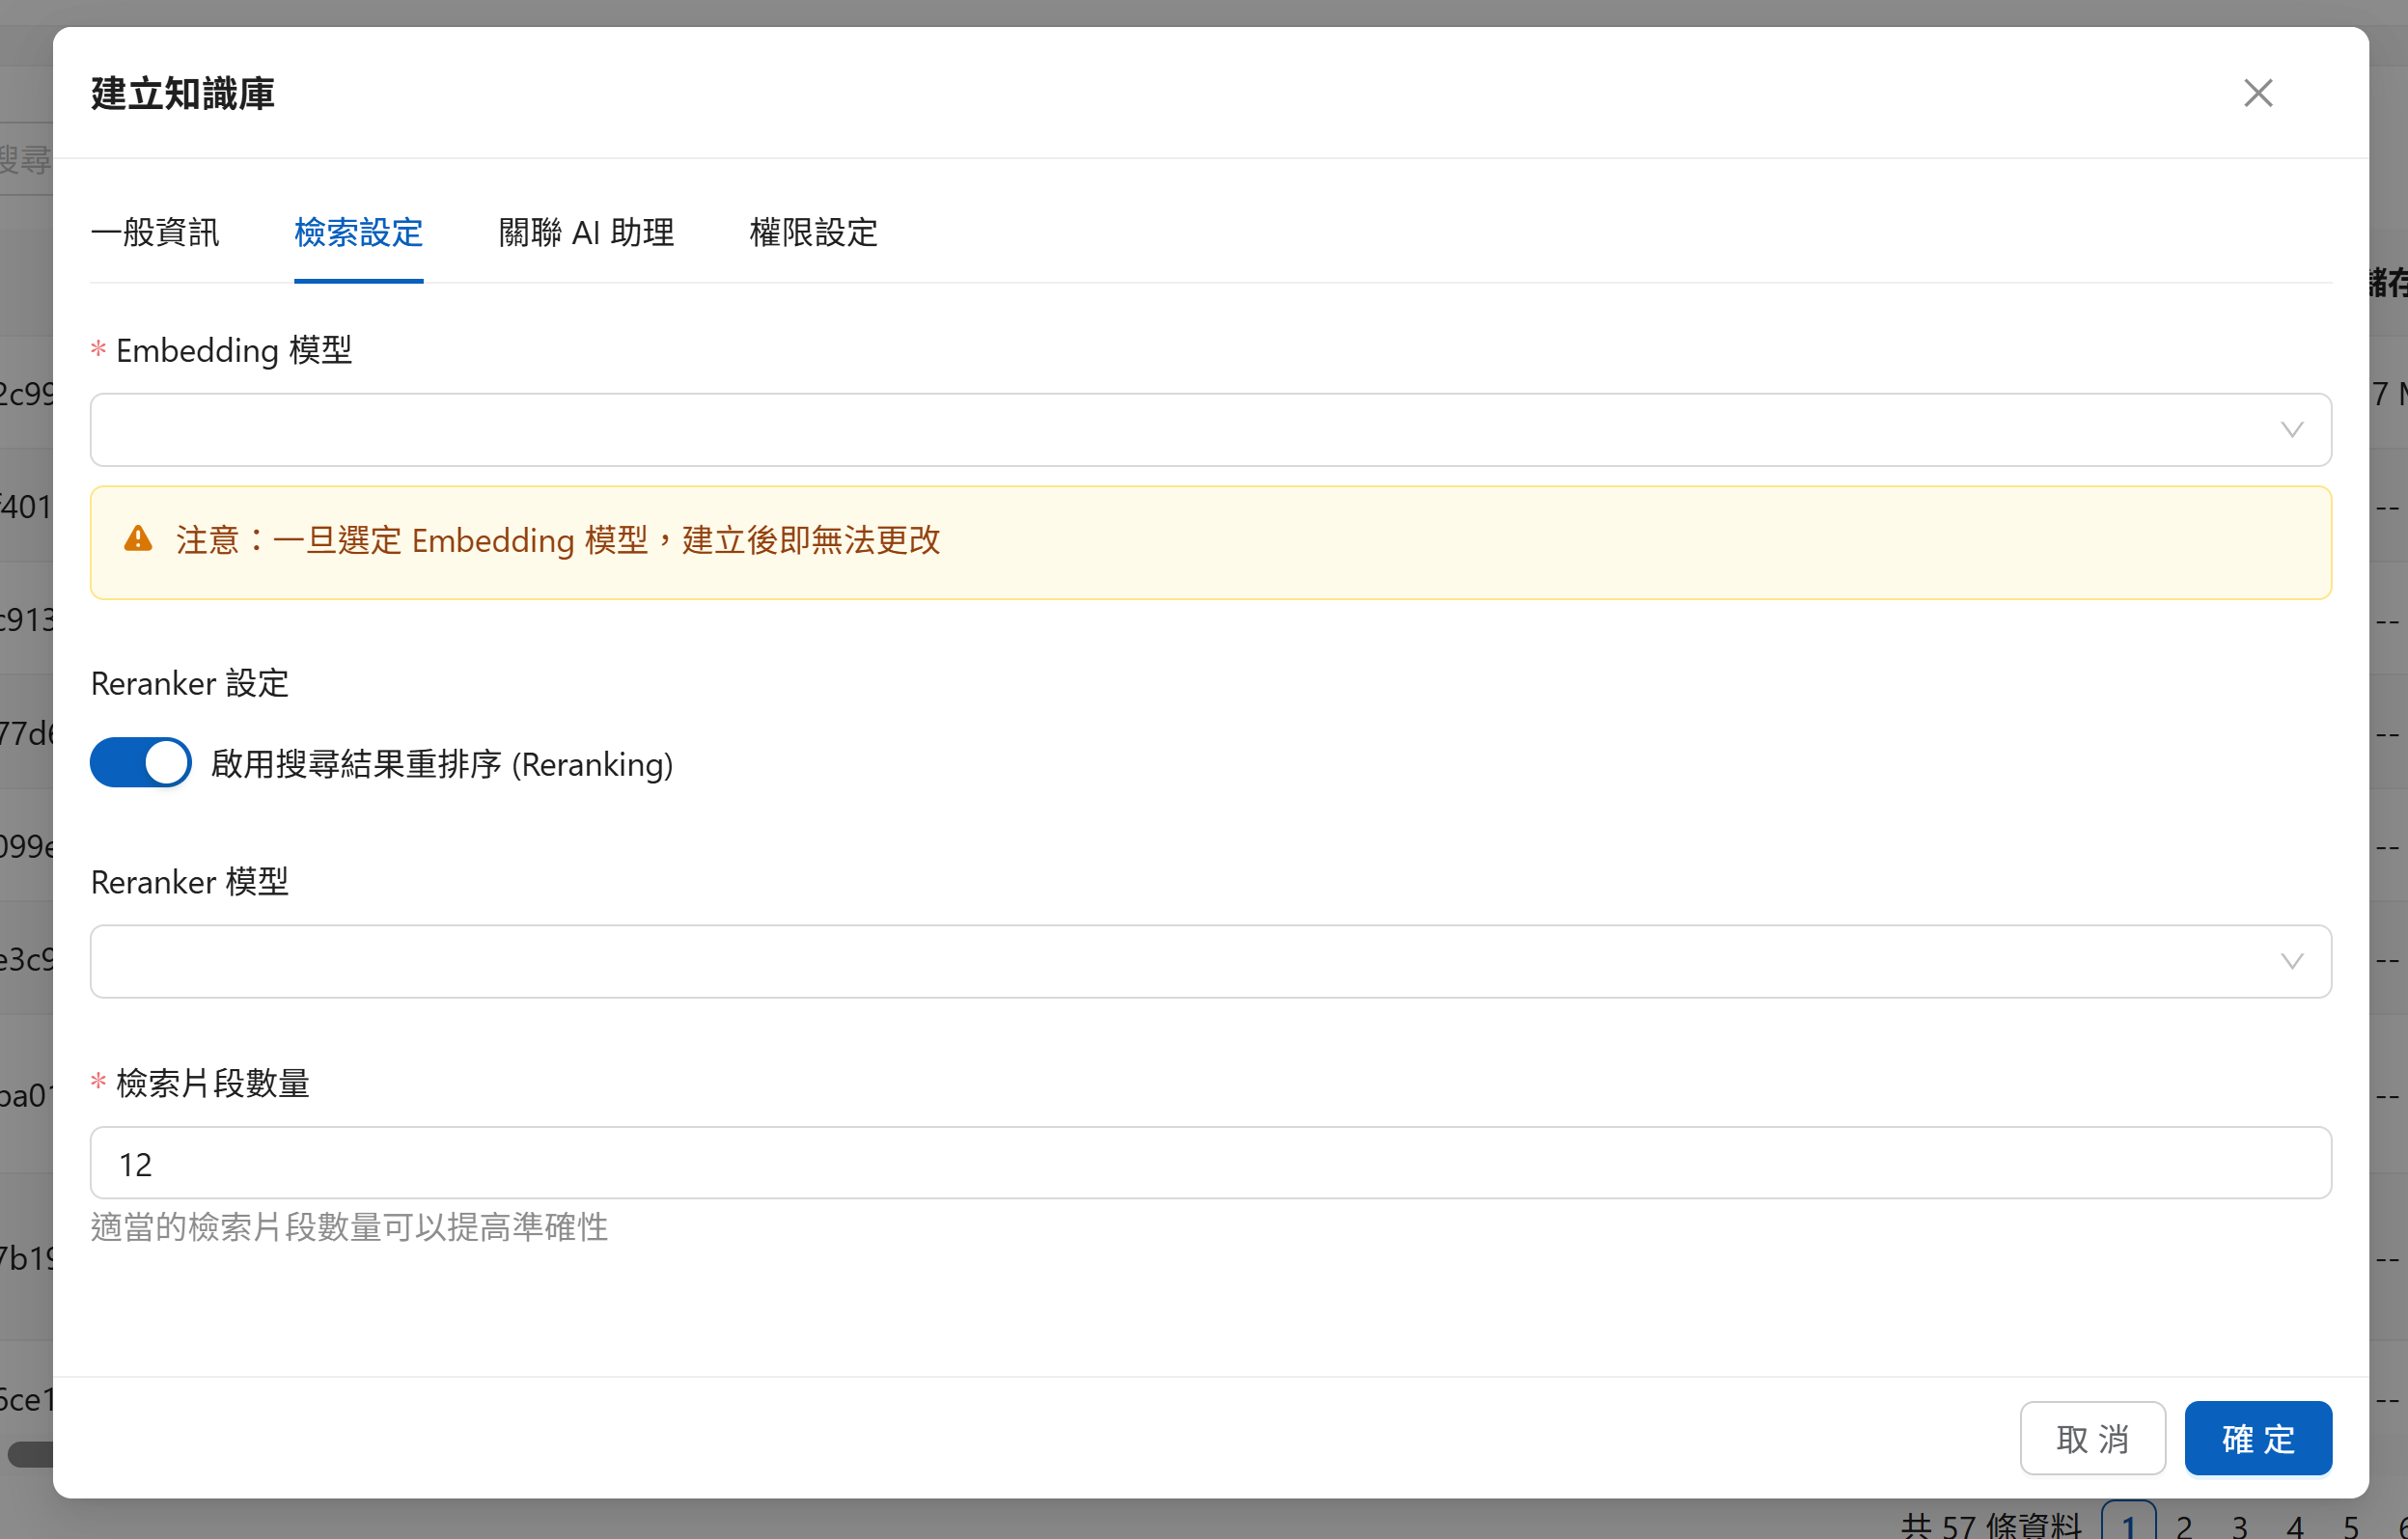 ナレッジベースを利用する前に、少なくとも**1 つ**作成する必要があります。作成時には、使用する Embedding Model、Reranker Model、ナレッジベース名、利用可能な Agent などの情報を指定します。
これらの設定はスクリプトで指定できます。エンドポイントは `POST /api/v1/knowledge-bases/` です。以下はナレッジベースを作成するリクエストの例です。`embeddingModel` と `rerankerModel` にはモデル ID を指定します。それぞれ `GET /api/v1/embedding-models/` と `GET /api/v1/reranker-models/` で確認できます。`numberOfRetrievedChunks` は取得するチャンク数です。
{% code overflow="wrap" %}
```json
{
"embeddingModel": "550e8400-e29b-41d4-a716-446655440000",
"rerankerModel": "550e8400-e29b-41d4-a716-446655440000",
"name": "社内研修マニュアル",
"description": "このナレッジベースは社内研修用です。ユーザーマニュアル、製品マニュアル、トラブルシューティングマニュアルを含み、新入社員の教育にのみ使用します",
"numberOfRetrievedChunks": 12,
"enableRerank": true,
"chatbots": [
{
"id": "550e8400-e29b-41d4-a716-446655440000"
}
],
"groups": [
{
"id": "550e8400-e29b-41d4-a716-446655440000"
}
]
}
```
{% endcode %}
`201` と新しいナレッジベースの内容(`id` を含む)が返されれば、作成は成功です。そのナレッジベースに対して操作を実行できます。
### ID を使った個別のナレッジベースの操作
個別のナレッジベースでファイルを管理する前に、そのナレッジベースの一意の識別子(`id`)を取得する必要があります。
{% hint style="warning" %}
ナレッジベースの ID はどのように取得しますか?
1. 作成したばかりのナレッジベースの `id` を取得します
スクリプトでナレッジベースを作成すると、作成完了後の HTTPS レスポンスに ID が含まれます。レスポンスの `id` が、そのナレッジベースの `id` の値です。
2. ほかの既存のナレッジベースの `id` を取得します
すべてのナレッジベースを取得したレスポンスから、必要なナレッジベースの `id` を確認できます。API ドキュメントの[ナレッジベース(新版)](https://docs.maiagent.ai/api/api-reference/zhi-shi-ku-xin-ban#knowledge-bases-list)を参照してください。
{% endhint %}
### ナレッジベースのファイルの一覧取得
`GET /api/v1/knowledge-bases/{knowledgeBasePk}/files/` はナレッジベース内のファイルを一覧表示します。`fileType`(`pdf`、`docx`、`txt`、`xlsx` など)、`status`、`query`(キーワード)で絞り込めます。ファイルの `status` が `done` の場合にのみ、解析が完了し、Agent による検索が可能になります。クエリパラメータとレスポンスフィールドは、API ドキュメントの[ナレッジベース内のファイル一覧取得](https://docs.maiagent.ai/api/api-reference/zhi-shi-ku-xin-ban#knowledge-bases-files-list)を参照してください。
レスポンスに含まれるサイズ関連の 3 つのフィールドは、それぞれ意味が異なります。`size` はアップロードしたファイル本体のサイズ(バイト)、`vectorStorageSize` はそのファイルがベクトルインデックス内で占める容量(バイト)、`chunksCount` は解析後に分割されたチャンク数です。ナレッジベースの容量計算には `size`、ベクトルストレージの見積もりには `vectorStorageSize` を使用します。
#### 例:すべての PDF ファイルの一覧取得
{% tabs %}
{% tab title="Shell/Bash" %}
{% code overflow="wrap" %}
```bash
# API 呼び出しの例(Shell)
curl -X GET "https://api.maiagent.ai/api/v1/knowledge-bases/550e8400-e29b-41d4-a716-446655440000/files/?fileType=pdf&page=1&pageSize=20" \
-H "Authorization: Api-Key YOUR_API_KEY"
# 実行前に YOUR_API_KEY を置き換え、リクエストデータを確認してください。
```
{% endcode %}
{% endtab %}
{% endtabs %}
***
## ファイルの操作
### ナレッジベースへのファイルのアップロード
`POST /api/v1/knowledge-bases/{knowledgeBasePk}/files/` は、ストレージにアップロード済みのファイルを URL で指定したナレッジベースに登録し、解析を開始します。`file` には、[Presigned ファイルアップロード方式](/tech/ja/api-integration/api_knowledge.md)の Step 1 のレスポンスに含まれる `fields.key` を指定してください。外部 URL は指定できません。複数のファイルを一度に登録できますが、1 回のリクエストは 50 件以下を推奨します。フィールド(任意の `parser`、`labels`、`rawUserDefineMetadata` を含む)は、API ドキュメントの[ナレッジベースへのファイルのアップロード](https://docs.maiagent.ai/api/api-reference/zhi-shi-ku-xin-ban#knowledge-bases-files-create)を参照してください。
#### 例:単一ドキュメントのアップロード—製品マニュアル
{% code overflow="wrap" %}
```json
{
"files": [
{
"filename": "產品手冊.pdf",
"file": "media/chatbots/chatbot-file/86572e41-16ba-45dd-b049-28c69f77ffb0.pdf",
"parser": "3fa85f64-5717-4562-b3fc-2c963f66afa6",
"labels": [
{
"id": "3fa85f64-5717-4562-b3fc-2c963f66afa6"
}
]
}
]
}
```
{% endcode %}
レスポンスは、新しく作成されたファイルオブジェクトの配列です。システムが生成したファイル ID が含まれます。
#### 同名ファイルと重複登録
* **ファイル名は一意のキーではありません**:同じナレッジベースに同じ `filename` のファイルを再度 `POST` すると、別のドキュメントが作成されます(`201`)。上書きや競合エラーは発生せず、両方が検索対象になります。内容を更新するには、まず `GET …/files/?query=ファイル名` で古いファイルを探し、削除してからアップロードしてください。ラベルとメタデータのみを更新する場合は `PATCH` を使用できます。
* **同じ `fields.key` は 1 回しか登録できません**:ファイル ID はストレージにアップロードされたオブジェクト名から生成されます。同じ `fields.key` で再度 `POST` すると `400` が返され、`detail` は「This file has already been uploaded to the knowledge base」になります。再送時には Presigned Step 1 → 2 をやり直し、新しい `key` を取得してください。
* ファイル名の照合は、同じナレッジベース内でのみ意味を持ちます。異なるナレッジベースには同名のファイルを保存できます。
#### 例:複数ファイルの一括アップロード
同じリクエストで登録したファイルは、すべて URL で指定したナレッジベースに入ります。異なるナレッジベースに入れる場合は、それぞれに対して個別に呼び出してください。
{% code overflow="wrap" %}
```json
{
"files": [
{
"filename": "新人教育手冊.pdf",
"file": "media/chatbots/chatbot-file/0b6f3c2e-6a51-4f43-9d3f-6e2f1c9a7b10.pdf"
},
{
"filename": "D256 產品說明文件.pdf",
"file": "media/chatbots/chatbot-file/5d1f2a7c-3b8e-4c19-9a62-1e4b7f0c8d35.pdf"
}
]
}
```
{% endcode %}
{% hint style="danger" %}
注意:1 ファイルのサイズは 100MB を超えてはいけません。超えると正しく処理できず、HTTP でエラーメッセージが返されます。
{% endhint %}
### 既存ファイルの情報の更新
`PUT`/`PATCH /api/v1/knowledge-bases/{knowledgeBasePk}/files/{id}/` は、`labels` と `rawUserDefineMetadata` のみを更新します。ファイル名と内容は変わらず、再アップロードは不要です。指定しないフィールドは変更されません。`labels` に空の配列を指定するとラベルが消去されます。フィールドは、API ドキュメントの[ファイル情報の更新](https://docs.maiagent.ai/api/api-reference/zhi-shi-ku-xin-ban#knowledge-bases-files-update)を参照してください。
#### エンドポイント
```
PUT /api/v1/knowledge-bases/{knowledgeBasePk}/files/{id}/
```
**リクエスト例**
{% code overflow="wrap" %}
```json
{
"labels": [
{
"id": "550e8400-e29b-41d4-a716-446655440000"
}
],
"rawUserDefineMetadata": {
"editDate": "2025/10/30",
"version": "online"
}
}
```
{% endcode %}
### メタデータ(`rawUserDefineMetadata`)のルール
ファイルのアップロードや更新時の `rawUserDefineMetadata` は `{"フィールド名": 値}` 形式のオブジェクトです。フィールドはナレッジベースの「メタデータフィールド」に対応します(`GET`/`POST /api/v1/knowledge-bases/{knowledgeBasePk}/metadata-keys/`。フィールドには `keyName`、`isRequired`、`defaultValue`、`enabledForSearch` があります)。プラットフォームでは次のルールで処理します。
| ルール | 動作 |
| ------------------ | ---------------------------------------------------------------------------------------------------------------------------------------------------- |
| 未知のフィールド名 | 拒否されません。プラットフォームがそのナレッジベースに同名のカスタムフィールドを自動作成し、以降のファイルでも使用できます |
| 値の型 | すべて文字列として保存されます。オブジェクトと配列は JSON 文字列、ブール値は `true`/`false`、その他の型は文字列に変換されます。1000 文字を超える値は切り詰められ、エラーにはなりません |
| 更新範囲 | `PUT`/`PATCH` に `rawUserDefineMetadata` を含めると、**全体が置き換えられます**。指定していない既存フィールドはそのファイルから削除され、`{}` を指定するとすべて消去されます。1 フィールドだけ変更する場合も、ほかのフィールドを一緒に指定してください |
| `defaultValue` | フィールドにデフォルト値が設定されている場合、新しくアップロードしたファイルにその値が自動で設定されます |
| `isRequired` | 管理画面のフォーム検証にのみ影響します。API は必須フィールドが欠けていてもアップロードや更新を拒否しません |
| `enabledForSearch` | 有効な場合、このフィールドの値は検索されたチャンクとともにモデルへ送信され、Agent のファイル検索でも照合対象になります。無効な場合は管理画面にのみ表示され、検索には影響しません |
| システムフィールド | `url` と `crawl_` で始まるフィールドはクローラーが書き込みます。作成時にシステムフィールドとして設定され、モデルには送信されません |
### 一括再解析
`PATCH /api/v1/knowledge-bases/{knowledgeBasePk}/files/batch-reparse/` は、指定したファイルを指定した解析器で再解析します。リクエストボディは配列で、各要素が 1 つのファイルを表します。
```json
[
{"id": "<ファイル ID>", "parser": "<解析器 ID>"},
{"id": "<ファイル ID>", "parser": null}
]
```
* `id` は必須です。ファイルは URL で指定したナレッジベースに属している必要があります。
* `parser` に解析器 ID(`GET /api/v1/parsers/` で確認できます)を指定すると、その解析器を使用します。`null` を指定すると既存の解析器指定が解除され、再解析時は自動判定に戻ります。
* **`parser` キーのない要素はスキップされ**、再解析されません。元の解析器で再実行するには、その解析器 ID を明示的に指定してください。
* 空の配列 `[]` は `200` を返しますが、何も実行しません。**「すべて再解析」ではありません**。ナレッジベース全体を再解析するには、まず[ファイル一覧取得](#list-files)でファイル ID を取得し、分割して送信してください。
* 再解析できるのは、状態が `done`、`failed` のファイル、または処理中のままプラットフォームの停止判定のしきい値を超えたファイルのみです。それ以外の状態のファイルが含まれると、リクエスト全体が `400` を返します。再解析では解析器の使用量に応じて再度 Credits が差し引かれます。
### ファイルの削除
#### 単一ファイルの削除
`DELETE /api/v1/knowledge-bases/{knowledgeBasePk}/files/{id}/` は、ナレッジベースから単一ファイルを削除します。成功すると `204` が返され、以降 Agent はそのドキュメントを参照しなくなります。API ドキュメントの[ファイルの削除](https://docs.maiagent.ai/api/api-reference/zhi-shi-ku-xin-ban#knowledge-bases-files-destroy)を参照してください。
**例**
{% tabs %}
{% tab title="Shell/Bash" %}
```bash
# API 呼び出しの例(Shell)
curl -X DELETE "https://api.maiagent.ai/api/v1/knowledge-bases/550e8400-e29b-41d4-a716-446655440000/files/550e8400-e29b-41d4-a716-446655440000/" \
-H "Authorization: Api-Key YOUR_API_KEY"
# 実行前に YOUR_API_KEY を置き換え、リクエストデータを確認してください。
```
{% endtab %}
{% endtabs %}
#### ファイルの一括削除
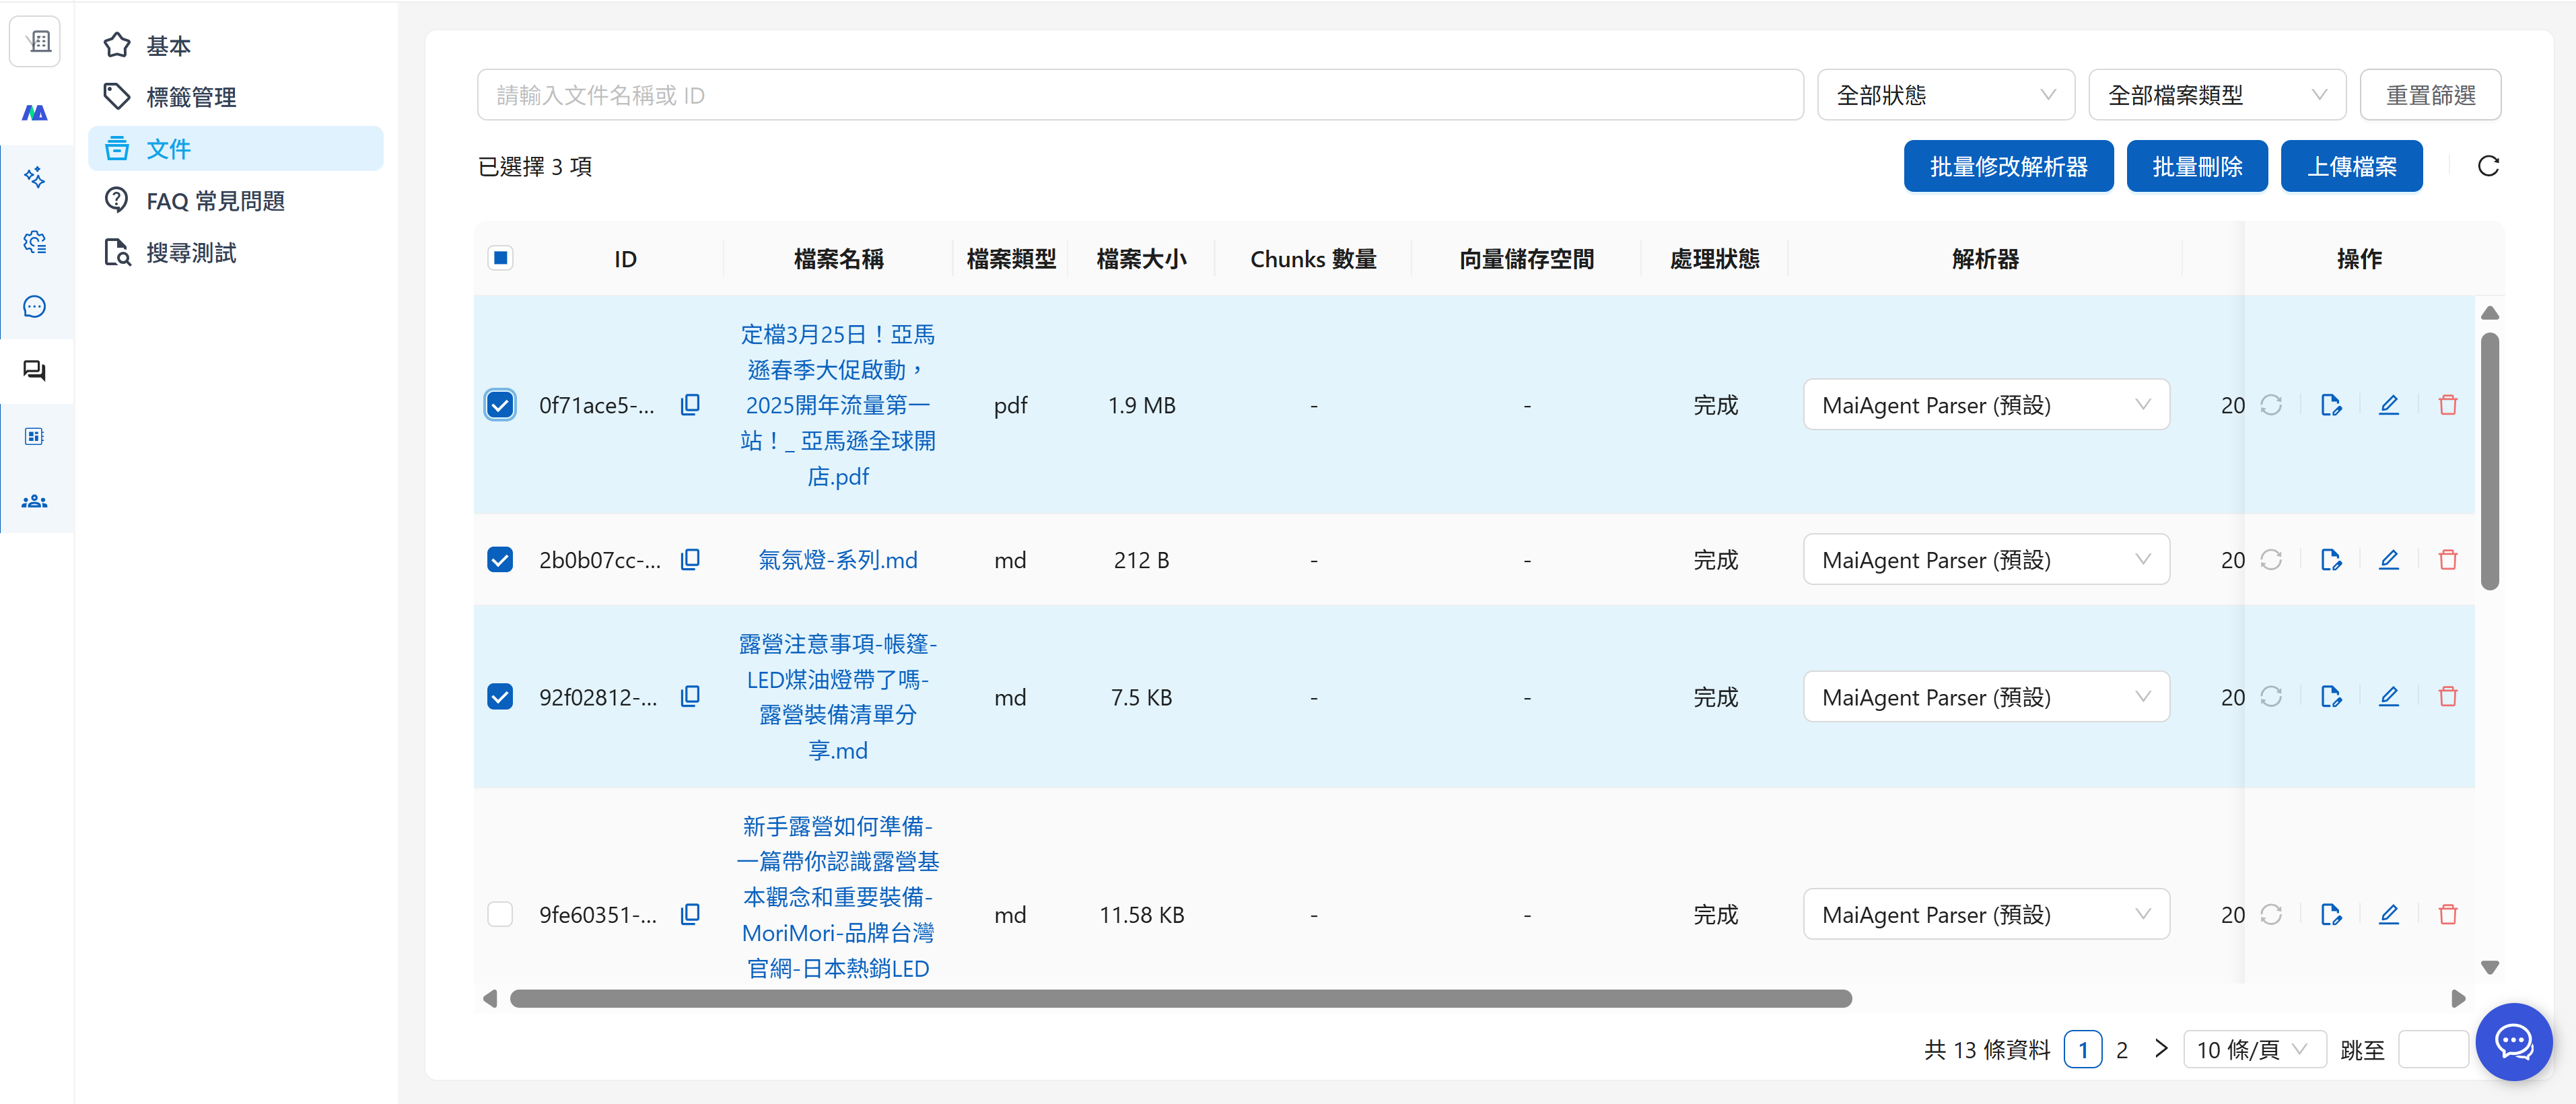 `POST /api/v1/knowledge-bases/{knowledgeBasePk}/files/batch-delete/` は、`ids` を使って同じナレッジベース内の複数ファイルを一度に削除します。異なるナレッジベースをまたいだ削除はできません。成功すると `200` が返されます。`queued` は削除キューに登録されたファイル ID、`skipped` は削除中のためスキップされたファイルです。API ドキュメントの[ファイルの一括削除](https://docs.maiagent.ai/api/api-reference/zhi-shi-ku-xin-ban#knowledge-bases-files-batch-delete-create)を参照してください。
リクエストの値の例
```json
{
"ids": [
"550e8400-e29b-41d4-a716-446655440000",
"550e8400-e29b-41d4-a716-446655449198",
"0b6f3c2e-6a51-4f43-9d3f-6e2f1c9a7b10"
]
}
```
#### 削除後の検索の整合性
| タイミング | 状態 |
| ------------------------------------------------------------------ | ------------------------------------------------------------------------------------------------------------------------------------------------- |
| `DELETE` が `204` を返した時点(または一括削除が `200` を返し、ファイルが `queued` に含まれる時点) | ファイルのチャンクと引用ノードは同期的に削除済みです。以降の[検索 API](#search-knowledge-base) と Agent の回答には、このファイルの内容は含まれません。待機やポーリングは不要です |
| その後のバックグラウンド処理 | ベクトルデータベース内のベクトルとストレージ内のファイル本体がバックグラウンドで削除されます。この間、ファイル一覧の `status` は `deleting`、削除に失敗すると `delete_failed`(再度削除できます)になる場合があります。どちらの状態のファイルも検索対象外です |
| `GET …/files/{id}/` | 削除後は `404` を返します |
| 過去の会話 | メッセージ本文は保持されます。このファイルを引用していた `citationNodes` はチャンクとともに削除されるため、過去のメッセージを再取得してもそのファイルの引用は表示されません。引用記録を残す場合は削除前にエクスポートしてください |
| 削除中の検索または削除リクエスト | 検索は通常どおり応答します(該当ファイルは含まれません)。一括削除では削除中のファイルが `skipped` に入り、単一ファイルの `DELETE` は引き続き `204` を返し、エラーにはなりません |
削除は元に戻せません。再アップロードすると、解析とベクトル化の料金が再度発生します。
***
## ナレッジベースの検索
テキストで単一のナレッジベースに問い合わせ、最も関連性の高いチャンクを取得します。検索は Agent との会話時と同じ方式で、ナレッジベースに設定された Embedding モデル、Reranker、取得チャンク数、類似度のしきい値に従って実行されます。処理の流れは [RAG ナレッジベース検索システム](/tech/ja/quickstart/rag.md#retrieval-flow)を参照してください。
### エンドポイント
`POST /api/v1/knowledge-bases/{id}/search/` の `{id}` はナレッジベース ID です。API Key に紐づくメンバーが、このナレッジベースにアクセスできる必要があります。API ドキュメントの[特定のナレッジベースの内容の検索](https://docs.maiagent.ai/api/api-reference/zhi-shi-ku-xin-ban#knowledge-bases-search-create)を参照してください。
### リクエストフィールド
検索テキストは、リクエストボディの必須フィールド `query` に指定します。`searchMode` は `hybrid`(デフォルト。プラットフォームでハイブリッド検索が無効の場合、自動的に `semantic` に切り替わります)、`semantic`、`keyword`(Elasticsearch のみ)から選択できます。範囲を限定する場合は、[Query Metadata](/tech/ja/identity-and-access/zhi-shi-guan-li-quan-xian-query-metadata-cha-xun-yuan-zi-liao-zong-lan.md) と同じ形式の `queryMetadata` を指定します。ただし、`knowledgeBases` は 1 件のみとし、`knowledgeBaseId` は URL のナレッジベース ID と一致させる必要があります。省略するとナレッジベース全体を検索します。
例:2 つのファイル内だけを検索します。
```json
{
"query": "返品期限は何日ですか?",
"searchMode": "hybrid",
"queryMetadata": {
"knowledgeBases": [
{
"knowledgeBaseId": "57a5630e-ed2f-42f4-aff1-d1edc241ceb6",
"chatbotFileIds": ["<ファイル ID 1>", "<ファイル ID 2>"],
"hasUserSelectedAll": false
}
]
}
}
```
### レスポンスフィールド
レスポンスはチャンクオブジェクトの配列(ページ分割なし)で、関連性の高い順に並びます。件数の上限は、ナレッジベースの取得チャンク数です。レスポンスに類似度スコアは**含まれない**ため、配列の順序で関連性を判断してください。FAQ 由来のチャンクでは、`filename` は `FAQ`、`chatbotFile` は `null` になります。各フィールドは、API ドキュメントの[特定のナレッジベースの内容の検索](https://docs.maiagent.ai/api/api-reference/zhi-shi-ku-xin-ban#knowledge-bases-search-create)を参照してください。
### エラーと課金
| ステータスコード | 状況 |
| ----------- | ------------------------------------------------------------------------------------------------------------------------------------- |
| `400` | `queryMetadata` の形式が不正、またはナレッジベース ID が一致しません。ベクトルデータベースが `keyword` モードをサポートしていません。検索に失敗しました(`Search failed. Please try again later.`) |
| `402` | 組織の Credits またはメンバーの利用枠が不足しています |
| `403`/`404` | キーに紐づくメンバーにこのナレッジベースへのアクセス権がないか、ナレッジベースが存在しません |
検索のたびに、使用した Embedding と Reranker の使用量に応じて Credits が差し引かれます。Agent との会話時の検索と同じです。
***
## トラブルシューティング
ファイルのエンドポイントは、すべて `/knowledge-bases/{knowledgeBasePk}/files/…` 配下にあります。権限はまず URL 内のナレッジベース、次にファイルに対して確認されます。次の表で原因を確認してください。
| ステータスコード | よくある原因 | 確認方法と対処 |
| -------- | ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | -------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| `401` | キーが無効または無効化されています。あるいは `Authorization` ヘッダーの形式が `Api-Key <キー>` ではありません | `GET /api/v1/knowledge-bases/` でキーをテストしてください。[API 共通規約:認証](/tech/ja/api-integration/api-conventions.md#authentication)を参照してください |
| `403` | キーに紐づくメンバーが、このナレッジベースの所属組織にいません(ID の入力ミスで別の組織のナレッジベースを指定した場合も含みます)。または、メンバーのロールにこのナレッジベースへのアクセス権がありません。書き込み操作(アップロード、更新、再解析)にはロールの「更新」権限、削除には「削除」権限が必要です。権限不足の場合、`detail` に update または delete が明記されます | まず `GET /api/v1/knowledge-bases/` で一覧にこの ID があることを確認してください。一覧にはあるのに書き込みが `403` になる場合は、組織のオーナーにロール設定でこのナレッジベースの更新/削除権限を有効にしてもらうか、オーナーのキーを使用してください |
| `404` | ナレッジベースが削除済み、または削除中です。ファイル `{id}` が URL 内のナレッジベースに属していません(別のナレッジベースにある、削除済み、またはナレッジベースのファイルではなく会話の添付ファイルです) | 正しいナレッジベースで `GET …/files/?query=ファイル名` を使い、ファイル ID を探してください。別のナレッジベースへ移動しても ID は変わりませんが、所属するナレッジベースは変わるため、URL を変更してください |
| `400` | `file` が Presigned の `fields.key` ではありません。同じ `key` を重複登録しています。拡張子に対応する解析器がありません(`detail`:「解析に対応していないファイル形式」)。`fileSize` がアップロード上限を超えています(Presigned Step 1 で拒否されます)。`queryMetadata` のナレッジベース ID が URL と一致しません。`ids` にほかのナレッジベースのファイルが含まれています | `detail` に従って修正してください。対応する拡張子は[Parser 解析ツール](/tech/ja/quickstart/parser.md#document-parsers)、サイズ上限は[API 共通規約:アップロードサイズ上限](/tech/ja/api-integration/api-conventions.md#upload-limits)を参照してください。どちらも `GET /api/v1/allowed-file-specs/` で取得できます |
| `402` | 組織の Credits またはメンバーの利用枠が不足しています(検索と解析の両方で Credits が差し引かれます) | 先に Credits をチャージするか、利用枠を調整してください |
| `500` | プラットフォーム側のエラーです | まず `GET …/files/?query=ファイル名` でファイルが作成されたか確認してください。作成済みなら再送せず(2 件になります)、`GET …/files/{id}/` で状態を確認してください。未作成なら数秒待ち、Step 1 → 3 をやり直してください。引き続き失敗する場合は、時刻、ナレッジベース ID、ファイル ID、キーを除いたリクエスト内容を記録し、MaiAgent の担当者に連絡してください |
各呼び出しの実際のリクエストとレスポンスは、管理画面の [API 呼び出しログ](https://docs.maiagent.ai/org/developer/api-logs)で確認できます。解析失敗(`status: failed`)は HTTP エラーではありません。`GET /api/v1/knowledge-bases/{knowledgeBasePk}/files/{id}/latest-failed-reason/` を呼び出し、直近の失敗の `errorMessage` と `createdAt` を取得してください。ファイルを修正して再アップロードするか、一括再解析エンドポイントで解析器を変更します。管理画面のファイル一覧で「失敗」状態にマウスを合わせると、同じ原因が表示されます。
***
## 完全なサンプル:アップロード、解析完了の待機、検索
以下の Python サンプルでは、PDF をナレッジベースにアップロードし、解析完了を待ってすぐに検索します。アップロードには Presigned 方式を使用します。各手順の詳細は [Presigned ファイルアップロード方式](/tech/ja/api-integration/api_knowledge.md)を参照してください。
```python
import os
import time
import requests
BASE = 'https://api.maiagent.ai/api/v1'
HEADERS = {'Authorization': 'Api-Key YOUR_API_KEY'}
KB_ID = 'YOUR_KNOWLEDGE_BASE_ID'
PATH = '/path/to/manual.pdf'
# 1. Presigned URL を取得し、ファイルをストレージに直接アップロードします
filename = os.path.basename(PATH)
presign = requests.post(
f'{BASE}/upload-presigned-url/',
headers=HEADERS,
json={
'modelName': 'chatbot-file',
'fieldName': 'file',
'filename': filename,
'fileSize': os.path.getsize(PATH),
},
)
presign.raise_for_status()
presign = presign.json()
with open(PATH, 'rb') as f:
upload = requests.post(presign['url'], data=presign['fields'], files={'file': f})
assert upload.status_code == 204, upload.text
# 2. アップロード結果をナレッジベースに登録し、解析を開始します
created = requests.post(
f'{BASE}/knowledge-bases/{KB_ID}/files/',
headers=HEADERS,
json={'files': [{'filename': filename, 'file': presign['fields']['key']}]},
)
created.raise_for_status()
file_id = created.json()[0]['id']
# 3. done または failed になるまでファイルの状態をポーリングします
deadline = time.time() + 30 * 60
while True:
status = requests.get(
f'{BASE}/knowledge-bases/{KB_ID}/files/{file_id}/', headers=HEADERS
).json()['status']
if status in ('done', 'failed'):
break
if time.time() > deadline:
raise TimeoutError('ファイル解析がタイムアウトしました')
time.sleep(10)
if status == 'failed':
raise RuntimeError('ファイル解析に失敗しました。管理画面で失敗原因を確認してください')
# 4. 検索します
results = requests.post(
f'{BASE}/knowledge-bases/{KB_ID}/search/',
headers=HEADERS,
json={'query': '保証期間はどのくらいですか?'},
)
results.raise_for_status()
for node in results.json():
print(node['displayTitle'], node['pageStart'], node['displayText'][:80])
```
* 状態が `initial`、`processing` の場合は処理中です。`done` のファイルのみが検索対象になります。
* 解析時間はファイルサイズ、ページ数、解析器によって異なり、大きなファイルは数分かかる場合があります。ポーリング間隔は 5 秒以上を推奨し、タイムアウトも設定してください。
* 解析に失敗した場合(`failed`)は、`GET …/files/{file_id}/latest-failed-reason/` を呼び出して失敗原因を取得してください(管理画面のファイル一覧の「失敗原因」と同じです)。ファイルを修正して再アップロードするか、再解析してください。[トラブルシューティング](#troubleshooting)を参照してください。
***
## ユースケース
ナレッジベースのファイル管理 API には、次のようなさまざまな活用方法があります。
### 1. ドキュメント更新の自動化
Git リポジトリで製品ドキュメントが更新された際に、CI/CD パイプラインを通じて最新版をナレッジベースに自動アップロードできます。Agent が常に最新の製品情報にアクセスできるようになります。
#### **ワークフローの例**
{% stepper %}
{% step %}
**ドキュメントを更新したコミットを検出します**
{% endstep %}
{% step %}
**ファイルがすでに存在するか確認します**
MaiAgent API を使用して、ナレッジベース内に一致するファイルがあるか確認します。
{% endstep %}
{% step %}
**ファイルを更新/アップロードします**
既存のファイルがあれば情報の部分更新エンドポイントで更新し、存在しなければファイルアップロードエンドポイントで新しいファイルをアップロードします。
{% endstep %}
{% endstepper %}
### 2. コンテンツ管理システムとの連携
MaiAgent をコンテンツ管理システム(CMS)として使用する場合、コンテンツ編集者が次の操作を実行できる管理画面を作成できます。
* 新しいコンテンツファイルのアップロード
* ラベルを使ったコンテンツの整理
* 特定の種類のコンテンツの検索と絞り込み
* 古くなったコンテンツの一括削除
***
## まとめ
MaiAgent の公開 REST API を使用すると、次のようなナレッジベースのファイル管理をより効率的に実行できます。
* ナレッジベースの作成
* ファイルの一覧取得と絞り込み
* 新しいファイルのアップロード
* ファイル情報の更新
* 単一ファイルの削除または一括削除
* ナレッジベースの内容の検索
## 次のステップ
* 完全な [API リファレンス](https://docs.maiagent.ai/api)を確認し、MaiAgent API サービスの利用を開始してください
* [MaiAgent Web Chat SDK ](https://docs.maiagent.ai/tech/api-integration/web-chat-sdk)を活用して、API 連携を簡素化してください
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.
Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:
```
GET https://docs.maiagent.ai/tech/ja/api-integration/knowledge-base-api.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.