> For the complete documentation index, see [llms.txt](https://docs.maiagent.ai/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.maiagent.ai/tech/ja/ai-agents/evaluation.md).

# 回答評価とモニタリング結果

最終更新：2025-11-14

## 概要

MaiAgent は Deepeval フレームワークを使用して回答を評価しています。現在は **Deepeval 3.7.0** にアップグレードされ、より強力な評価機能と柔軟な設定オプションを提供しています。

## バージョンアップデートの説明

### Deepeval 3.7.0 の新機能

MaiAgent プラットフォームは Deepeval 3.7.0 にアップグレードされ、次の重要な改善が加わりました。

#### 1. 設定可能な評価用 LLM

新しいバージョンでは、評価に使用する大規模言語モデル（LLM）をカスタマイズできます。

* **柔軟な選択**：評価に使用する LLM が特定のモデルに限定されなくなりました
* **コストの最適化**：より低コストのモデルを評価に選択し、運用コストを削減できます
* **パフォーマンスの調整**：評価要件に応じて、速度と精度のバランスが適切なモデルを選択できます

**設定例：**

```python
# 評価設定で使用する LLM を指定します
evaluation_config = {
    "evaluation_model": "gpt-4",  # またはその他の対応モデル
    "temperature": 0.0,
    "max_tokens": 1000
}
```

#### 2. 空の Ground Truth の柔軟な処理

新しいバージョンでは、正解（Ground Truth）が空または欠落している場合の処理が改善されました。

* **自動適応**：テストケースに正解がない場合、システムが評価方法を自動的に調整します
* **部分評価**：完全な Ground Truth がなくても、その他の評価観点については評価できます
* **わかりやすい通知**：Ground Truth がないため計算できない評価指標を明確に示します

**適用シナリオ：**

* 標準回答がまだ定義されていない探索的テストの段階
* 正解が一つに定まらない自由回答形式の質疑応答
* AI アシスタントの基本的な回答能力を迅速に検証する場合

#### 3. 並列処理による評価パフォーマンスの向上

Deepeval 3.7.0 では並列処理の仕組みが導入され、評価速度が大幅に向上しました。

* **バッチ評価**：複数のテストケースを同時に評価できます
* **パフォーマンスの向上**：以前のバージョンと比べて、評価速度が 2～3 倍に向上しました
* **リソースの最適化**：コンピューティングリソースをより効率的に活用します

**パフォーマンス比較：**

| テストケース数 | 以前のバージョンの所要時間 | 新しいバージョンの所要時間 | パフォーマンス向上 |
| ------- | ------------- | ------------- | --------- |
| 10 件    | 45 秒          | 18 秒          | 2.5x      |
| 50 件    | 3.5 分         | 1.5 分         | 2.3x      |
| 100 件   | 7 分           | 3 分           | 2.3x      |

### アップグレードの推奨事項

以前のバージョンの評価機能を使用している場合は、次のアップグレード方法を検討してください。

1. **既存の評価設定を確認する**：現在使用している評価パラメーターを確認します
2. **新しい設定オプションをテストする**：新しい LLM 設定機能を試します
3. **テストケースを最適化する**：柔軟な Ground Truth 処理を活用して、テストのカバー範囲を拡大します
4. **パフォーマンスの改善を監視する**：並列処理による速度向上を確認します

## 回答評価結果の確認

回答評価機能は **AgentOps** モジュールにあり、次の 2 つの方法で確認できます。

### リアルタイムモニタリング

AgentOps → AI アシスタントモニタリング

各会話のスコアをリアルタイムで計算し、本番環境の AI アシスタントの回答品質をモニタリングします。

### 自動テスト

AgentOps → 自動テスト

テストセットを使用して評価を一括実行し、完全なレポートと改善案を生成します。バージョンリリース前の品質検証に適しています。

## 評価指標

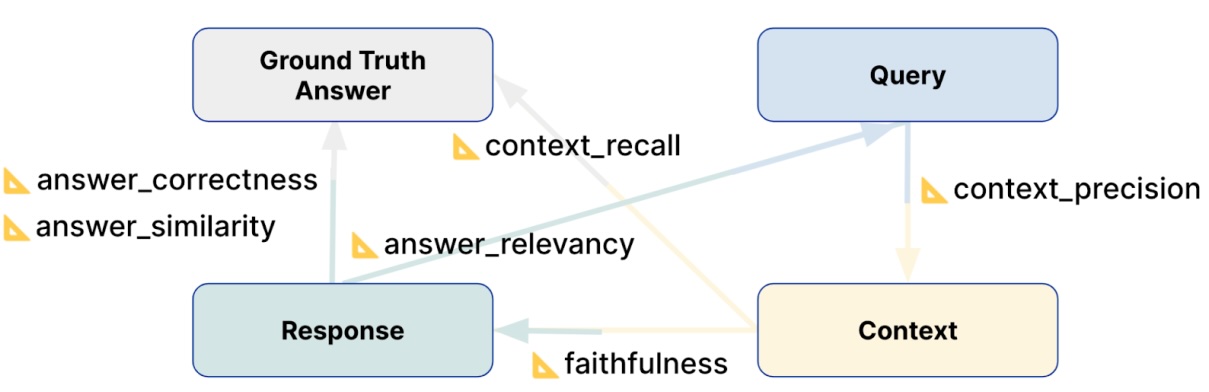
MaiAgent プラットフォームには、質疑応答ごとに記録を残して自動的にスコアを算出する回答評価機能があります。スコアには次の項目が含まれます。

<table><thead><tr><th>指標</th><th>説明</th><th>影響要因</th><th>質問</th><th>回答</th><th width="118">検索コンテキスト</th><th>正解</th></tr></thead><tbody><tr><td>Faithfulness</td><td>LLM が回答を捏造せず、事実に忠実に回答しているか</td><td>LLM、RAG、ナレッジベース</td><td></td><td>✅</td><td>✅</td><td></td></tr><tr><td>Answer Relevancy</td><td>LLM の回答が要点を押さえているか、不完全ではないか、冗長な文章が含まれていないか</td><td>LLM、RAG、ナレッジベース</td><td>✅</td><td>✅</td><td></td><td></td></tr><tr><td>Context Precision</td><td>RAG が検索した内容が質問に関連しているか</td><td>RAG、ナレッジベース</td><td>✅</td><td></td><td>✅</td><td></td></tr><tr><td>Contextual Relevancy</td><td>検索した内容と質問の全体的な関連度</td><td>RAG、ナレッジベース</td><td>✅</td><td></td><td>✅</td><td></td></tr><tr><td>Context Recall</td><td>RAG が検索した内容に、正解に含まれる情報がすべて含まれているか</td><td>RAG、ナレッジベース</td><td></td><td></td><td>✅</td><td>✅</td></tr><tr><td>Answer Correctness</td><td>回答と正解を比較した場合の正確性</td><td>LLM、RAG、ナレッジベース</td><td></td><td>✅</td><td></td><td>✅</td></tr><tr><td>Answer Similarity</td><td>回答と正解の意味的な類似度</td><td>LLM、RAG、ナレッジベース</td><td></td><td>✅</td><td></td><td>✅</td></tr><tr><td>Bias</td><td>回答に性別、人種、宗教などに関する偏見が含まれているかを検出します</td><td>LLM</td><td></td><td>✅</td><td></td><td></td></tr><tr><td>Toxicity</td><td>回答に有害または不快な内容が含まれているかを検出します</td><td>LLM</td><td></td><td>✅</td><td></td><td></td></tr><tr><td>Hallucination</td><td>回答にコンテキストと一致しない架空の情報が含まれているかを検出します</td><td>LLM、RAG</td><td></td><td>✅</td><td>✅</td><td></td></tr></tbody></table>

<figure><img src="https://605688223-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FVYMUz6J7vDZ0QTvb1rbN%2Fuploads%2Fgit-blob-5afff8be7e607c93ab1d4aa997e76120ea0b84db%2FRAG_Evaluation_Metrics_8f5973cd74%E5%89%AF%E6%9C%AC.jpg?alt=media" alt=""><figcaption><p>回答評価指標の関係図</p></figcaption></figure>

### Faithfulness と Hallucination の違い

この 2 つの指標は混同されがちですが、評価する観点が異なります。

* **Faithfulness**：回答のうち検索コンテキストに基づく内容の「割合」を測定する**ポジティブ指標**です（スコアが高いほど良好です）
* **Hallucination**：回答にコンテキストと矛盾する内容や検証できない内容が「存在するか」を検出する**ネガティブ指標**です（スコアが低いほど良好です）

| 観点     | Faithfulness             | Hallucination     |
| ------ | ------------------------ | ----------------- |
| 評価の方向  | ポジティブ（高いほど良好）            | ネガティブ（低いほど良好）     |
| 評価する質問 | 回答のうち、どの程度が情報源に基づいていますか？ | 回答に捏造された内容がありますか？ |
| 計算方法   | 検証可能な記述数 ÷ 全記述数          | 架空の情報が存在するかを検出    |

**例**

> **検索コンテキスト**：「台北 101 の高さは 508 メートルで、2004 年に完成しました」
>
> **回答**：「台北 101 の高さは 508 メートルで、2004 年に完成し、かつて世界で最も高い建築物でした」

* **Faithfulness スコアが低い**：根拠がある内容は 3 分の 2 のみであるためです
* **Hallucination スコアが高い**：「かつて世界で最も高い建築物でした」はコンテキストに記載されていないため、ハルシネーションと見なされます

つまり、Faithfulness は「情報源に忠実である度合い」を重視し、Hallucination は「捏造があるか」を重視します。両者は関連していますが、同じものではありません。Faithfulness が低くても必ずしもハルシネーションがあるとは限りませんが、ハルシネーションがあると Faithfulness は必ず低下します。

## 機能対応表

| 指標                   | リアルタイムモニタリング | 自動テスト |
| -------------------- | :----------: | :---: |
| Faithfulness         |       ✅      |   ✅   |
| Answer Relevancy     |       ✅      |   ✅   |
| Context Precision    |       ✅      |   ✅   |
| Contextual Relevancy |              |   ✅   |
| Context Recall       |      ⚠️      |   ✅   |
| Answer Correctness   |      ⚠️      |       |
| Answer Similarity    |      ⚠️      |       |
| Bias                 |              |   ✅   |
| Toxicity             |              |   ✅   |
| Hallucination        |              |   ✅   |

> ⚠️ 近日提供予定です

## スコアの意味

* 0.5 未満：通常は改善が必要と判断されます
* 0.6～0.7：許容範囲です
* 0.8 以上：良好なパフォーマンスと判断されます
* 0.9 以上：優れたパフォーマンスと判断されます

## スコアが低い原因の特定と解決方法

* LLM の能力に問題があり、参考資料に基づいて質問に回答できない場合
  * 解決方法：より高性能な LLM に切り替えるか、新しいバージョンの設定可能な評価用 LLM 機能を使用します
* RAG の検索能力に問題があり、質問に関連する情報を見つけられない場合
  * 解決方法：MaiAgent のサポート窓口にお問い合わせください
* ナレッジベースから提供される情報が不十分な場合
  * 解決方法：正確なナレッジベース情報と FAQ を追加します

## ベストプラクティス

### 柔軟な Ground Truth の活用

標準回答がない場合でも、次のことができます。

1. まず基本評価（Ground Truth が不要な指標）を実施します
2. AI アシスタントの回答パターンを観察します
3. 実際のパフォーマンスに基づいて、評価基準を段階的に策定します
4. Ground Truth を追加して完全な評価を実施します

### 並列処理の活用

最適な評価パフォーマンスを得るには、次の方法を推奨します。

* 複数のテストケースを一度に評価します（10 件以上を推奨します）
* 少量のバッチを過度に頻繁に評価することは避けます
* 大規模な評価はピーク時間外に実施することを検討します

## 技術リソース

* [Deepeval 公式ドキュメント](https://docs.confident-ai.com/)
* [Deepeval 3.7.0 リリースノート](https://github.com/confident-ai/deepeval/releases/tag/v3.7.0)


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation dynamically by asking a question.

Perform an HTTP GET request on the current page URL with the `ask` query parameter, and the optional `goal` query parameter:

```
GET https://docs.maiagent.ai/tech/ja/ai-agents/evaluation.md?ask=<question>&goal=<endgoal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is optional and describes the broader end goal you are ultimately trying to accomplish on behalf of the user. GitBook uses it to tailor the answer towards what is most useful for that goal.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.
