> For the complete documentation index, see [llms.txt](https://docs.maiagent.ai/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.maiagent.ai/build/knowledge-base/scrape-website.md).

# 如何使用爬蟲（爬取資料）功能

輸入網址、設定爬取範圍，選擇單次執行或定期排程，MaiAgent 就會自動爬取網頁並匯入知識庫或存到檔案庫的檔案工作區，還能追蹤每一次匯入與寫入結果。

## 功能用途與價值 <a href="#feature-purpose-and-value" id="feature-purpose-and-value"></a>

身為企業人員，可能經常會接到長官指示，需要參考或彙整某些公開網站上的法規資料，或讓 Agent 掌握官網上最新的產品與 FAQ 內容。

若具備技術背景，或有工程人員協助，或許可以透過撰寫爬蟲程式自動擷取資料；但對於非技術人員而言，通常只能手動一頁頁整理，不僅耗時費力，還容易遺漏關鍵資訊。

此時，您可以善用 MaiAgent 的爬蟲功能，透過 No-Code（免寫程式）方式：

* **一次爬取整個網站範圍**：設定爬取深度、頁數上限與網址規則，決定要爬哪些頁面
* **單次執行或定期排程**：可以立即爬一次，也可以每日、每週、每月自動重新爬取
* **自動匯入知識庫**：爬完直接匯入指定知識庫，並可選擇網址重複時要略過、覆蓋或允許重複
* **存到檔案工作區**：組織已開通檔案庫時，也可以把爬到的網頁存成檔案庫工作區裡的檔案，每次執行一個資料夾，在 MaiGPT 掛上工作區就能直接讀
* **追蹤匯入結果**：每次匯入成功幾頁、失敗幾頁，都可以在匯入紀錄中查看

## 使用情境 <a href="#use-case" id="use-case"></a>

某公司的客服主管希望 AI 客服回答問題時，內容能和官網 FAQ 保持一致。她先在知識庫中建立一個專門收納官網 FAQ 的知識庫，接著進入「爬蟲」建立爬取請求：填入官網 FAQ 的網址，把最大爬取深度與頁數設小，先確認只會爬到 FAQ 相關頁面；執行方式選「排程執行」、頻率設為每週一早上 9 點，自動匯入目標選剛建立的知識庫，網址已存在時的處理方式選「略過」。建立後，排程分頁就會出現這筆每週同步的任務。之後每次爬取完成，她在爬取請求詳情的「匯入紀錄」就能看到這次自動匯入到哪個知識庫、成功與失敗各幾頁；官網 FAQ 改版時，也不需要再請工程師幫忙整理資料。

另一個例子：某公司的產品經理每週要整理競品官網的公告，寫成週報給主管。她建立一個每週一執行的排程，<mark style="color:blue;">匯入目的地</mark> 選 <mark style="color:blue;">檔案工作區</mark>，指定團隊共用的「競品觀察」工作區。之後每週一爬完，工作區裡就會多一個以當次執行時間命名的資料夾，放著這週爬到的每一頁。她在檔案庫打開「競品觀察」工作區，按 <mark style="color:blue;">由此開始對話</mark>，請 MaiGPT「比較這週和上週資料夾的公告，列出新增的產品與價格調整」，幾分鐘就有週報初稿，不必把網頁一頁頁複製出來，也不用另外建一個知識庫。

## 如何進行爬蟲？ <a href="#how-to-scrape" id="how-to-scrape"></a>

{% hint style="info" %}
若左側選單看不到「爬蟲」，代表您的帳號沒有爬蟲的存取權限，請聯絡組織管理員確認權限設定。
{% endhint %}

### 1. 進入爬蟲頁面 <a href="#open-crawler" id="open-crawler"></a>

從左側選單點選 <mark style="color:blue;">AI 功能</mark> → <mark style="color:blue;">爬蟲</mark>。頁面分為兩個分頁：

* <mark style="color:blue;">頁面爬取請求</mark>：列出每一次爬取（包含單次執行，以及排程每次自動執行產生的爬取），可依名稱或網址搜尋，並以類型（單次／排程）與爬取狀態（完成／進行中／失敗）篩選
* <mark style="color:blue;">排程</mark>：列出所有定期爬取的排程設定

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-e4539a8db7b766461e78291d443ecd5bdab3035f%2Fcrawl-list-requests.png?alt=media" alt="爬蟲頁面的頁面爬取請求分頁，列出一筆單次爬取，爬取狀態為完成，操作欄有詳情、匯入與檢視"><figcaption><p>頁面爬取請求分頁：每筆請求顯示類型、爬取狀態與建立時間</p></figcaption></figure>

### 2. 輸入任務名稱與網址 <a href="#step-url" id="step-url"></a>

點選右上方的 <mark style="color:blue;">建立頁面爬取請求</mark>，建立流程分為「網址」、「爬取設定」、「執行方式」三個步驟。

第一步請填寫：

* <mark style="color:blue;">任務名稱</mark>：方便辨識這個爬取任務，例如「每日商品頁面爬取」
* <mark style="color:blue;">URL</mark>：要開始爬取的網址

填好後點 <mark style="color:blue;">下一步</mark>。

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-90d847c058b16aa2555db9acbfb4deb8cb91d7df%2Fcrawl-create-url.png?alt=media" alt="建立頁面爬取請求視窗的第一步，填寫任務名稱與 URL"><figcaption><p>第一步：填寫任務名稱與起始網址</p></figcaption></figure>

### 3. 設定爬取深度與範圍 <a href="#step-crawl-settings" id="step-crawl-settings"></a>

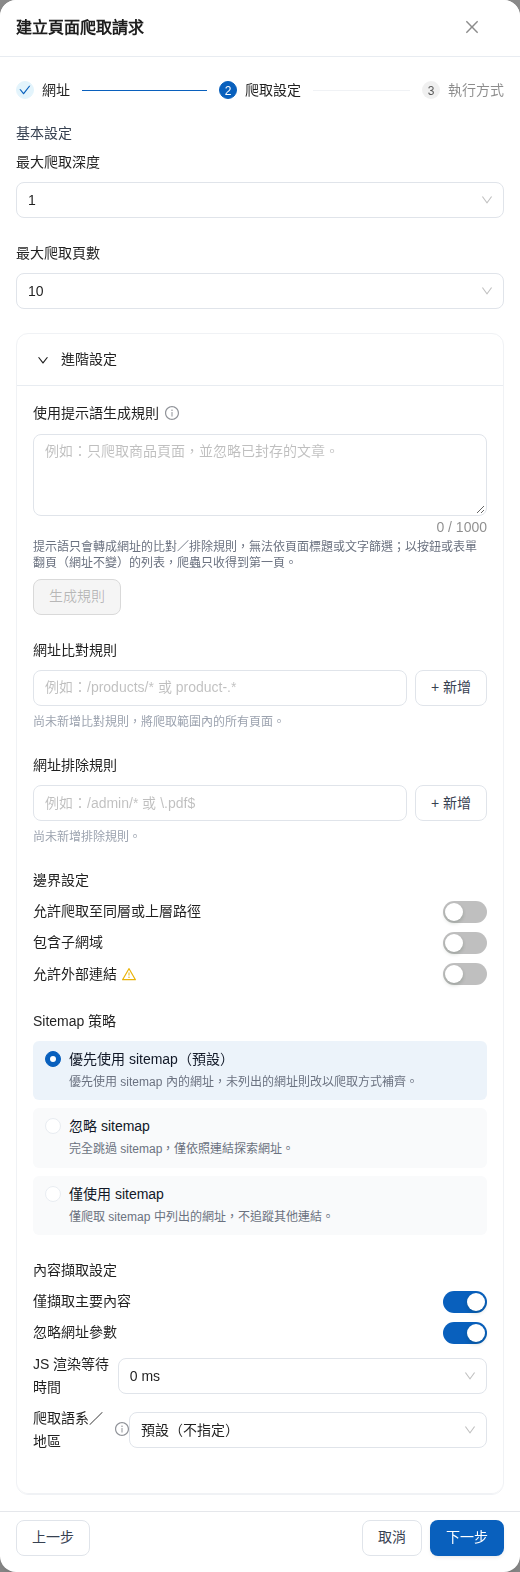
第二步「爬取設定」決定要爬多少頁面。<mark style="color:blue;">基本設定</mark>有兩個欄位：

| 欄位                                      | 說明                                          |
| --------------------------------------- | ------------------------------------------- |
| <mark style="color:blue;">最大爬取深度</mark> | 從起始網址往下追連結的層數，可選 1–10，預設 2                  |
| <mark style="color:blue;">最大爬取頁數</mark> | 這次最多爬取的頁數，可選 10、50、100、500、1000、5000，預設 100 |

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-b8322b7180855f80945e61f82f8859bbf5c5a8bb%2Fcrawl-create-basic-settings.png?alt=media" alt="爬取設定步驟的基本設定，最大爬取深度設為 1、最大爬取頁數設為 10"><figcaption><p>基本設定：以最大爬取深度與最大爬取頁數控制爬取範圍</p></figcaption></figure>

需要更精確地控制範圍時，展開 <mark style="color:blue;">進階設定</mark>：

| 設定                                          | 說明                                                                                                                                                                                                                                                                                                                                                                                                                                                                       |
| ------------------------------------------- | ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------ |
| <mark style="color:blue;">使用提示語生成規則</mark>  | 用自然語言描述要收哪些網址（例如「只爬取商品頁面，並忽略已封存的文章」），按 <mark style="color:blue;">生成規則</mark> 後 AI 會把它轉成下方的網址比對與排除規則，生成後仍可逐條修改。要先在第一步填入網址才能生成；提示語無法對應到網址規則時會提示「目前只支援依網址篩選」，請改寫提示語或手動新增規則。沒按生成規則就繼續時會先跳出確認，見下方「[提示語還沒生成規則時的確認](#prompt-not-generated-confirm)」                                                                                                                                                                                                                             |
| <mark style="color:blue;">網址比對規則</mark>     | 只爬取符合規則的網址，例如 `/products/*`；未新增規則時會爬取範圍內的所有頁面                                                                                                                                                                                                                                                                                                                                                                                                                            |
| <mark style="color:blue;">網址排除規則</mark>     | 符合規則的網址不爬取，例如 `/admin/*` 或 `\.pdf$`                                                                                                                                                                                                                                                                                                                                                                                                                                      |
| <mark style="color:blue;">邊界設定</mark>       | 是否 <mark style="color:blue;">允許爬取至同層或上層路徑</mark>、<mark style="color:blue;">包含子網域</mark>、<mark style="color:blue;">允許外部連結</mark>，預設皆關閉                                                                                                                                                                                                                                                                                                                                    |
| <mark style="color:blue;">Sitemap 策略</mark> | <mark style="color:blue;">優先使用 sitemap（預設）</mark>、<mark style="color:blue;">忽略 sitemap</mark> 或 <mark style="color:blue;">僅使用 sitemap</mark>                                                                                                                                                                                                                                                                                                                             |
| <mark style="color:blue;">內容擷取設定</mark>     | <mark style="color:blue;">僅擷取主要內容</mark>、<mark style="color:blue;">忽略網址參數</mark>（預設皆開啟），以及 <mark style="color:blue;">JS 渲染等待時間</mark>（0、500、1000、2000 ms）                                                                                                                                                                                                                                                                                                                |
| <mark style="color:blue;">爬取語系／地區</mark>    | 以指定語言與地區讀取網站。多語網站會依此回傳對應語言版本，例如選 <mark style="color:blue;">繁體中文（台灣）</mark> 可避免被轉到英文版；可選 <mark style="color:blue;">繁體中文（台灣）</mark>、<mark style="color:blue;">简体中文（中国）</mark>、<mark style="color:blue;">English (US)</mark>、<mark style="color:blue;">日本語（日本）</mark>。<mark style="color:blue;">預設（不指定）</mark> 不向網站宣告語言，由爬取服務決定（目前等同英文）。位於 <mark style="color:blue;">內容擷取設定</mark> 下方，預覽與排程的每次執行都沿用同一個語系，說明見[多語網站：指定爬取語系／地區](/build/knowledge-base/crawler.md#crawl-locale) |

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-ea33308d14838c70084cba9240919e27688ce38c%2Fcrawl-create-advanced-settings.png?alt=media" alt="爬取設定步驟展開的進階設定，包含使用提示語生成規則、網址比對規則、網址排除規則、邊界設定、Sitemap 策略、內容擷取設定，以及內容擷取設定下方的爬取語系／地區（預設（不指定））"><figcaption><p>進階設定：以網址規則、邊界與 Sitemap 策略進一步限定爬取範圍，並可指定爬取語系／地區</p></figcaption></figure>

{% hint style="warning" %}
開啟 <mark style="color:blue;">允許外部連結</mark> 後會爬取站外網址，可能大幅增加爬取頁數與費用。建議先用較小的深度與頁數測試，確認範圍正確後再放大。
{% endhint %}

{% hint style="info" %}
提示語只會轉成網址的比對／排除規則，無法依頁面標題或內文篩選；以按鈕或表單翻頁（網址不變）的列表，爬蟲只收得到第一頁。
{% endhint %}

#### 提示語還沒生成規則時的確認 <a href="#prompt-not-generated-confirm" id="prompt-not-generated-confirm"></a>

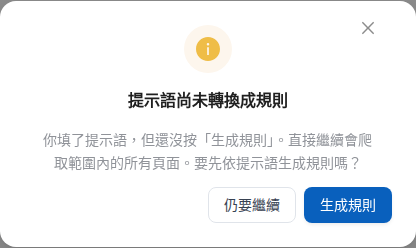
填了 <mark style="color:blue;">使用提示語生成規則</mark>，但還沒按 <mark style="color:blue;">生成規則</mark>（或生成後又改過提示語）就按 <mark style="color:blue;">下一步</mark> 或 <mark style="color:blue;">預覽</mark> 時，系統會先跳出「提示語尚未轉換成規則」確認視窗，提醒直接繼續會爬取範圍內的所有頁面：

* <mark style="color:blue;">生成規則</mark>：依提示語生成網址規則。從 <mark style="color:blue;">預覽</mark> 跳出時，會先回到「爬取設定」步驟生成，讓您看到產生的規則，確認後再預覽
* <mark style="color:blue;">仍要繼續</mark>：不生成規則，照目前的設定繼續
* 按右上角關閉或 Esc：留在目前步驟，不做任何動作

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-7f8055a4cfe839de6bbcdb293681827d151388cf%2Fcrawl-create-prompt-confirm.png?alt=media" alt="提示語尚未轉換成規則確認視窗，說明直接繼續會爬取範圍內的所有頁面，下方有仍要繼續與生成規則兩個按鈕"><figcaption><p>提示語還沒生成規則就按下一步時跳出的確認視窗</p></figcaption></figure>

{% hint style="info" %}
只有提示語本身的變動會觸發確認；生成後手動新增或刪除 <mark style="color:blue;">網址比對規則</mark>、<mark style="color:blue;">網址排除規則</mark> 不算改提示語，不會再跳出確認。在 <mark style="color:blue;">下一步</mark> 選了 <mark style="color:blue;">仍要繼續</mark> 後，到「執行方式」再按 <mark style="color:blue;">預覽</mark> 仍會再問一次。
{% endhint %}

例如，某公司的知識管理專員要把官網 `/docs/` 底下的說明文件爬進知識庫。她在提示語寫「只收 /docs/ 底下的頁面，排除 PDF」後直接按 <mark style="color:blue;">下一步</mark>，系統跳出確認視窗；她選 <mark style="color:blue;">生成規則</mark>，規則區隨即出現 `/docs/.*` 比對規則與 `.*\.pdf$` 排除規則，再按 <mark style="color:blue;">下一步</mark> 就不會重複詢問，避免一不小心把整個網站都爬進知識庫。

#### 爬取範圍怎麼決定 <a href="#crawl-scope-rules" id="crawl-scope-rules"></a>

爬蟲從起始網址出發，沿著頁面上的連結往外找，一個網址要同時通過下列條件才會被爬取：

| 條件         | 規則                                                                                                                                                                                                                                                                 |
| ---------- | ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------ |
| 站內範圍       | 預設只爬同一個主機名稱、且路徑在起始網址底下的頁面（起始網址是 `https://example.com/docs/` 時，`/docs/a` 會爬、`/blog/` 不會）。<mark style="color:blue;">允許爬取至同層或上層路徑</mark> 放寬為整個網域；<mark style="color:blue;">包含子網域</mark> 再加入 `help.example.com` 這類子網域；<mark style="color:blue;">允許外部連結</mark> 才會爬到其他網站 |
| 網址規則       | <mark style="color:blue;">網址排除規則</mark> 優先於 <mark style="color:blue;">網址比對規則</mark>；設了比對規則後，不符合任何一條的網址都不爬。規則是正規表示式，預設只比對網址的路徑部分（不含主機名稱與參數）                                                                                                                         |
| 深度         | <mark style="color:blue;">最大爬取深度</mark> 是「發現順序」的層數：起始網址與 sitemap 裡列出的網址算第 0 層，從它們連出去的頁面是第 1 層，再連出去的是第 2 層，依此類推。只要超過設定的層數就不再往下找                                                                                                                                     |
| 頁數         | <mark style="color:blue;">最大爬取頁數</mark> 是這次爬取的總頁數上限，達到就停止，和深度無關                                                                                                                                                                                                    |
| Sitemap    | 預設 <mark style="color:blue;">優先使用 sitemap</mark>：網站有 sitemap 時，裡面列出的網址會直接納入（視為第 0 層），即使起始頁面沒有連到它們；<mark style="color:blue;">忽略 sitemap</mark> 只沿連結找；<mark style="color:blue;">僅使用 sitemap</mark> 只爬 sitemap 列出的網址                                                  |
| 網址參數       | <mark style="color:blue;">忽略網址參數</mark> 開啟時，`?page=2` 這類只差參數的網址視為同一頁，只爬一次；頁面內容靠參數切換的網站請關閉                                                                                                                                                                          |
| robots.txt | 一律遵守目標網站的 robots.txt，被禁止的路徑不會爬取，也無法用設定繞過                                                                                                                                                                                                                           |

同一個網址在一次爬取中只會處理一次，不會因為多個頁面都連到它而重複爬取。

**只想抓起始頁這一頁**時：Sitemap 策略選 <mark style="color:blue;">忽略 sitemap</mark>、最大爬取深度設 1，並在 <mark style="color:blue;">網址比對規則</mark> 加入只符合該頁路徑的規則（例如 `^/about/?$`），再用 <mark style="color:blue;">預覽</mark> 確認「將爬取」只有這一頁。

設定完成後點 <mark style="color:blue;">下一步</mark>。

### 4. 選擇執行方式與匯入目的地 <a href="#step-execution" id="step-execution"></a>

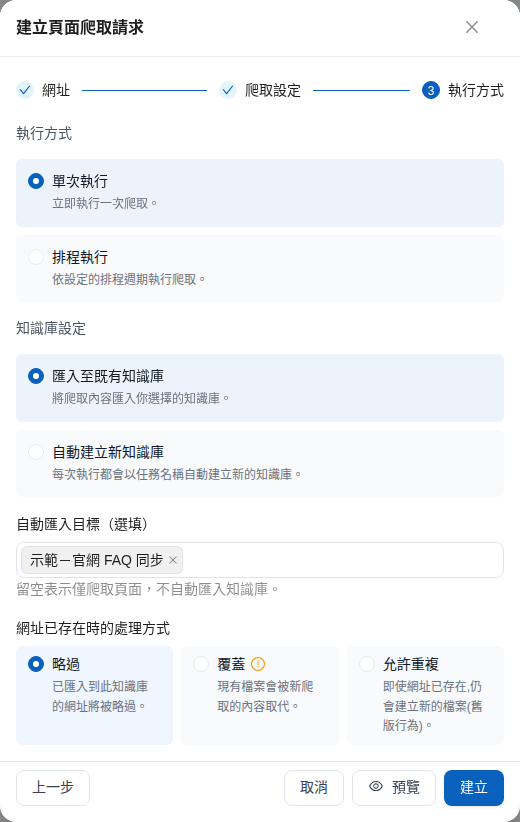
第三步「執行方式」決定何時爬取，以及爬完之後要匯入哪裡。

**執行方式**

* <mark style="color:blue;">單次執行</mark>：建立後立即執行一次爬取
* <mark style="color:blue;">排程執行</mark>：依設定的排程週期執行爬取（設定方式見下一節「[設定定期排程](#schedule)」）

**匯入目的地**

組織已開通[檔案庫](/work/file-library.md)時，會出現 <mark style="color:blue;">匯入目的地</mark>，兩者擇一：

* <mark style="color:blue;">知識庫</mark>（預設）：照下方「知識庫設定」匯入知識庫
* <mark style="color:blue;">檔案工作區</mark>：把爬到的網頁存成檔案庫工作區裡的檔案，設定方式見下方「[存到檔案工作區](#workspace-destination)」

組織沒有開通檔案庫時不會出現這個選項，爬取結果一律依「知識庫設定」處理。

**知識庫設定**（匯入目的地為「知識庫」時）

* <mark style="color:blue;">匯入至既有知識庫</mark>：在 <mark style="color:blue;">自動匯入目標（選填）</mark> 選擇一個或多個知識庫，爬取完成後會自動匯入；留空則只爬取頁面、不自動匯入，之後可再[手動匯入](#manual-import)
* <mark style="color:blue;">自動建立新知識庫</mark>：每次執行都會以任務名稱自動建立一個新的知識庫，並將爬取內容匯入其中

選擇了匯入目標後，會出現 <mark style="color:blue;">網址已存在時的處理方式</mark>，用來處理同一個網址已經匯入過該知識庫的情況：

| 選項                                      | 說明               |
| --------------------------------------- | ---------------- |
| <mark style="color:blue;">略過</mark>（預設） | 已匯入到此知識庫的網址將被略過  |
| <mark style="color:blue;">覆蓋</mark>     | 現有檔案會被新爬取的內容取代   |
| <mark style="color:blue;">允許重複</mark>   | 即使網址已存在，仍會建立新的檔案 |

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-b849114622ef4fe018592ac55f4824c782ab52d5%2Fcrawl-create-execution-oneshot.png?alt=media" alt="執行方式步驟選擇單次執行、匯入至既有知識庫，並顯示網址已存在時的處理方式，預設為略過"><figcaption><p>執行方式：選擇單次執行，並指定自動匯入的知識庫與重複網址的處理方式</p></figcaption></figure>

{% hint style="info" %}
定期同步同一個網站時，建議使用 <mark style="color:blue;">略過</mark> 或 <mark style="color:blue;">覆蓋</mark>，避免知識庫中累積重複的檔案，導致 Agent 引用到舊內容。
{% endhint %}

#### 存到檔案工作區 <a href="#workspace-destination" id="workspace-destination"></a>

<mark style="color:blue;">匯入目的地</mark> 選 <mark style="color:blue;">檔案工作區</mark> 後，在下方的 <mark style="color:blue;">檔案工作區</mark> 選擇要存放的工作區。清單分成 <mark style="color:blue;">組織共用</mark> 與 <mark style="color:blue;">我的檔案庫</mark> 兩組，只會列出您有寫入權限的工作區；只能選工作區本身，不能指定工作區裡的子資料夾。還沒有可寫入的工作區時，會顯示「沒有可寫入的檔案工作區」，點 <mark style="color:blue;">前往檔案庫建立</mark> 建好工作區後再回來選擇。

選定工作區後，下方會顯示「每次執行會建立新資料夾」與存放路徑：

```
工作區 / 爬蟲名稱 / 執行時間（YYYY-MM-DD HHmm）
```

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-f094c5b243861cfcfb81cb7e036707198fa2df71%2Fcrawl-create-destination-workspace.png?alt=media" alt="執行方式步驟的匯入目的地選擇檔案工作區，檔案工作區選擇示範－A1 上市提案，下方顯示每次執行會建立新資料夾與存放路徑"><figcaption><p>匯入目的地選「檔案工作區」：選定工作區後顯示每次執行的存放路徑</p></figcaption></figure>

存到檔案工作區時的規則：

| 項目   | 說明                                                                                                               |
| ---- | ---------------------------------------------------------------------------------------------------------------- |
| 資料夾  | 每次執行（單次或排程）都在「爬蟲名稱」資料夾下新建一個以執行開始時間（台北時間）命名的資料夾，不會覆蓋或刪除之前的資料夾。同一分鐘執行兩次時，第二個資料夾名稱後面會加「 (1)」                        |
| 檔案   | 每個網頁存成一個檔案：一般網頁存成「標題.md」，網址本身是檔案（例如 PDF）時存原檔。同一次執行有標題相同的網頁時全部保留，第二個起存成「標題 (1).md」「標題 (2).md」；標題中檔案庫不允許的字元會換成「\_」 |
| 知識庫  | 不會匯入任何知識庫，也不會出現「網址已存在時的處理方式」；之後仍可在爬取請求詳情點 <mark style="color:blue;">匯入知識庫</mark> [手動匯入](#manual-import)          |
| 寫入者  | 最後一次設定檔案工作區目的地的成員。建立時是建立者；之後有人編輯並更換了匯入目的地或工作區，寫入者就改為這位編輯者。每次執行都以寫入者當下的權限寫入，存入的檔案也記在寫入者名下                         |
| 費用   | 只收爬取費用，不收知識庫匯入與解析費用；存入的檔案計入組織的儲存空間                                                                               |
| 檔案操作 | 存入的是一般檔案，有寫入權限的成員可以改名、搬移或刪除。舊的執行資料夾不會自動清除，請視需要自行刪除                                                               |

{% hint style="info" %}
在 MaiGPT 掛上工作區時，工作區的檔案數有上限。排程每次執行都會新增一個資料夾，檔案數會持續累積；爬取請求詳情出現「工作區檔案數已超過 MaiGPT 可掛載上限」提示時，請清理舊的執行資料夾。掛載方式見[在 MaiGPT 使用工作區](/work/file-library/use-in-maigpt.md)。
{% endhint %}

編輯排程時可以把匯入目的地從知識庫改成檔案工作區，或從檔案工作區改回知識庫，下一次執行起生效；已經匯入知識庫或存進工作區的檔案都保留不動。更換工作區時，舊工作區已寫入的資料夾也不會搬移。

### 5. 預覽並建立 <a href="#preview-and-create" id="preview-and-create"></a>

建立前可以先點 <mark style="color:blue;">預覽</mark>，確認實際會爬取哪些頁面。預覽會探索網站網址並計費，系統會先跳出確認視窗，按 <mark style="color:blue;">確定</mark> 後才會執行。

預覽結果會顯示發現的網址數、將爬取與被排除的網址數、預估頁數與預估時間，並列出將爬取的頁面。

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-98ade6f0b412295b27e59ddb54058d43ec4ade6b%2Fcrawl-preview.png?alt=media" alt="預覽視窗顯示目標網址、發現 URL、將爬取與排除的數量、預估頁數與預估時間，以及將爬取的頁面清單"><figcaption><p>預覽：建立前先確認將爬取的頁面數量與清單</p></figcaption></figure>

{% hint style="info" %}
預覽是預估結果，實際爬取會因深度限制、JavaScript 動態頁面與 robots.txt 而略有差異。
{% endhint %}

確認無誤後點 <mark style="color:blue;">建立</mark>。單次執行的請求會出現在「頁面爬取請求」分頁，並開始爬取。

若這個網址先前已經爬取過，系統會跳出 <mark style="color:blue;">此網址已被爬取過</mark> 的確認視窗，列出先前爬取的時間、頁面數與已匯入的知識庫。確定仍要重新爬取時點 <mark style="color:blue;">再次爬取</mark>，不需要則點 <mark style="color:blue;">取消</mark>。

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-1701750793d8cd036def10ccfdc6c13d6294e3a0%2Fcrawl-previously-crawled.png?alt=media" alt="此網址已被爬取過的確認視窗，列出先前的爬取時間、子頁面數與已匯入的知識庫"><figcaption><p>重複爬取提醒：可先確認先前的爬取結果，再決定是否重新爬取</p></figcaption></figure>

## 設定定期排程 <a href="#schedule" id="schedule"></a>

網站內容會持續更新時，可在第三步選擇 <mark style="color:blue;">排程執行</mark>，讓系統定期重新爬取，並自動匯入知識庫或存到檔案工作區。

| 欄位                                                                          | 說明                                                                                                                                              |
| --------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------------------------------- |
| <mark style="color:blue;">頻率</mark>                                         | <mark style="color:blue;">單次</mark>、<mark style="color:blue;">每日</mark>、<mark style="color:blue;">每週</mark>、<mark style="color:blue;">每月</mark> |
| <mark style="color:blue;">時區</mark>                                         | 排程時間所依據的時區                                                                                                                                      |
| <mark style="color:blue;">開始日期</mark>／<mark style="color:blue;">結束日期</mark> | 排程生效期間；結束日期為選填，頻率為「單次」時只需開始日期                                                                                                                   |
| <mark style="color:blue;">執行時間</mark>                                       | 每次執行的時間                                                                                                                                         |
| <mark style="color:blue;">週幾執行</mark>                                       | 頻率為「每週」時，勾選要執行的星期（可複選）                                                                                                                          |
| <mark style="color:blue;">每月幾號</mark>                                       | 頻率為「每月」時，填寫 1–31                                                                                                                                |

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-2d4abe505f3c1a4ac079e7c5eabefd3ebea96cdb%2Fcrawl-create-execution-schedule.png?alt=media" alt="排程執行設定，頻率選每週、時區 Asia/Taipei、執行時間 09:00、週幾執行勾選週一，並匯入至既有知識庫"><figcaption><p>排程執行：設定每週一早上 9 點自動爬取並匯入知識庫</p></figcaption></figure>

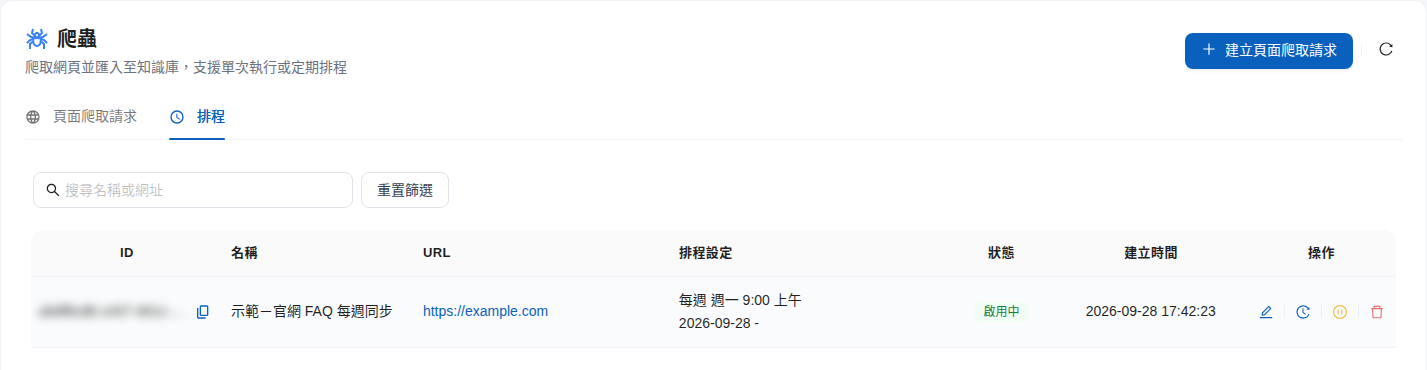
建立後，排程會列在 <mark style="color:blue;">排程</mark> 分頁，顯示排程設定與狀態（<mark style="color:blue;">啟用中</mark>／<mark style="color:blue;">已暫停</mark>）。操作欄的圖示依序可以：

* **編輯**：開啟「編輯排程」修改任務名稱、爬取設定、排程時間、匯入目的地與知識庫設定（起始網址建立後無法修改）
* **執行紀錄**：查看這個排程每一次執行的時間與爬取狀態，並可進入該次爬取的詳情；組織已開通檔案庫時，另有 <mark style="color:blue;">工作區寫入</mark> 欄顯示每次存到檔案工作區的結果
* **暫停／啟用**：暫時停止排程，或重新啟用
* **刪除**：刪除排程

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-a004c12c146f1a0a9fae14b5ee685e937d16b530%2Fcrawl-schedule-list.png?alt=media" alt="排程分頁列出一筆每週一 9:00 執行的排程，狀態為啟用中，操作欄有編輯、執行紀錄、暫停與刪除圖示"><figcaption><p>排程分頁：查看排程設定，並可編輯、查看執行紀錄、暫停或刪除</p></figcaption></figure>

{% hint style="warning" %}
每次排程執行都會實際爬取網頁並消耗 Credits。暫時不需要同步時，建議先暫停排程。
{% endhint %}

## 查看爬取結果與匯入紀錄 <a href="#results-and-import-history" id="results-and-import-history"></a>

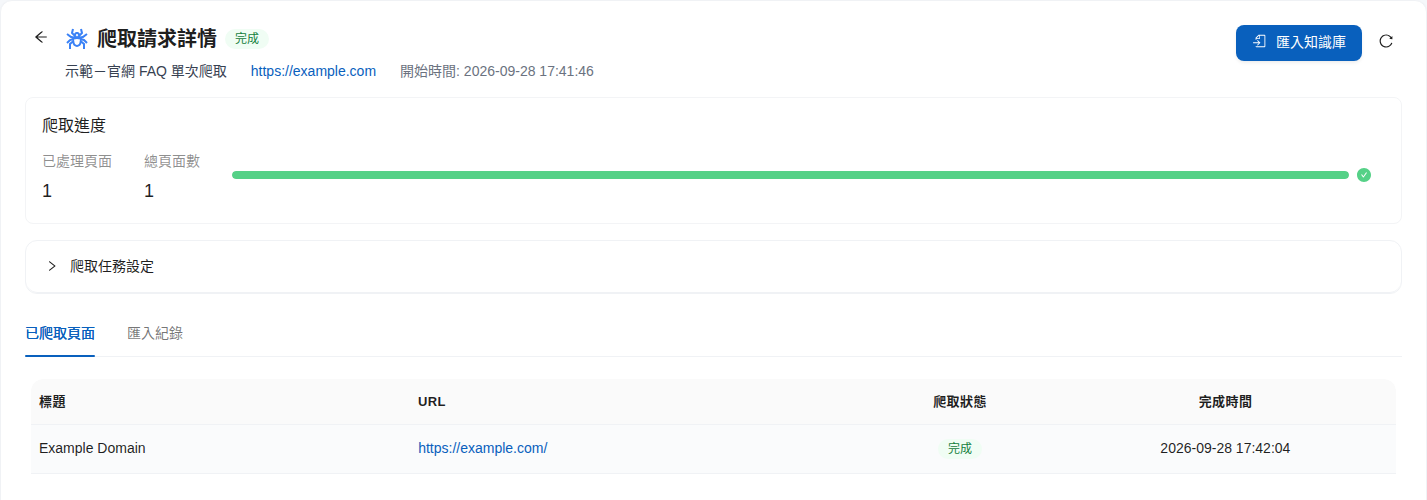
在「頁面爬取請求」分頁點選該筆請求的 <mark style="color:blue;">詳情</mark>，進入 <mark style="color:blue;">爬取請求詳情</mark> 頁面：

* <mark style="color:blue;">爬取進度</mark>：已處理頁面與總頁面數
* <mark style="color:blue;">爬取任務設定</mark>：展開後可回顧建立時的網址、爬取設定與執行方式；切到「爬取設定」可看到這次使用的 <mark style="color:blue;">爬取語系／地區</mark>（未設定時顯示「預設（不指定）」）
* <mark style="color:blue;">已爬取頁面</mark>：列出每個爬到的頁面標題、URL、爬取狀態與完成時間

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-0d2fa9e3af7c9c17622c9a76458e1535b3a2f8f8%2Fcrawl-detail.png?alt=media" alt="爬取請求詳情頁，顯示爬取進度、爬取任務設定與已爬取頁面列表"><figcaption><p>爬取請求詳情：查看爬取進度與已爬取的頁面</p></figcaption></figure>

匯入目的地為檔案工作區時，詳情頁會多一個 <mark style="color:blue;">匯入目的地</mark> 區塊：

* <mark style="color:blue;">檔案工作區</mark>：存放的工作區與所屬空間，點名稱可在檔案庫開啟
* <mark style="color:blue;">寫入者</mark>：這次以誰的權限寫入
* <mark style="color:blue;">工作區寫入結果</mark>：成功、失敗與未寫入的頁數；有頁面沒寫入時，列出網址與原因
* <mark style="color:blue;">資料夾</mark>：這次執行的資料夾路徑，點選即可在檔案庫開啟

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-225eb4e597d02cdf35949e6e02d6fe30bf2596ff%2Fcrawl-detail-workspace-write.png?alt=media" alt="爬取請求詳情的匯入目的地區塊，顯示檔案工作區名稱、寫入者、工作區寫入結果已寫入成功 1 頁，以及這次執行的資料夾路徑"><figcaption><p>匯入目的地區塊：確認寫入結果，並從資料夾連結直接開啟檔案庫</p></figcaption></figure>

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-71c4414d6b1a7b2c73777984ffc03cf183ab8dc1%2Fcrawl-workspace-folder.png?alt=media" alt="檔案庫的組織空間下，工作區內有爬蟲名稱資料夾與以執行時間命名的子資料夾，裡面是爬到的 Example Domain.md"><figcaption><p>檔案庫中的存放位置：工作區 / 爬蟲名稱 / 執行時間</p></figcaption></figure>

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-5c79ddd8513569f8e090b2f8f926a1d2a7dedb09%2Fcrawl-detail-locale.png?alt=media" alt="爬取任務設定的內容擷取設定區，爬取語系／地區唯讀顯示繁體中文（台灣），下方已爬取頁面列出一筆完成的中文標題頁面"><figcaption><p>爬取任務設定：唯讀顯示這次使用的爬取語系／地區</p></figcaption></figure>

切換到 <mark style="color:blue;">匯入紀錄</mark> 分頁，可以看到每一次匯入的時間、匯入的知識庫、<mark style="color:blue;">匯入方式</mark>（依建立時的設定自動匯入者顯示「自動」），以及成功與失敗的頁數。

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-e7cd87be7b457d330db2ca3192ca780cf6fb4cab%2Fcrawl-import-history.png?alt=media" alt="匯入紀錄分頁顯示一筆匯入，知識庫為示範知識庫，匯入方式為自動，成功 1、失敗 0"><figcaption><p>匯入紀錄：每次匯入的知識庫、匯入方式與成功／失敗頁數</p></figcaption></figure>

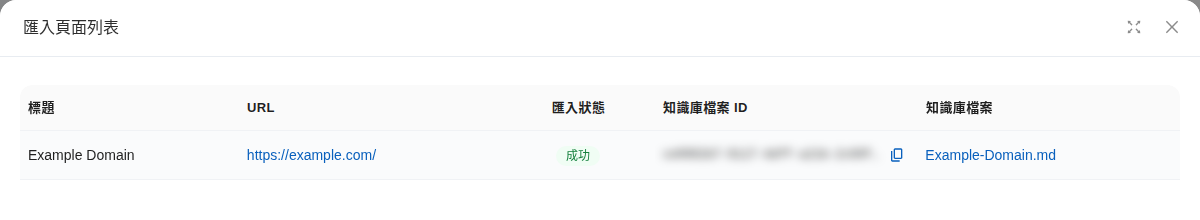
點操作欄的圖示可開啟 <mark style="color:blue;">匯入頁面列表</mark>，逐頁查看匯入狀態，以及對應的知識庫檔案。

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-776aee0d55309e3f78688782e1f8b4c84cbd41f7%2Fcrawl-import-run-pages.png?alt=media" alt="匯入頁面列表視窗，列出頁面標題、URL、匯入狀態成功與對應的知識庫檔案"><figcaption><p>匯入頁面列表：確認每個頁面匯入後對應的知識庫檔案</p></figcaption></figure>

此外，在「頁面爬取請求」列表中，已完成的請求可點 <mark style="color:blue;">檢視</mark> 開啟 <mark style="color:blue;">失敗匯入紀錄</mark>，選擇知識庫後查看匯入失敗的頁面與失敗原因。

匯入後的內容會以 .md 檔呈現在知識庫的文件列表中（檔名取自頁面標題），和一般文件一樣可以設定標籤與元資料。這些檔案的 <mark style="color:blue;">來源</mark> 欄會顯示 <mark style="color:blue;">爬蟲</mark> 標籤，點選即可回到對應的爬取請求詳情。系統也會把來源網址寫進文件的 `url` 元資料，Agent 引用這份文件時，使用者點引用會直接開啟原始網頁；內容保留方式見[知識庫總覽的常見問題](/build/knowledge-base/km.md#faq-format-preservation)。

## 手動匯入爬取頁面 <a href="#manual-import" id="manual-import"></a>

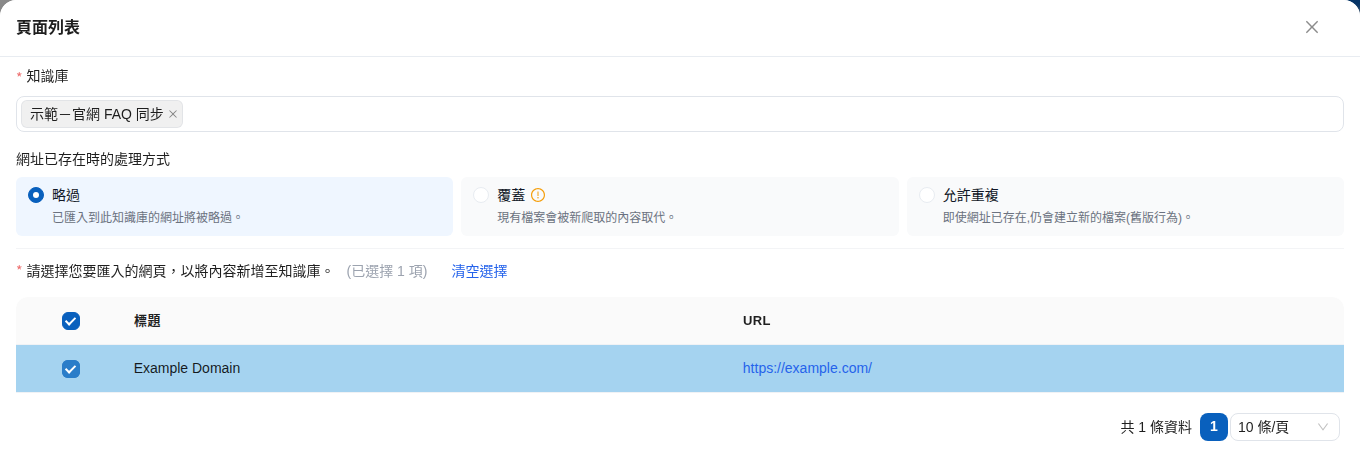
建立時沒有設定自動匯入，或想把頁面匯入其他知識庫時，可以手動匯入：

1. 在爬取請求詳情頁點 <mark style="color:blue;">匯入知識庫</mark>（或在列表中點該筆請求的 <mark style="color:blue;">匯入</mark>）
2. 選擇要匯入的 <mark style="color:blue;">知識庫</mark>，並選擇 <mark style="color:blue;">網址已存在時的處理方式</mark>
3. 勾選要匯入的頁面，點 <mark style="color:blue;">匯入</mark>

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-b84abfbe106ef4aab81f035bee907c9c9c77b2e2%2Fcrawl-manual-import.png?alt=media" alt="頁面列表視窗，選擇知識庫與網址已存在時的處理方式，並勾選要匯入的頁面"><figcaption><p>手動匯入：選擇知識庫、重複網址處理方式與要匯入的頁面</p></figcaption></figure>

若選擇 <mark style="color:blue;">略過</mark> 且部分網址已經匯入過，系統會提示建立了幾個匯入任務、略過了幾個重複網址。

{% hint style="warning" %}
手動匯入時會重新爬取最新頁面資料，會產生一次爬取費用。
{% endhint %}

## 爬取或匯入失敗時怎麼查 <a href="#troubleshooting" id="troubleshooting"></a>

先分清楚是哪一段失敗，再對照原因：

| 現象                                                 | 常見原因                                                                                                 | 怎麼處理                                                                                                                                                                          |
| -------------------------------------------------- | ---------------------------------------------------------------------------------------------------- | ----------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| 建立請求時就被擋下                                          | 起始網址超過 200 個字元，或不是完整的網址（需含 `http://` 或 `https://`）                                                   | 改用較短的上層網址作為起點，再用爬取深度與比對規則涵蓋目標頁面                                                                                                                                               |
| 爬取狀態為失敗，原因是「爬取已結束，但沒有取得任何頁面」                       | 目標網站的 robots.txt 不允許爬取（原因會列出被阻擋的網址）；網站阻擋自動化存取；起始網址無法載入                                               | 確認網址在未登入的瀏覽器中打得開。網站不允許爬取時，請改用上傳檔案的方式提供內容                                                                                                                                      |
| 爬到的頁面比預期少                                          | 頁面超出爬取網域範圍、被排除規則排除、超過最大爬取深度或頁數；內容由 JavaScript 動態載入；爬取跑滿 30 分鐘被提前結束（見下方「[爬取時間上限](#crawl-time-limit)」） | 建立前先用預覽確認「將爬取」與「被排除」的網址，再調整深度、頁數與比對規則                                                                                                                                         |
| 爬取狀態為失敗，原因是「爬取已停止回應，於 2 小時後關閉。已爬取並保留 N 個頁面，但尚未匯入。」 | 爬取在執行途中中斷、一直停在進行中，建立滿 2 小時後由系統自動結束                                                                   | 這次不會扣 Credits，也不會匯入任何頁面。請重新建立同一個網址的爬取請求（排程則等下一次執行），完成後才會匯入                                                                                                                    |
| 頁面需要登入才能看                                          | 爬蟲只能讀取公開頁面                                                                                           | 把內容匯出成檔案後上傳到知識庫                                                                                                                                                               |
| 網站只放行白名單 IP，想把爬蟲的來源 IP 加進去                         | 爬取由雲端爬取服務執行，來源 IP 不固定，MaiAgent 無法提供可加入白名單的 IP                                                        | 請網站管理者把要提供的內容匯出成檔案，上傳到知識庫                                                                                                                                                     |
| 爬取成功，但工作區寫入結果顯示「目標工作區已不存在」                         | 存放的工作區已被刪除                                                                                           | 編輯排程，重新選擇匯入目的地的工作區。這次爬取仍照常計費，也不會改匯入知識庫                                                                                                                                        |
| 工作區寫入結果顯示「寫入者沒有該工作區的寫入權限」                          | 寫入者已失去該工作區的寫入權限，例如角色被調整或已離開組織                                                                        | 由目前有寫入權限的成員編輯排程，重新選擇工作區後儲存，寫入者就會改成這位成員                                                                                                                                        |
| 工作區寫入結果顯示「此組織尚未開通檔案庫」                              | 組織的檔案庫已關閉                                                                                            | 洽組織管理員或 MaiAgent 窗口確認檔案庫開通狀態，或把匯入目的地改回知識庫                                                                                                                                     |
| 部分頁面未寫入，原因是「超過單檔大小上限」                              | 該頁內容超過檔案庫的單檔大小上限                                                                                     | 其餘頁面照常寫入，這一頁不會存進工作區；詳情頁的「未寫入的頁面」會列出它的網址                                                                                                                                       |
| 寫入中途停止，原因是「儲存空間不足」                                 | 組織的儲存空間已用完                                                                                           | 已寫入的檔案會保留。清理檔案庫中不需要的檔案（例如舊的執行資料夾）後，再執行一次                                                                                                                                      |
| 爬取成功，但匯入知識庫失敗                                      | 個別頁面在匯入時處理失敗                                                                                         | 在「頁面爬取請求」列表點 <mark style="color:blue;">檢視</mark> 開啟 <mark style="color:blue;">失敗匯入紀錄</mark>，選擇知識庫後查看每一頁的 <mark style="color:blue;">失敗原因</mark>，再用 [手動匯入](#manual-import) 重新匯入 |

爬取狀態為 <mark style="color:blue;">失敗</mark> 的請求，可在「頁面爬取請求」列表點該筆操作欄的 <mark style="color:blue;">失敗原因</mark> 查看系統記下的原因（操作欄在列表最右側，沒出現在畫面上時，請把列表往右捲動）。

### 爬取時間上限 <a href="#crawl-time-limit" id="crawl-time-limit"></a>

每一次爬取從開始抓取網頁起算，最長執行 30 分鐘：

* **30 分鐘內爬完**：照常完成，並依設定自動匯入。
* **跑滿 30 分鐘還沒爬完**：系統停止繼續爬取，以已經爬到的頁面完成這次請求。爬取狀態顯示 <mark style="color:blue;">完成</mark>，有設定自動匯入目標時照常匯入，Credits 依實際爬到的頁數計算。因此頁數可能少於 <mark style="color:blue;">最大爬取頁數</mark>；畫面上不會另外標示這次是被時間上限提前結束，可從已爬取的頁數少於最大爬取頁數來判斷。
* **跑滿 30 分鐘時一頁都還沒爬到**：爬取狀態為 <mark style="color:blue;">失敗</mark>，原因同「爬取已結束，但沒有取得任何頁面」，不扣 Credits。

{% hint style="info" %}
大型網站一次爬不完時，建議用 <mark style="color:blue;">網址比對規則</mark> 把網站拆成幾個範圍（例如 `/products/`、`/faq/` 各建一個爬取請求），讓每一次爬取都能在時間內完成。
{% endhint %}

例如，某公司的知識管理專員設定一次爬取整個官網、最大爬取頁數 1000。爬取跑滿 30 分鐘時只爬到 420 頁，請求以 <mark style="color:blue;">完成</mark> 結束，這 420 頁照常匯入知識庫，Credits 也只算 420 頁。她從 <mark style="color:blue;">已爬取頁面</mark> 確認少了部落格文章，於是另建一個只爬 `/blog/` 的請求補齊。

失敗原因看不出問題，或同一個網址反覆失敗時，請記下爬取請求的名稱與時間，洽 MaiAgent 窗口。

## 爬蟲使用注意事項 <a href="#scraping-considerations" id="scraping-considerations"></a>

* 請確保您有權限爬取目標網站內容
* 爬取、預覽與手動匯入都會消耗 Credits，建議先用較小的最大爬取深度與頁數測試，確認範圍後再擴大
* 爬取完成後可透過[搜尋測試功能](/build/knowledge-base/test-search-result.md)驗證資料品質
* 網站內容經常更新時，建議使用[定期排程](#schedule)保持資訊時效性，並搭配 <mark style="color:blue;">略過</mark> 或 <mark style="color:blue;">覆蓋</mark> 避免重複檔案


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://docs.maiagent.ai/build/knowledge-base/scrape-website.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.