> For the complete documentation index, see [llms.txt](https://docs.maiagent.ai/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.maiagent.ai/maiagent-user-guide/ja/serve/voicecs/ivr-intent-recognition.md).

# IVR による問い合わせ意図の認識

IVR カスタマーサポートの意図認識の活用例：お客様が音声で用件を伝えると、Agent が意図を判断して適切なサービスへ案内し、プッシュ式の音声メニューに代わる仕組みを実現します。

**IVR（自動音声応答）カスタマーサポートの意図認識**とは、AI による音声処理技術を組み合わせ、ユーザーが音声コマンドでカスタマーサポートシステムとやり取りし、お客様の発話の意味を自動的に認識して適切なサービスを提供する技術の応用です。台湾では、こうしたシステムが銀行、通信、医療などの分野で広く活用されており、サービス効率と顧客体験の向上に貢献しています。

## **主な機能と流れ** <a href="#core-features-and-workflow" id="core-features-and-workflow"></a>

1. **音声入力の受付**\
   お客様が電話をかけると、システムが自動音声ガイダンスを流します（例：「ご用件を簡単にお話しください。担当者がご案内いたします。」）。お客様はボタンを押して選択する必要はなく、音声で直接用件を伝えます。
2. **音声認識（ASR）**\
   システムは自動音声認識技術（Automatic Speech Recognition）を用いて、音声をテキストに変換します。たとえば、お客様が「請求書を確認したい」と話した場合、システムはその内容をテキスト入力に変換します。
3. **意味理解（NLU）**\
   システムは自然言語理解（Natural Language Understanding）技術を用いて意味を分析し、ユーザーの本当のニーズを判断します。例：
   * 語彙分析：「確認」「請求書」といったキーワードから、請求に関するニーズであることがわかります。
   * 意図の識別：お客様の目的が「請求書の確認」であると判断します。
4. **応答とルーティング**\
   システムは意味分析の結果に基づいて、次のようなサービスを提供します。
   * **直接応答**：自動で処理できる用件の場合。例：「ご請求金額は 1,200 元、お支払い期限は 12 月 15 日です。」
   * **オペレーターへの転送**：用件が複雑な場合、システムは該当部門のオペレーターへ自動的に転送し、あわせて内容の要約を提供することで、同じ説明を繰り返す手間を減らします。

## **技術的な課題と制約** <a href="#technical-challenges-and-limitations" id="technical-challenges-and-limitations"></a>

1. **多様な表現の理解が難しい**
   * ユーザーの言い回しは標準的とは限りません。たとえば「私の請求書はどうなっているの？」や「支払いの問題はどうすればいい？」といった表現はやや曖昧で、BERT などのモデルでは<mark style="color:red;">**具体的なニーズを正確に判定できない**</mark>場合があります。
   * 台湾では、多言語・多方言（華語、台湾語、客家語）が混在するという課題もあり、言語モデルによるこれらの言語データへの対応はまだ十分ではありません。
2. **意図の細分化の限界**
   * 現代の NLP モデルは大量のテキストデータを処理できますが、特定の業界の専門知識や特殊な意図を完全に把握することはできません。たとえば「前回の支払いの具体的な日付を知りたい」という質問に正しく答えるには、複数のシステムとの連携が必要になる場合があります。
   * BERT は短い会話の断片であれば良好な結果を出しますが、長い文や複雑な意味の表現ではモデルが混乱することがあります。
3. **データの偏りとコーパスの不足**
   * 言語モデルの学習には<mark style="color:red;">**大規模なローカライズされたコーパスが必要**</mark>です。データが不足していたり、単一の表現形式に偏っていたりすると、特殊な文脈への適応力が不十分になります。たとえば、台湾特有の言い回しである「儲值（チャージ）」や「跳號碼（番号飛ばし）」などについて、モデルが十分な文脈コーパスを持っていない可能性があります。
4. **文脈と記憶の制約**
   * お客様との会話には通常、文脈上の関連性があります。たとえば「先ほどの支払いについて、ほかにも質問があります」のようなマルチターン会話では、システムが以前の意図を記憶している必要があります。既存の NLP モデルは、この点での性能が限定的です。
   * 意図の判定を誤ると、ユーザーは用件を言い直さなければならず、不満につながります。
5. **誤りへの許容度が低い**
   * お客様のカスタマーサポートシステムに対する我慢には限りがあります。音声システムが誤判定すると、お客様は不満を感じ、最終的にはオペレーターとの直接の会話を求めてしまいます。

## 業界の現状 <a href="#industry-status-quo" id="industry-status-quo"></a>

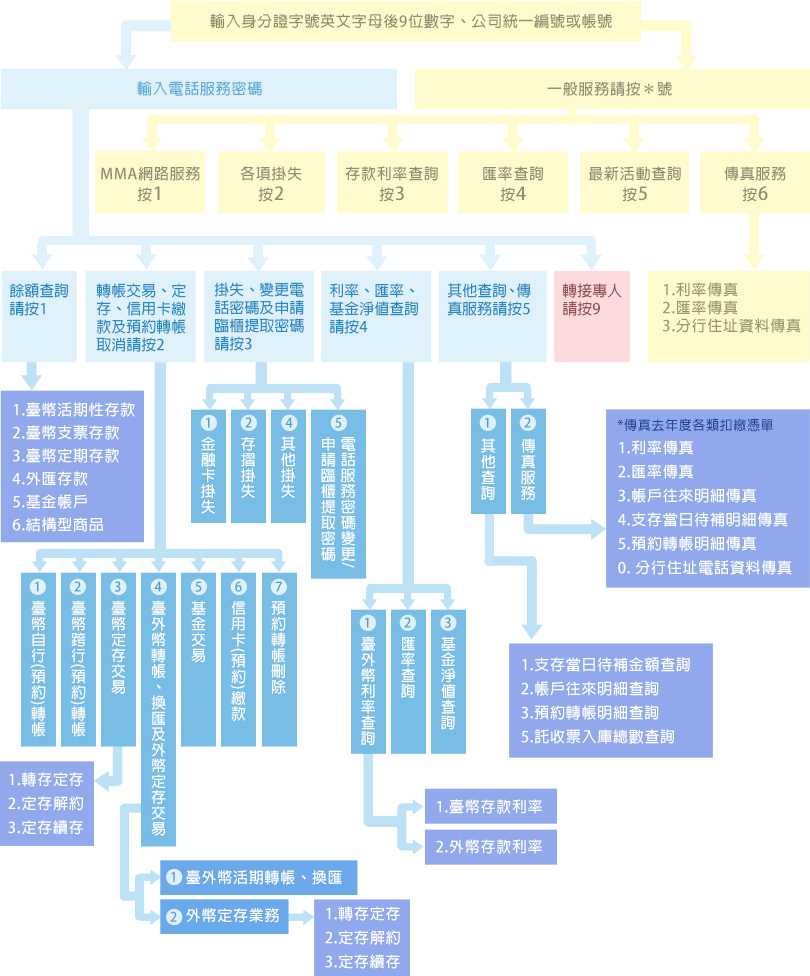
現在も、多くの企業の音声カスタマーサポートシステムは、従来のプッシュ式の選択フローを採用しています。**永豊銀行（SinoPac Bank）の音声カスタマーサポートシステム**を例にすると、業務の多様性を十分に考慮し、多階層のメニューでユーザーを案内する設計になっています。しかし、ユーザーの操作体験には、最適化・改善できる余地がまだ多く残されています。

LLM（大規模言語モデル）と RAG（検索拡張生成、Retrieval-Augmented Generation）の登場は、意味認識と IVR システム全体に革新的な変化をもたらしました。音声カスタマーサポートシステムはよりインテリジェントで、より正確で、より適応力の高いものとなり、従来の NLP 技術が抱えていた多くの制約を克服しています。

{% embed url="<https://bank.sinopac.com/MMA8/bank/service/cs-phonecall.html>" %}

<figure><img src="https://2584873290-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FTvHx8hgwYGDTLD3A7xoW%2Fuploads%2Fgit-blob-f74eb3f1cbee204c4d67bbd4a0f7abdc1e2a9776%2Fimage%20(6)%20(1).png?alt=media" alt="" width="563"><figcaption></figcaption></figure>

## ソリューション <a href="#solution" id="solution"></a>

ここからは、MaiAgent の強力で高精度な LLM と RAG 機能を使って、優れた意味認識アシスタントを作る手順をステップごとにご紹介します。

### 操作手順 <a href="#operation-steps" id="operation-steps"></a>

#### 1. データの準備 <a href="#step1-data-preparation" id="step1-data-preparation"></a>

{% hint style="info" %}
従来、BERT で意図認識や感情分析などの NLP タスクを行うには、学習用に大量のラベル付きデータが必要でした。ラベル付きデータは通常、人手で作成されます。たとえば、文に意図のカテゴリやキーワードを付与する作業は、時間もコストもかかります。高品質なラベル付きデータがあっても、モデルの汎化能力が不足することがあります。業務要件や利用習慣が変わると、データを再度ラベル付けしてモデルを再学習する必要があり、サイクルが長くなります。

LLM と RAG の強みは、生成型の言語能力とリアルタイム検索の動的な性質を十分に組み合わせられる点にあります。ラベル付きデータへの依存から脱却し、意味認識の精度を高め、開発・保守コストを下げ、ユーザー体験を大きく向上させます。この技術の組み合わせは、インテリジェントなカスタマーサポートと音声インタラクションに新たな業界標準を打ち立てるもので、今後の自動化とパーソナライズされたサービスを推進する重要な要素です。
{% endhint %}

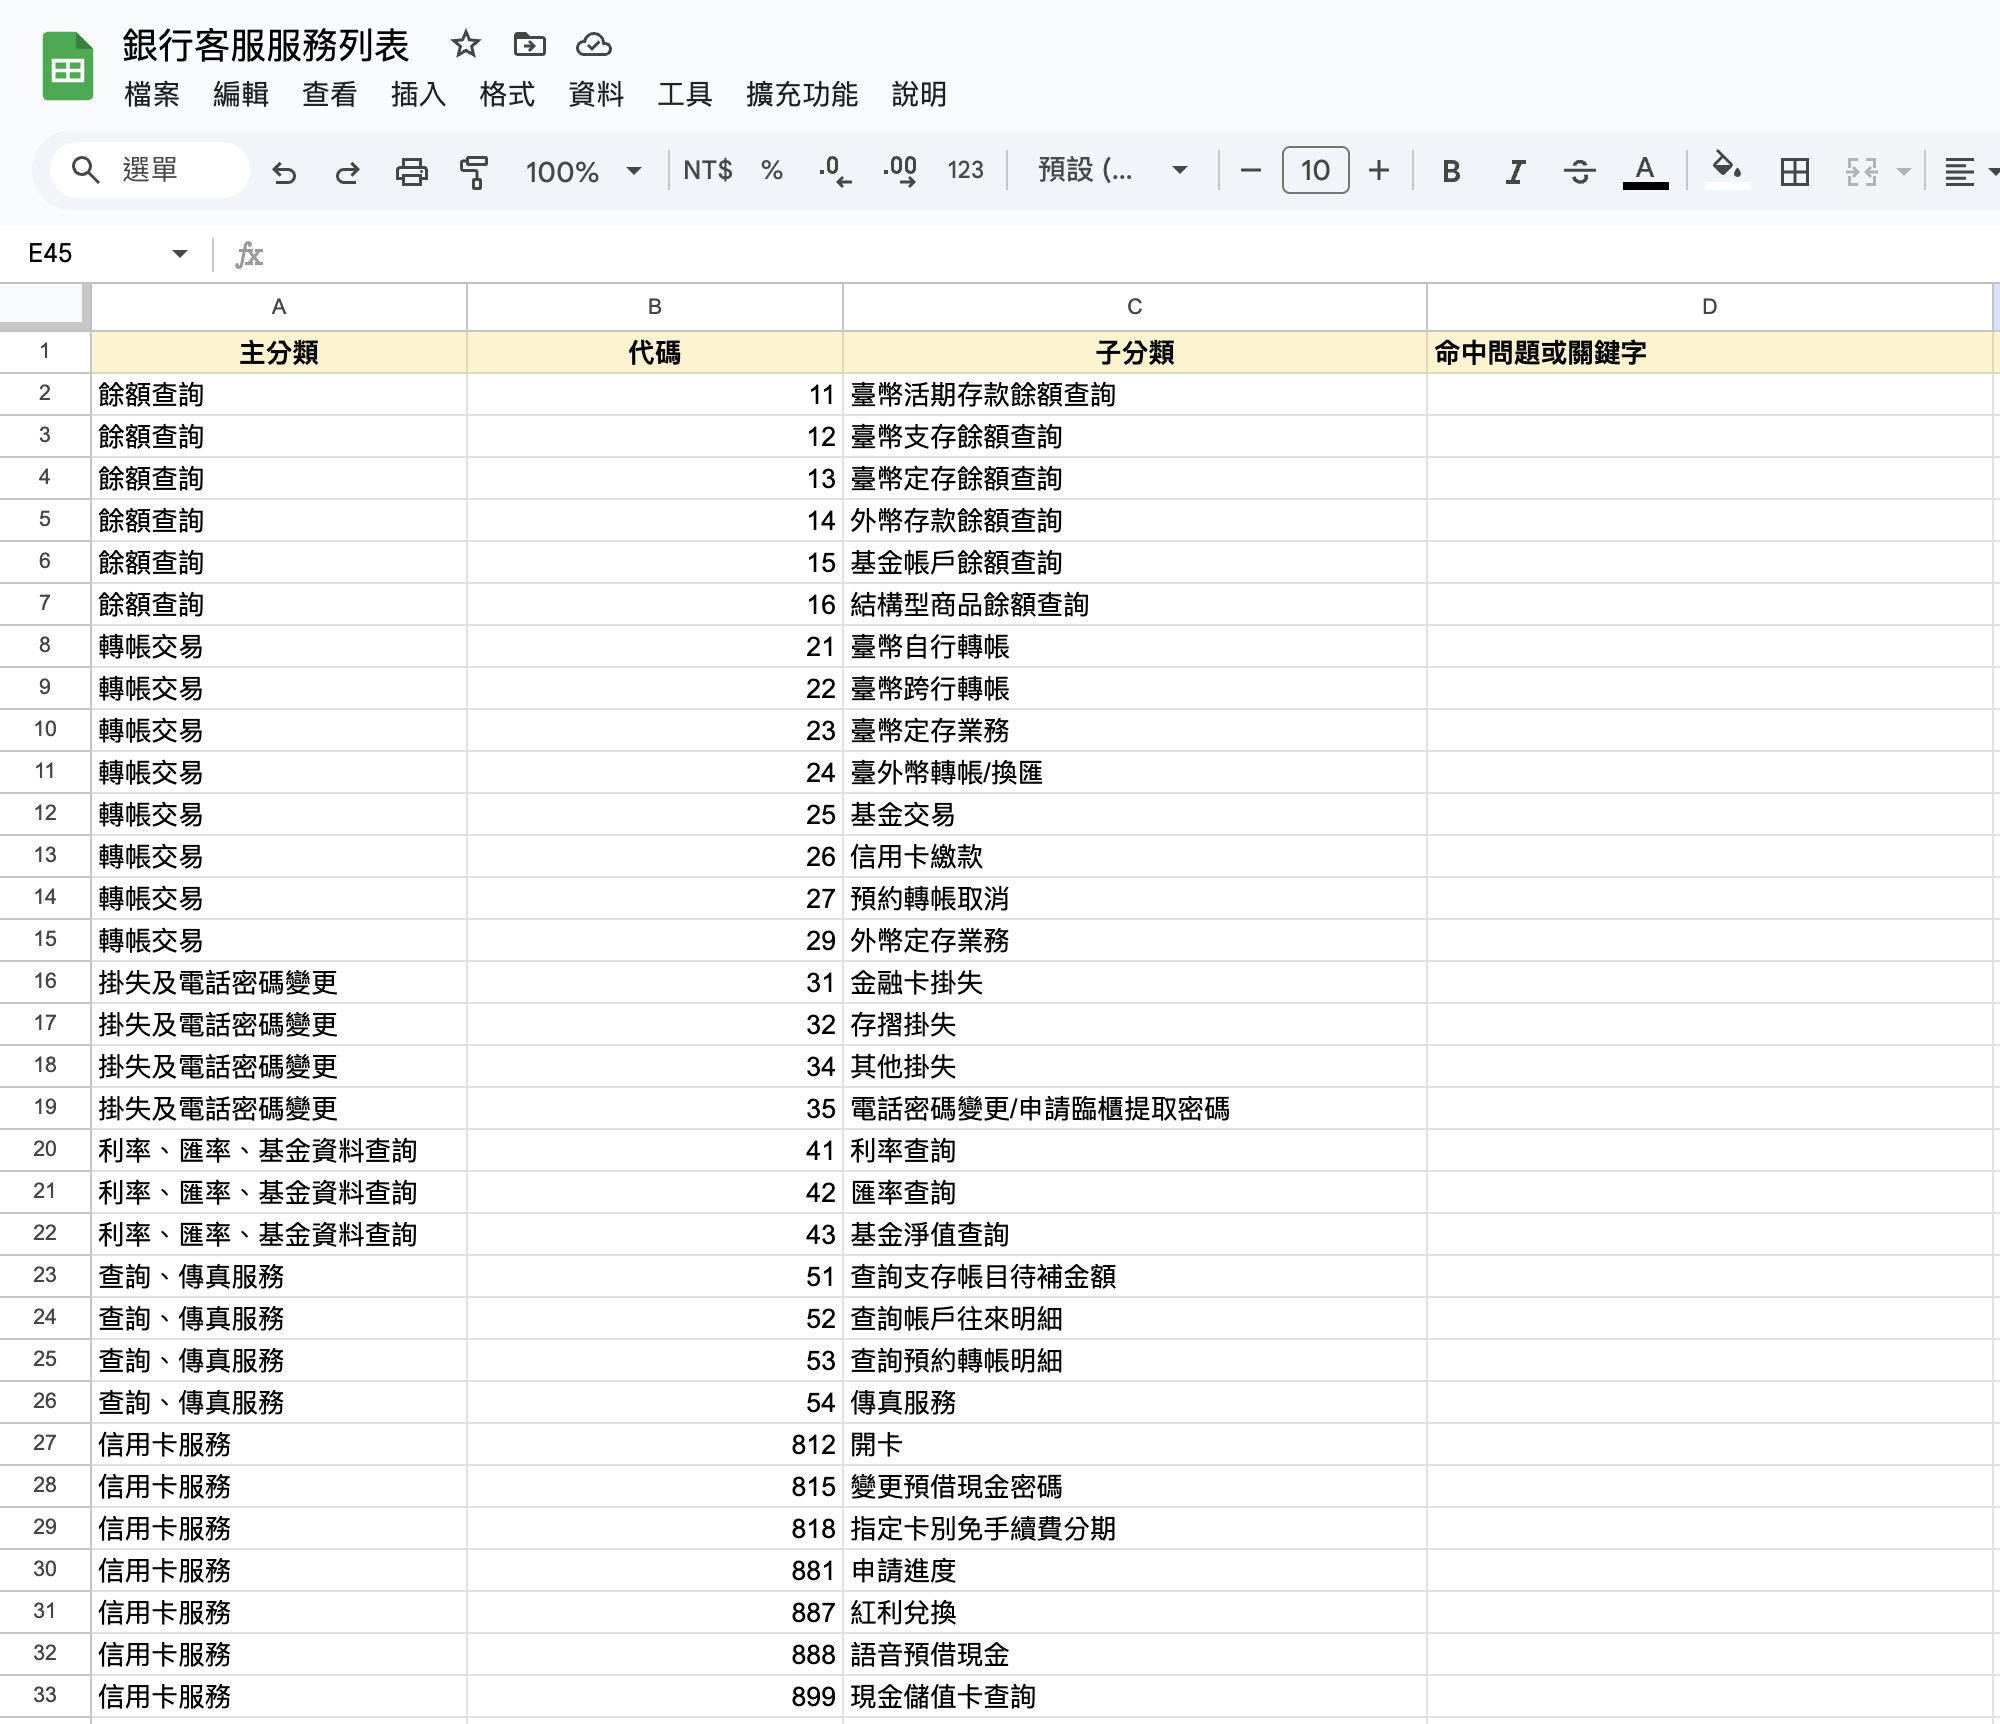
LLM と RAG の導入により、ラベル付きデータの準備作業は大幅に簡素化されました。現在は、データを Excel の表に整理して意図の分類を簡単に列挙し、この**銀行カスタマーサポートサービス一覧**を Agent のナレッジベースにアップロードするだけで、インテリジェントな意味認識システムを動かせます。

<figure><img src="https://2584873290-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FTvHx8hgwYGDTLD3A7xoW%2Fuploads%2Fgit-blob-b51c7052b561e2da03555b7a46e2cd7362bd876e%2F%E6%88%AA%E5%9C%96%202024-12-02%20%E6%99%9A%E4%B8%8A11.14.49.png?alt=media" alt=""><figcaption><p>銀行サービス一覧（意図認識用）</p></figcaption></figure>

#### **2. ロール指示の定義** <a href="#step2-define-system-prompt" id="step2-define-system-prompt"></a>

```markdown
# ロール
あなたは MaiAgent 銀行の意味理解ボットです

# 出力形式
ユーザーとの会話から、お客様が求めているサービスの意図を理解し、ナレッジベースの中からユーザーが求めているサービスの意図を判断して出力してください

意図が明確な場合は、意図を 1 つだけ出力してください。似ている意図が複数あって判断できない場合は、最も近い意図を 3 つ以内で列挙してください

<example>
-<コード>:<分類> - <サブ分類>
</example>

<example>
-<コード>:<分類> - <サブ分類>
...
</example>

<example>
N/A
</example>

# 出力の制限
- 繁体字中国語で返信してください
- ナレッジベースの範囲外の情報には回答しないでください
- <example> と </example> の中の文章をそのまま出力し、その他の説明は含めないでください
- 出力には <example> と </example> を含めないでください
- ナレッジベースの情報に基づいて回答し、意図を判断できない場合は、下記の <example> 内の文章で回答してください
```

#### 3. 使ってみる <a href="#step3-get-started" id="step3-get-started"></a>

### 利用例 <a href="#usage-examples" id="usage-examples"></a>

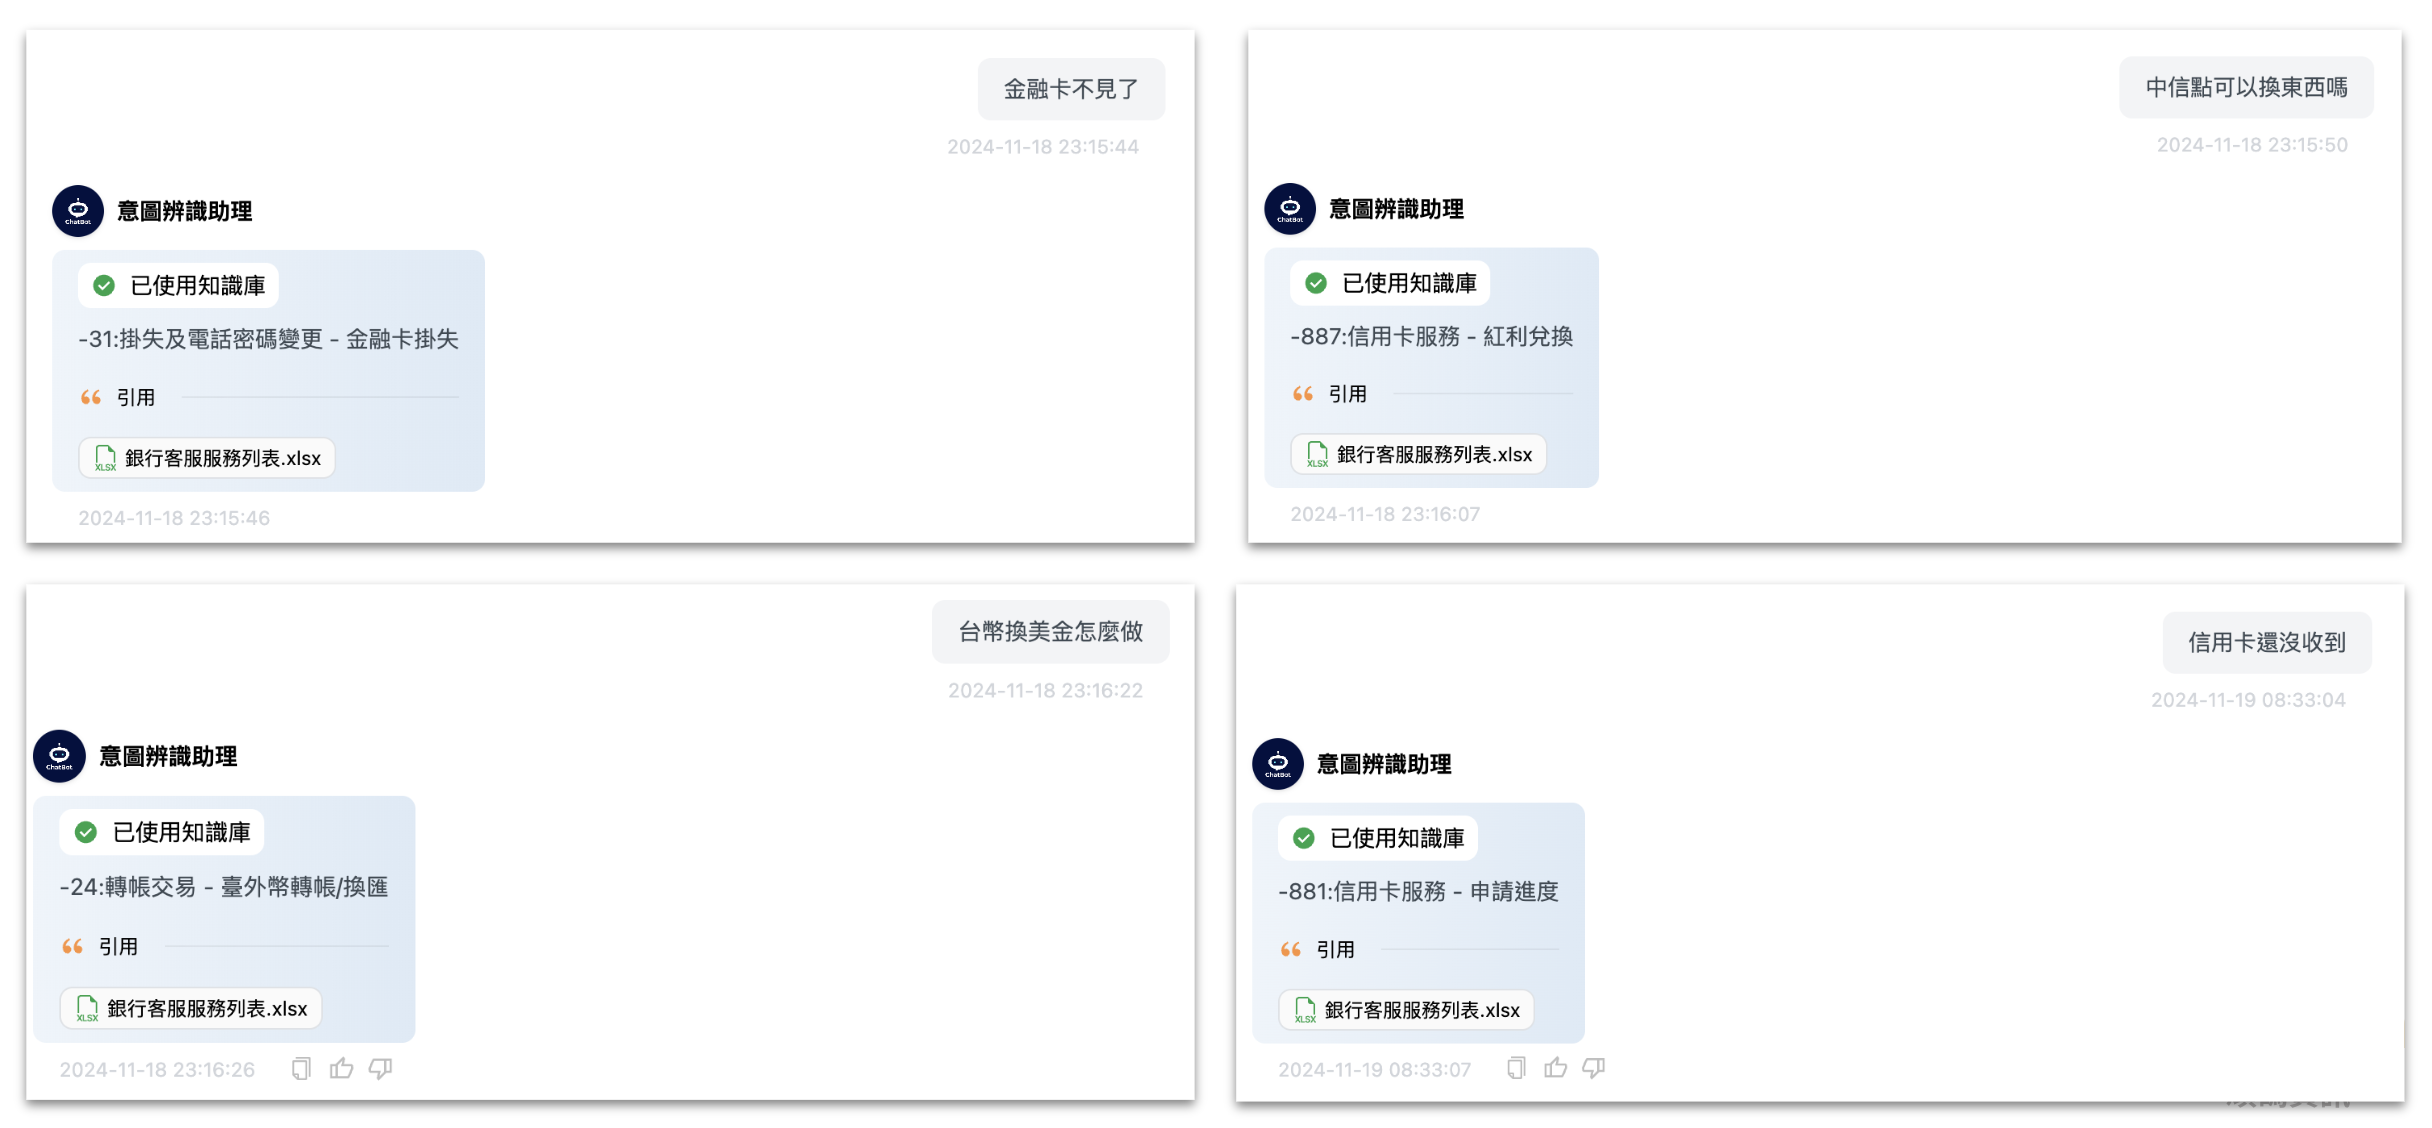
#### 単発の会話 <a href="#single-turn-conversation" id="single-turn-conversation"></a>

<figure><img src="https://2584873290-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FTvHx8hgwYGDTLD3A7xoW%2Fuploads%2Fgit-blob-910668dec14fc1c02eb38cd458210fdf5ab90f69%2F%E6%88%AA%E5%9C%96%202024-12-03%20%E5%87%8C%E6%99%A812.29.05.png?alt=media" alt=""><figcaption><p>意図認識の事例</p></figcaption></figure>

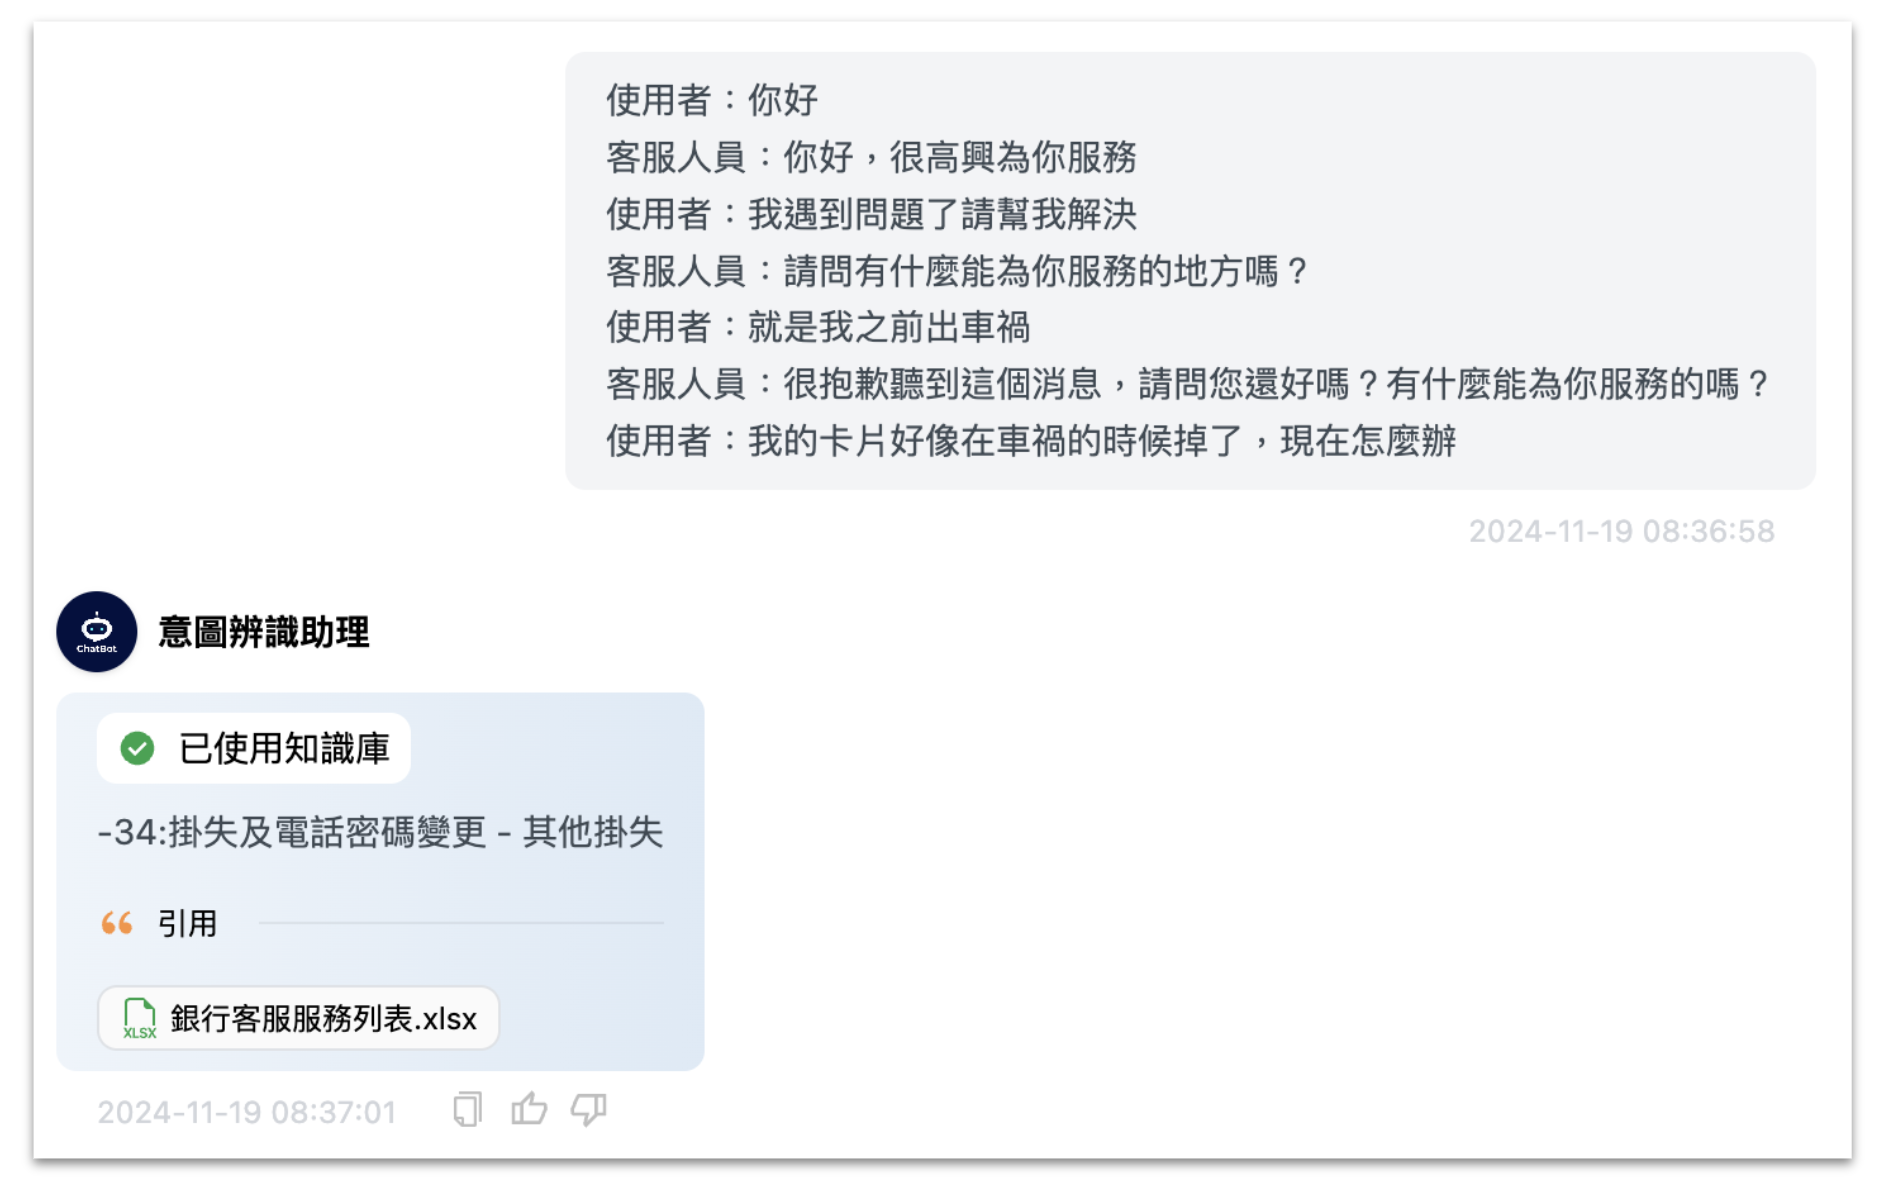
#### マルチターン会話 <a href="#multi-turn-conversation" id="multi-turn-conversation"></a>

LLM と RAG の技術により、BERT ではマルチターン会話で意図を認識しにくいという課題が解決されました。

<figure><img src="https://2584873290-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FTvHx8hgwYGDTLD3A7xoW%2Fuploads%2Fgit-blob-cec0212cfd074e95697d756eef976f3231d7ff35%2F%E6%88%AA%E5%9C%96%202024-12-03%20%E5%87%8C%E6%99%A812.29.53.png?alt=media" alt=""><figcaption><p>意図認識のマルチターン会話の例</p></figcaption></figure>


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://docs.maiagent.ai/maiagent-user-guide/ja/serve/voicecs/ivr-intent-recognition.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.