> For the complete documentation index, see [llms.txt](https://docs.maiagent.ai/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.maiagent.ai/maiagent-user-guide/ja/agent-ops/evaluations.md).

# 自動評価と AI アシスタントの監視

AI アシスタントの応答品質、パフォーマンス指標、コストを自動テストおよびリアルタイムで監視します

## 自動評価 <a href="#auto-evaluation" id="auto-evaluation"></a>

自動評価機能では、あらかじめ作成したテストデータセットを使用して、AI アシスタントの応答品質を自動的にテストできます。システムはテスト質問を AI アシスタントに送信し、実際の応答と期待される応答を照合して、詳細な評価レポートを生成します。

### 自動評価へのアクセス <a href="#access-auto-evaluation" id="access-auto-evaluation"></a>

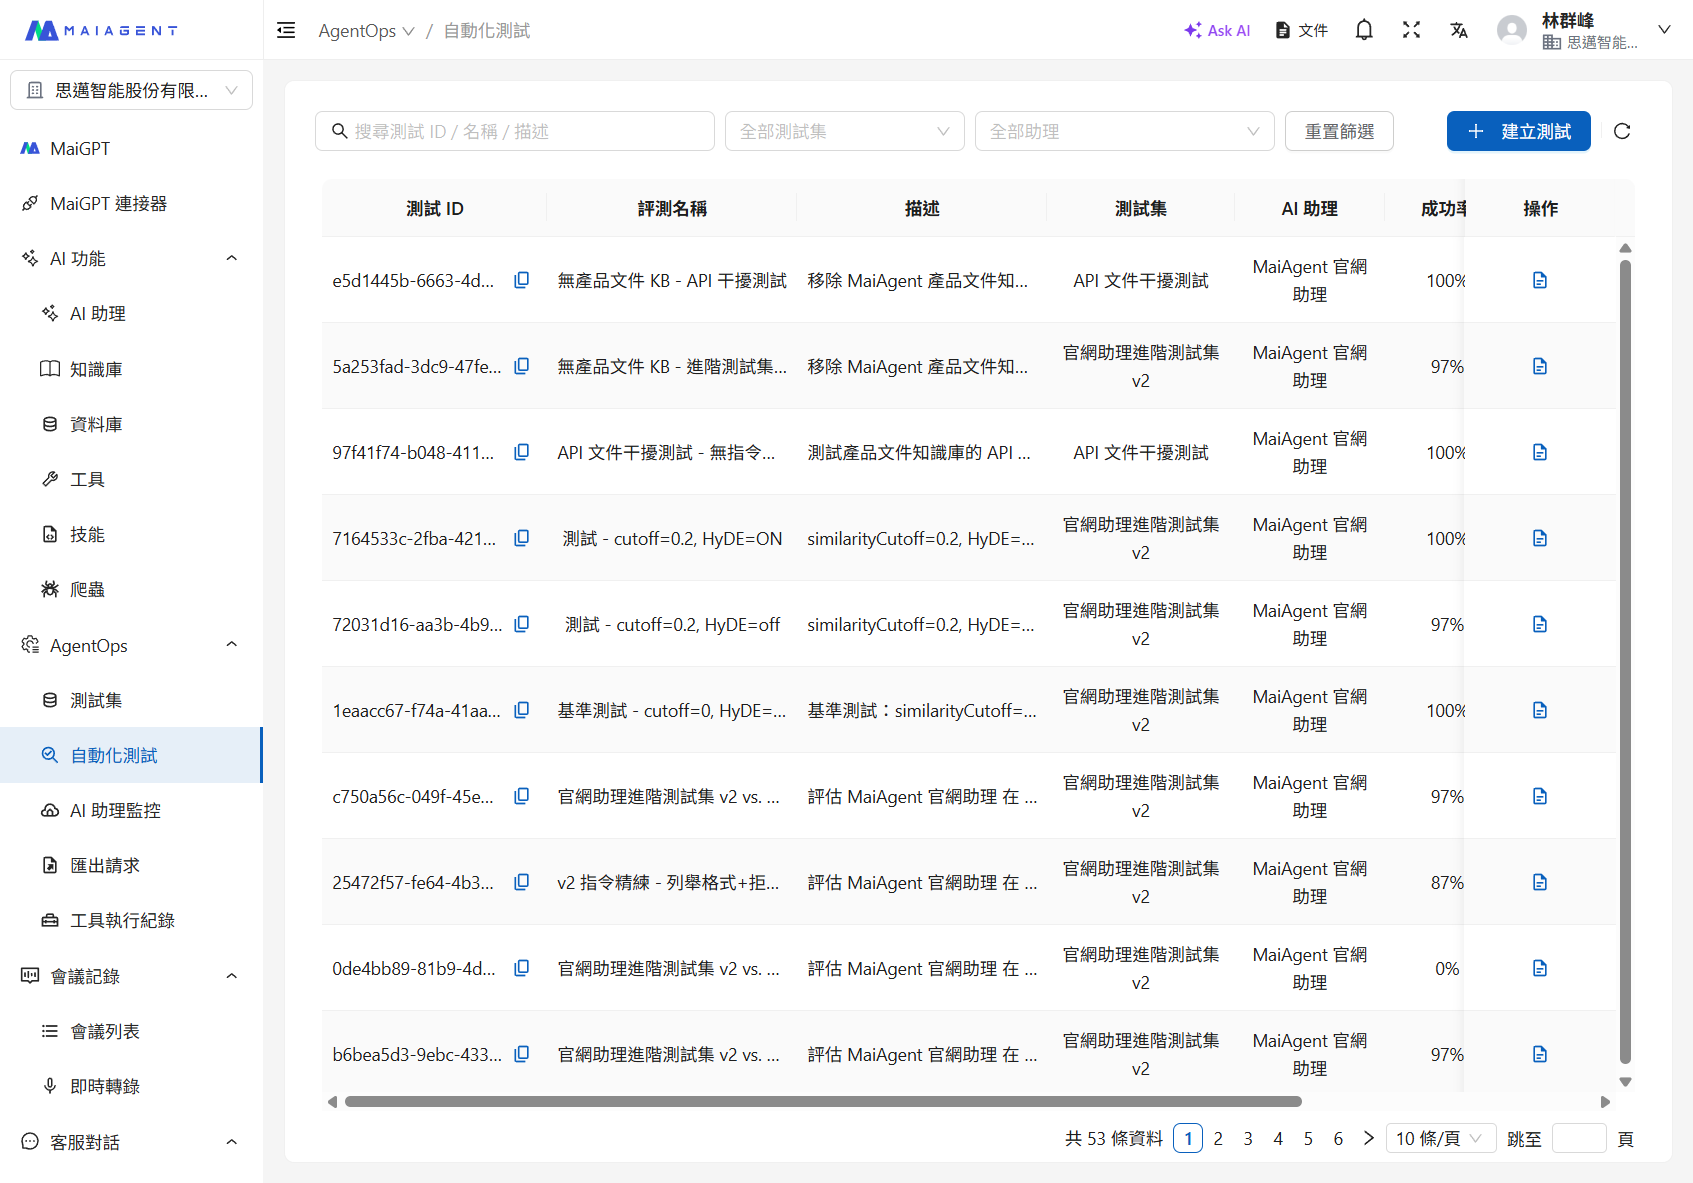
左側のメニューから「<mark style="color:blue;">AgentOps</mark>」に入り、「<mark style="color:blue;">自動テスト</mark>」をクリックします。

<figure><img src="https://2584873290-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FTvHx8hgwYGDTLD3A7xoW%2Fuploads%2Fgit-blob-06f0a8f71a921e02e030b8b8e71bc49977fc7154%2Fagentops-evaluations.png?alt=media" alt="自動テスト一覧"><figcaption><p>自動テスト一覧。各テストの成功率と平均応答秒数を表示します</p></figcaption></figure>

このページには、評価名、テストセット、AI アシスタント、成功率、平均秒数、作成日時を含むすべての評価記録が表示されます。

### テストの作成と実行 <a href="#create-and-run-test" id="create-and-run-test"></a>

1. テストデータセットが作成済みであることを確認します（[テストデータセット管理](/maiagent-user-guide/ja/agent-ops/test-datasets.md)を参照）
2. 「<mark style="color:blue;">テストを作成</mark>」ボタンをクリックします
3. 評価名と説明を入力し、テストデータセットと AI アシスタントを選択します
4. 「<mark style="color:blue;">評価を開始</mark>」をクリックすると、システムがすべてのテストケースを自動的に実行します

{% hint style="info" %}
評価の実行時間はテストケースの数によって異なり、通常 50 件のテストケースで約 2〜3 分かかります。
{% endhint %}

### カスタム評価指標を使用する <a href="#custom-evaluation-metrics" id="custom-evaluation-metrics"></a>

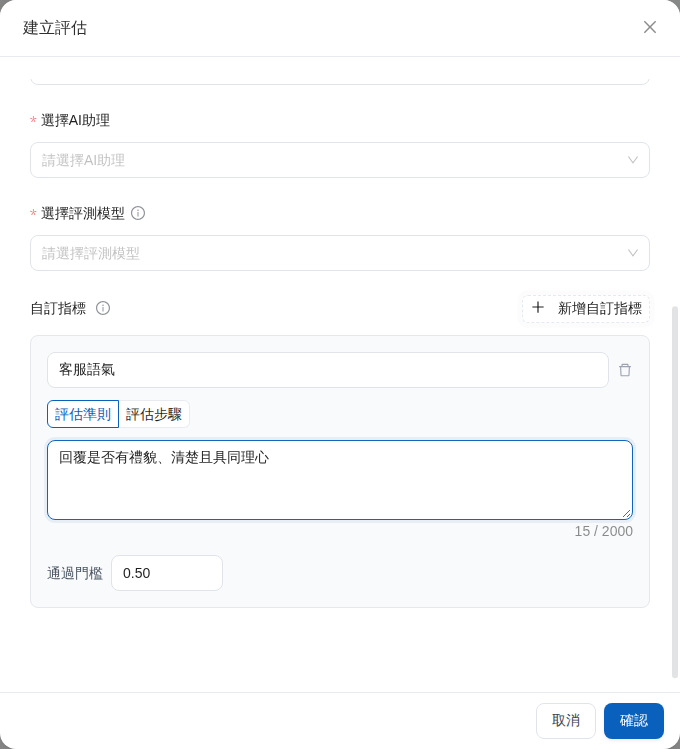
組み込み指標に加えて、自然言語を使用してチーム独自の評価基準を定義できます。たとえば、カスタマーサポート責任者の Mai は、カスタマーサポートアシスタントが礼儀正しく共感的に対応しているかを確認したいと考えています。そこで「カスタマーサポートの口調」という指標を作成し、判定基準を入力して合格しきい値を設定します。評価が完了すると、結果で各ケースの「カスタマーサポートの口調」スコアを確認し、調整が必要な応答を特定できます。

{% stepper %}
{% step %}
評価を作成する際に、名前、テストセット、AI アシスタント、評価モデルなどの基本設定を完了します。
{% endstep %}

{% step %}
「<mark style="color:blue;">カスタム指標</mark>」セクションで「<mark style="color:blue;">カスタム指標を追加</mark>」をクリックし、識別しやすい指標名と評価基準を入力します。
{% endstep %}

{% step %}
チームの品質基準に応じて合格しきい値を調整し、「<mark style="color:blue;">確認</mark>」をクリックして評価を開始します。
{% endstep %}
{% endstepper %}

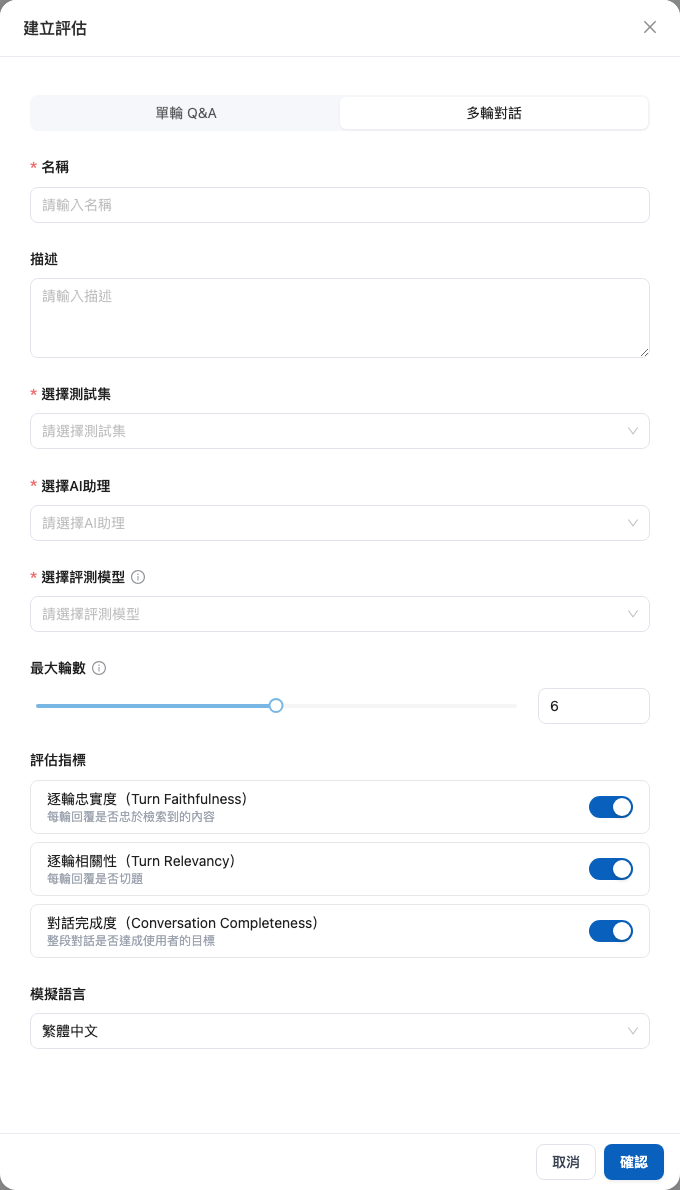
<figure><img src="https://2584873290-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FTvHx8hgwYGDTLD3A7xoW%2Fuploads%2Fgit-blob-43ed547b1eec12101661f11efa05ddfa646c6a4d%2Fevaluation-multi-turn-settings.png?alt=media" alt="評価作成画面のマルチターン対話設定"><figcaption><p>マルチターン対話に切り替えると、最大ターン数、3 種類の評価指標、シミュレーション言語を設定できます</p></figcaption></figure>

<figure><img src="https://2584873290-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FTvHx8hgwYGDTLD3A7xoW%2Fuploads%2Fgit-blob-d56c6a2a2384f1f8aab3561aa424ae4364d3f37e%2Fevaluation-custom-metric.png?alt=media" alt="評価作成画面のカスタム指標設定"><figcaption><p>自然言語でカスタマーサポートの口調の評価基準を設定します</p></figcaption></figure>

{% hint style="info" %}
システムは英字の大文字と小文字を区別せずに名前を照合します。カスタム指標には、11 種類の組み込み指標と重複する名前は使用できません。名前が競合する場合は、チームの判定目的を表す名前に変更してください。
{% endhint %}

### マルチターン対話を評価する <a href="#multi-turn-evaluation" id="multi-turn-evaluation"></a>

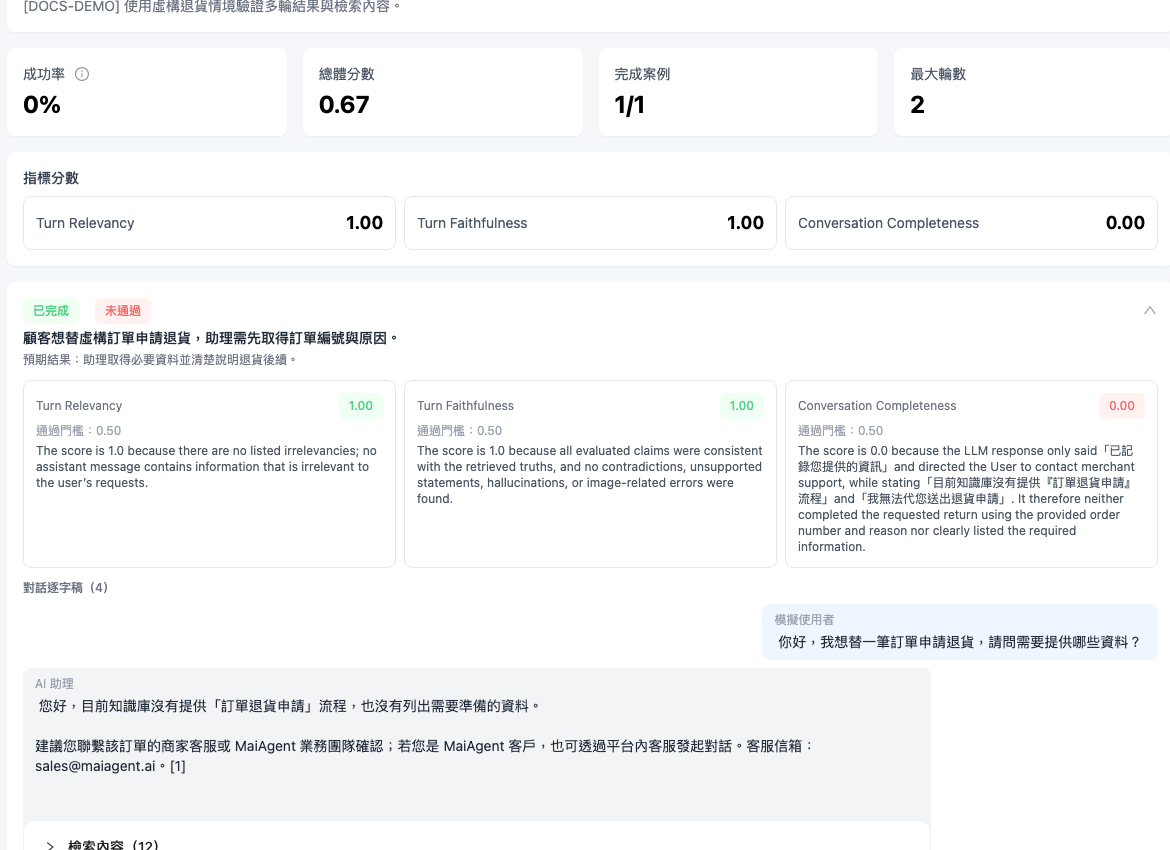
マルチターン評価は、確認のやり取りが必要なタスクのチェックに適しています。返品対応を例にすると、品質管理担当者の Miki は、アシスタントが最初に注文番号を尋ね、次に返品理由を確認して、その後の手続きを説明することを期待しています。そこでマルチターンのテストケースを作成し、シナリオと期待される結果を入力して評価を実行します。完了後は、最後の回答だけでなく対話記録を展開し、各ターンの応答とナレッジベースから取得した内容を確認できます。

{% stepper %}
{% step %}
まず「<mark style="color:blue;">テストセット</mark>」で対象のテストセットを開き、マルチターンのテストケースにシナリオ、期待される結果、シミュレーションユーザーのペルソナを追加します。
{% endstep %}

{% step %}
「<mark style="color:blue;">自動テスト</mark>」に戻って「<mark style="color:blue;">評価を作成</mark>」をクリックし、「<mark style="color:blue;">マルチターン対話</mark>」に切り替えます。
{% endstep %}

{% step %}
テストセット、AI アシスタント、評価モデルを選択し、最大ターン数、評価指標、シミュレーション言語を設定して評価を開始します。少なくとも 1 つの評価指標を有効にする必要があります。
{% endstep %}

{% step %}
評価が完了したら結果を開き、個別のケースをクリックして詳細を展開します。各指標のスコア、対話記録、各ターンの「<mark style="color:blue;">取得内容</mark>」を確認します。個別のケースが失敗した場合、そのケースにはエラーが個別に表示され、ほかのケースの結果が非表示になることはありません。
{% endstep %}
{% endstepper %}

<figure><img src="https://2584873290-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FTvHx8hgwYGDTLD3A7xoW%2Fuploads%2Fgit-blob-123f84448a9ae205a2a7adcc1f96b8a63ceaf02d%2Fevaluation-multi-turn-results.png?alt=media" alt="完了したマルチターン評価のケースを展開したときの指標、対話記録、取得内容"><figcaption><p>ケースを展開すると、各ターンのアシスタントの応答と、そのターンで使用されたナレッジベースの内容を確認できます</p></figcaption></figure>

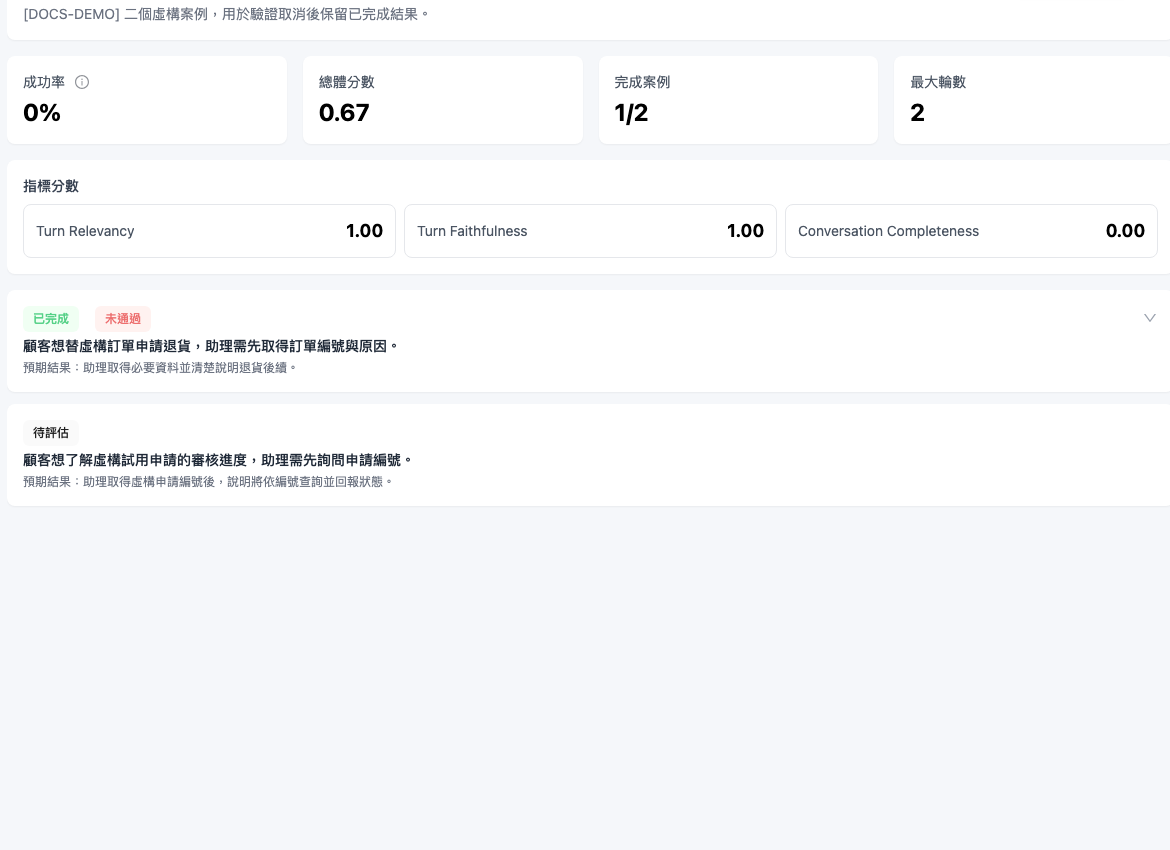
実行中のマルチターン評価を続ける必要がない場合は、評価詳細で「<mark style="color:blue;">評価をキャンセル</mark>」をクリックして確認します。システムは現在のケースの処理完了後に、それ以降のケースを停止します。完了済みのスコアと対話記録は保持され、ステータスは「<mark style="color:blue;">一部完了</mark>」、未処理のケースは「<mark style="color:blue;">評価待ち</mark>」と表示されます。

<figure><img src="https://2584873290-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FTvHx8hgwYGDTLD3A7xoW%2Fuploads%2Fgit-blob-926b7035060aac6e77573489d86fb8297fab864f%2Fevaluation-multi-turn-cancel.png?alt=media" alt="マルチターン評価をキャンセルした後の一部完了ステータス"><figcaption><p>キャンセル後も完了済みのケースは保持され、未処理のケースは評価待ちのままになります</p></figcaption></figure>

### 評価結果の確認 <a href="#view-evaluation-results" id="view-evaluation-results"></a>

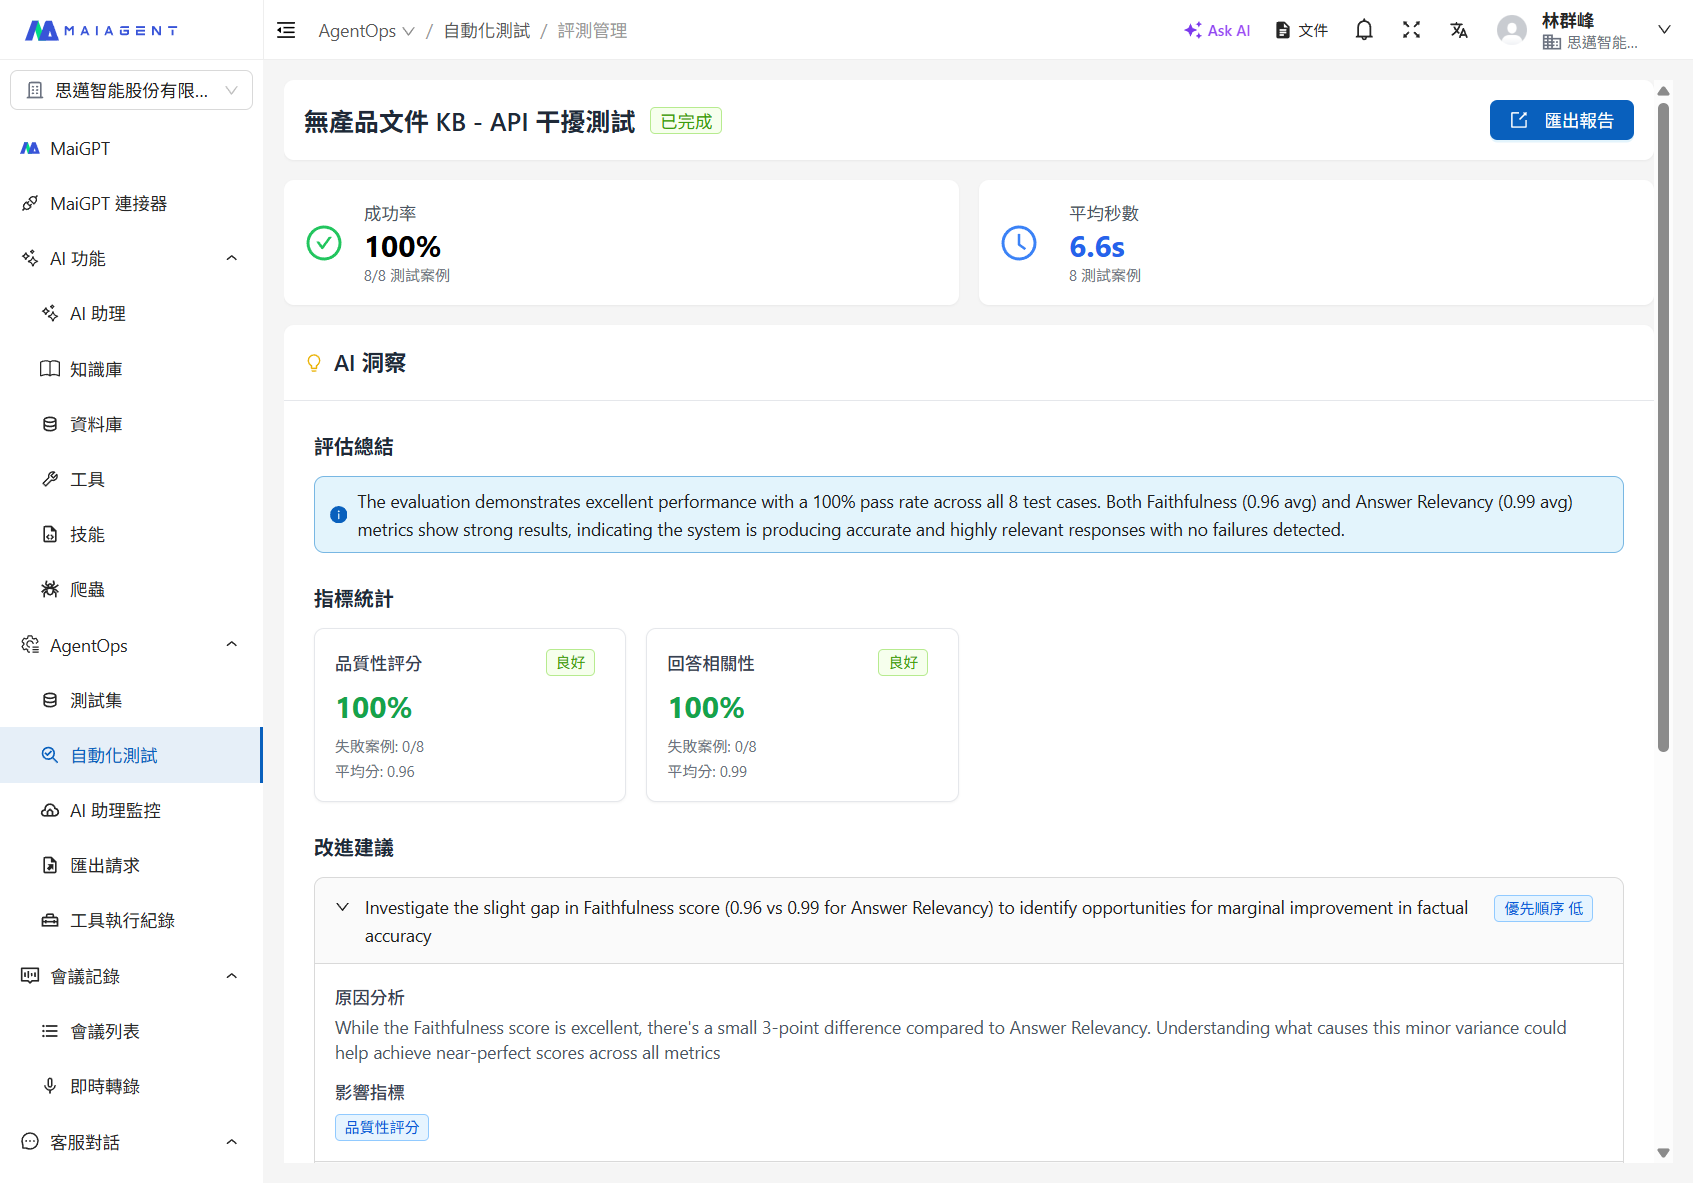
評価記録をクリックすると、詳細レポートを確認できます。

<figure><img src="https://2584873290-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FTvHx8hgwYGDTLD3A7xoW%2Fuploads%2Fgit-blob-aeec25455ae679a86ed97bc0ed49d20cb37e8b24%2Ftrack-evaluation-detail.png?alt=media" alt="評価詳細"><figcaption><p>テスト詳細ページ：成功率、AI インサイト概要、指標統計、改善提案</p></figcaption></figure>

詳細レポートには以下が含まれます。

* **成功率**：テストに合格したケースの割合
* **AI インサイト**：システムが自動分析した評価概要と改善提案
* **指標統計**：品質評価、回答関連性などの指標
* **テストケース明細**：各質問の期待される応答、実際の応答、評価、ステータス

**成功率の参考基準：**

| AI アシスタントの種類    | 推奨成功率 |
| --------------- | ----- |
| 製品照会アシスタント      | ≥ 95% |
| カスタマーサポートアシスタント | ≥ 90% |
| 汎用対話アシスタント      | ≥ 80% |

{% hint style="info" %}
インサイトレポートの詳細については、こちらを参照してください：[評価インサイトレポート](/maiagent-user-guide/ja/agent-ops/evaluation-insights.md)
{% endhint %}

### 評価記録の管理 <a href="#manage-evaluation-records" id="manage-evaluation-records"></a>

* **検索とフィルタリング**：テストセット、AI アシスタント、またはキーワードで記録をフィルタリングします
* **再実行**：ナレッジベースや AI 設定を変更した後、再テストして改善効果を検証します
* **エクスポート**：評価結果を Excel 形式でエクスポートします

#### 評価名と説明の編集 <a href="#edit-evaluation-name-description" id="edit-evaluation-name-description"></a>

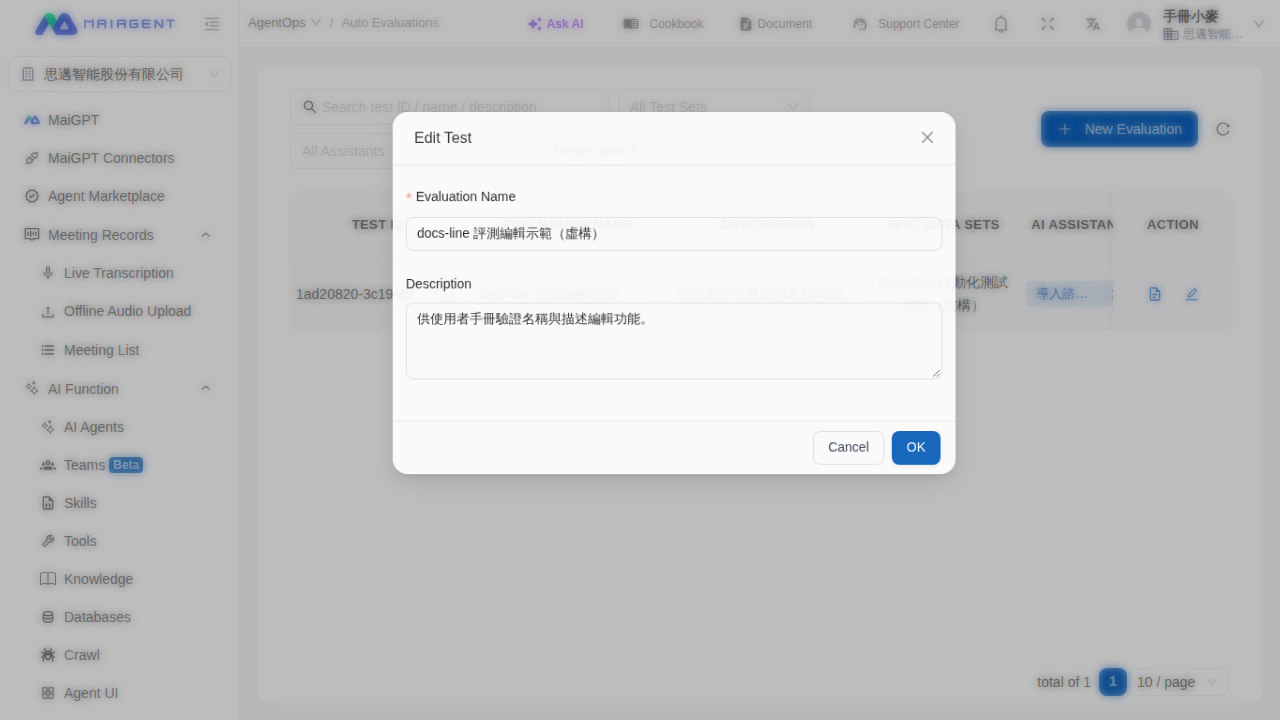
テストの完了後も、テストを削除したり再実行したりせずに、評価名と説明を変更できます。テストデータセット、AI アシスタント、評価結果、実行ステータスは変更されません。

たとえば、Mai が毎週のカスタマーサポート品質テストを作成した後、評価名の週番号に誤りがあることに気づいたとします。自動テスト一覧から編集画面を開き、名前を修正してテストの目的を追記します。保存すると、一覧には新しい内容がすぐに表示され、元のテスト結果もそのまま保持されます。

{% stepper %}
{% step %}

### 自動テスト一覧を開く

左側のメニューから「<mark style="color:blue;">AgentOps</mark>」→「<mark style="color:blue;">自動テスト</mark>」に移動します。
{% endstep %}

{% step %}

### 編集画面を開く

変更する評価を探し、その行の「<mark style="color:blue;">操作</mark>」列にある「<mark style="color:blue;">編集</mark>」アイコンをクリックします。
{% endstep %}

{% step %}

### 変更して保存する

「<mark style="color:blue;">評価名</mark>」または「<mark style="color:blue;">説明</mark>」を変更し、「<mark style="color:blue;">確定</mark>」をクリックします。評価名は必須で、最大 200 文字まで入力できます。説明は空欄でも構いません。
{% endstep %}
{% endstepper %}

<figure><img src="https://2584873290-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FTvHx8hgwYGDTLD3A7xoW%2Fuploads%2Fgit-blob-574e934d25a9ff140f8191df9c4bef52ccbdf9a2%2Fagentops-edit-evaluation.png?alt=media" alt="評価名と説明を変更できる自動テスト一覧のテスト編集画面"><figcaption><p>編集画面には現在の評価名と説明があらかじめ入力されています</p></figcaption></figure>

{% hint style="info" %}
実行中、完了済み、または失敗した評価のいずれも、名前と説明を変更できます。この操作では識別用の情報のみが更新され、テストは再実行されません。
{% endhint %}

***

## AI アシスタント監視 <a href="#ai-agent-monitoring" id="ai-agent-monitoring"></a>

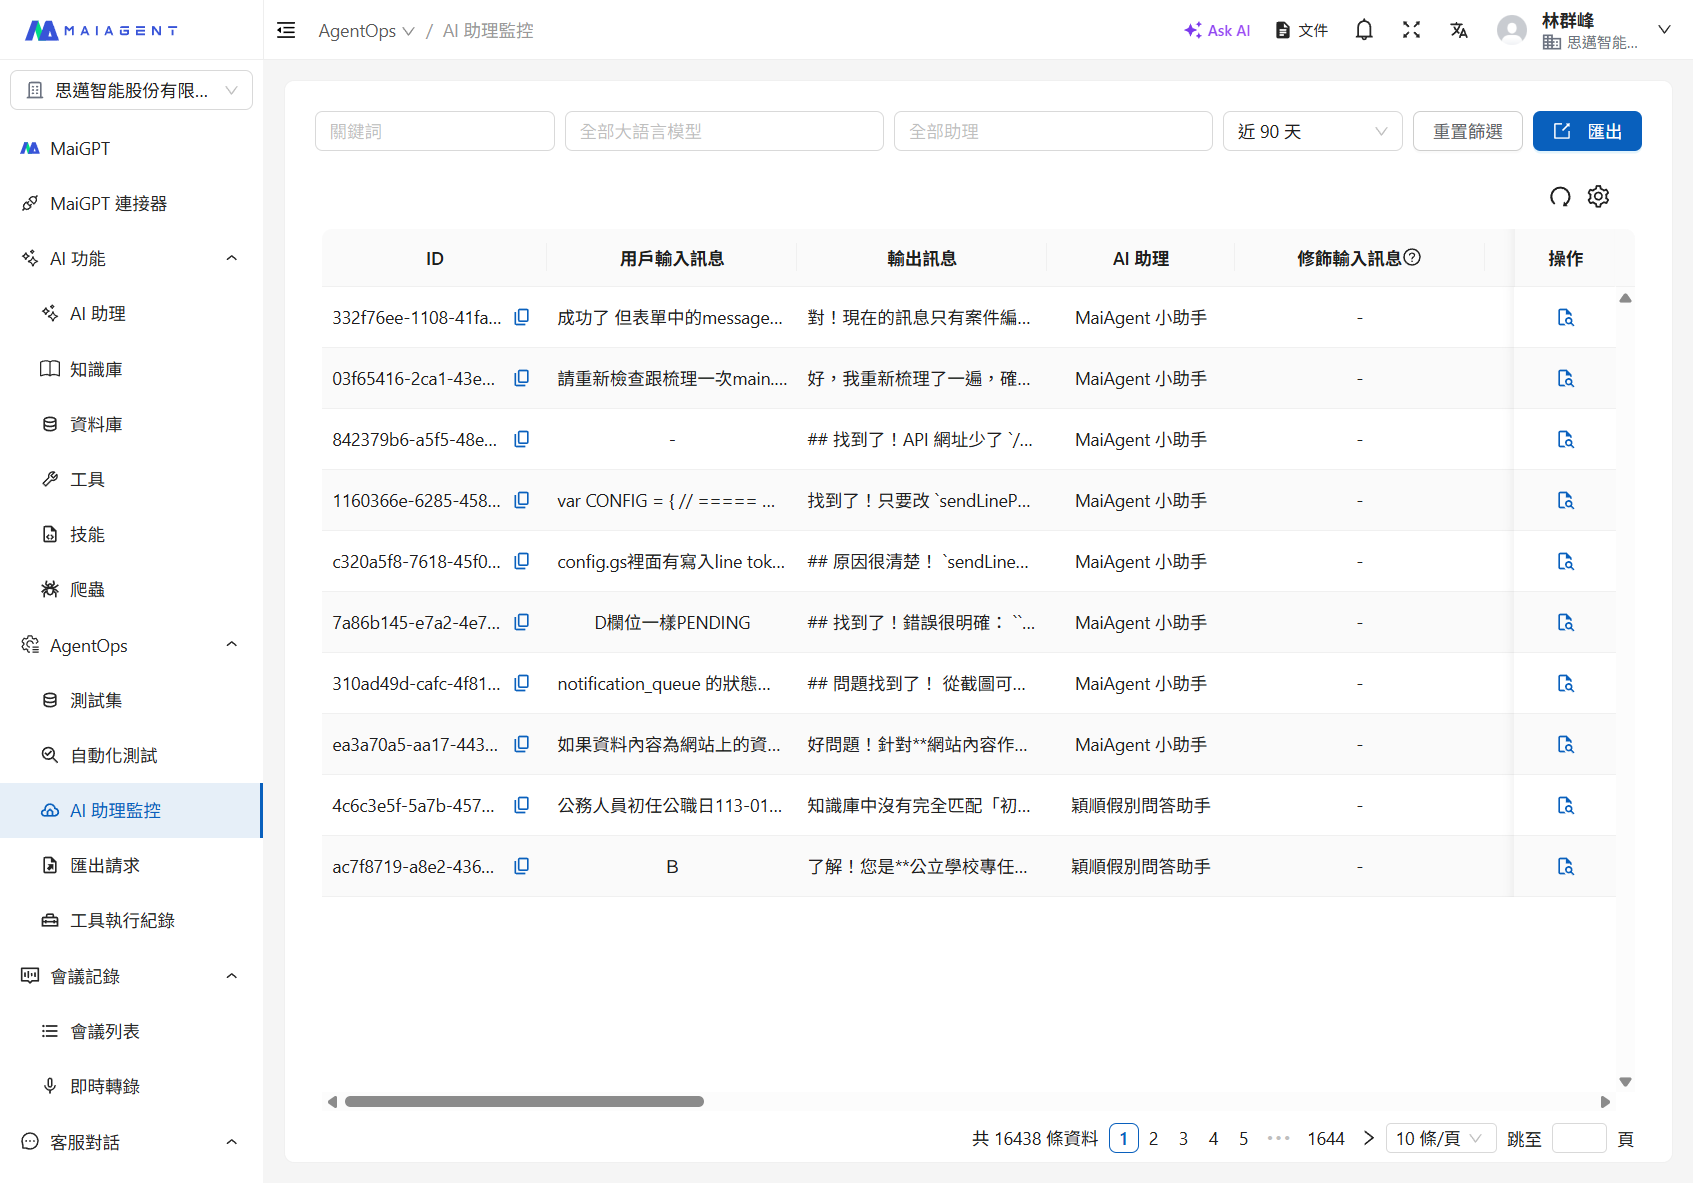
AI アシスタント監視は、リアルタイムの対話運用データを提供し、各対話の処理詳細、パフォーマンス指標、品質評価を詳しく把握できるようにします。

### AI アシスタント監視へのアクセス <a href="#access-ai-agent-monitoring" id="access-ai-agent-monitoring"></a>

左側のメニューから「<mark style="color:blue;">AgentOps</mark>」に入り、「<mark style="color:blue;">AI アシスタント監視</mark>」をクリックします。

<figure><img src="https://2584873290-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FTvHx8hgwYGDTLD3A7xoW%2Fuploads%2Fgit-blob-3cd07b8fa370cc1cc3c44291f6fb6292f29086f5%2Fagentops-monitoring.png?alt=media" alt="AI アシスタント監視"><figcaption><p>AI アシスタント監視画面。各対話の詳細な技術指標を表示します</p></figcaption></figure>

### 監視項目の説明 <a href="#monitoring-field-descriptions" id="monitoring-field-descriptions"></a>

| 項目          | 説明                     |
| ----------- | ---------------------- |
| ユーザー入力メッセージ | ユーザーが AI に送信した質問       |
| 出力メッセージ     | AI アシスタントの応答内容         |
| AI アシスタント   | この対話を処理した AI アシスタントの名前 |
| ユーザーフィードバック | 高評価 👍 または低評価 👎       |
| 誠実性スコア      | 応答がナレッジベースの内容に忠実かどうか   |
| 回答関連性スコア    | 応答と質問の関連度              |
| 応答時間        | AI が応答を生成するまでの全体の時間    |
| LLM 処理推論時間  | LLM の推論と応答生成にかかった時間    |
| 総文字数        | 対話で消費された総文字数（質問と回答を含む） |
| LLM         | 使用した言語モデルの名前           |
| ユーザー        | 対話を開始したユーザー            |

### 画像検索の使用量を確認する <a href="#view-image-search-usage" id="view-image-search-usage"></a>

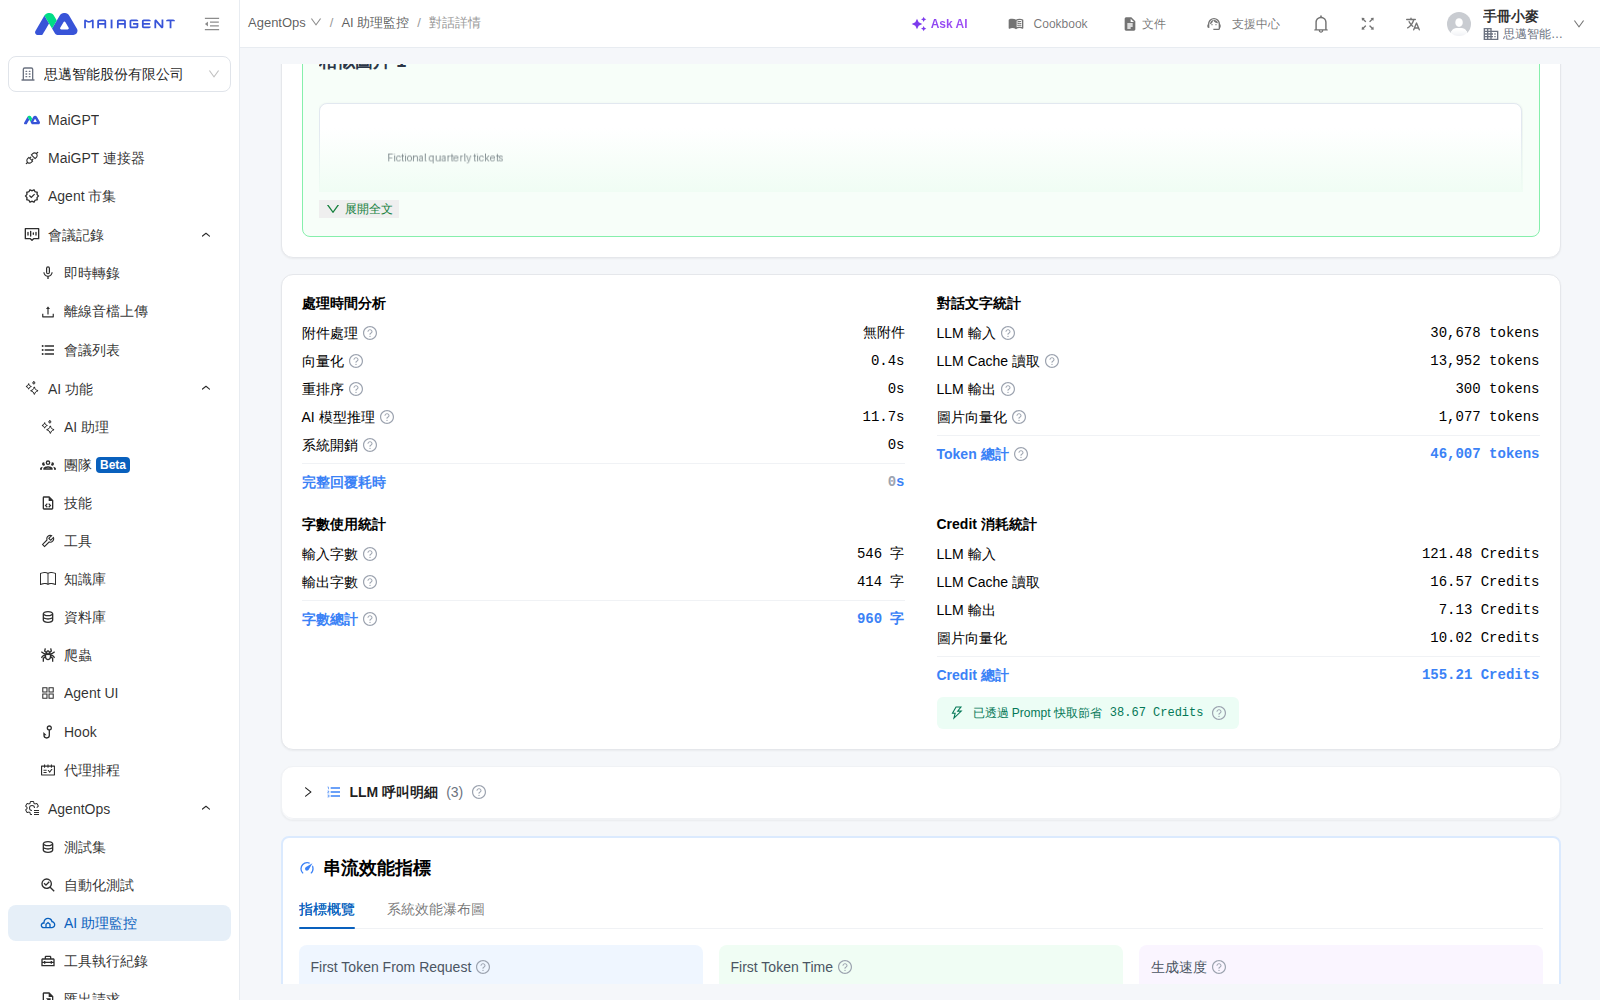
AI アシスタントがナレッジベースの画像検索を使用すると、システムは画像ベクトル化の使用量を別途記録します。個別の対話記録から、その応答で使用されたリソースを確認できます：

{% stepper %}
{% step %} <mark style="color:blue;">AgentOps</mark> → <mark style="color:blue;">AI アシスタント監視</mark>に移動し、<mark style="color:blue;">対話記録</mark>に切り替えます。
{% endstep %}

{% step %}
確認する応答を見つけ、右端の<mark style="color:blue;">詳細情報</mark>をクリックします。
{% endstep %}

{% step %}
下にスクロールして、Token と Credit の内訳を確認します。通常のテキストベクトル化は<mark style="color:blue;">ベクトル化</mark>に表示されます。その応答で画像検索が使用されている場合は、<mark style="color:blue;">画像ベクトル化</mark>も表示され、Token と Credit の合計にもこの項目が含まれます。
{% endstep %}
{% endstepper %}

<figure><img src="https://2584873290-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FTvHx8hgwYGDTLD3A7xoW%2Fuploads%2Fgit-blob-fe269be3872092ab4473c8eb46b0192090b76469%2Fagentops-prod-image-embedding-breakdown.png?alt=media" alt="AI アシスタント監視における個別の対話の使用量と Credit の内訳"><figcaption><p>個別の対話の使用量内訳。「画像ベクトル化」は、応答で画像検索が実際に使用された場合にのみ表示されます</p></figcaption></figure>

{% hint style="info" %} <mark style="color:blue;">画像ベクトル化</mark>が表示されなくても、記録が失われているわけではありません。この項目は、その応答で画像ベクトル化の使用量が実際に発生した場合にのみ表示されます。画像検索が使用されていない場合、画面には従来のベクトル化の内訳が表示されます。
{% endhint %}

たとえば、Mai の会社のカスタマーサポート責任者が、商品アシスタントにカタログ画像から部品の外観を識別させたとします。テスト後にこの対話の詳細情報を開くと、画像ベクトル化と対応する Credits を確認できます。これにより、画像検索と通常のテキスト検索のコストを区別し、画像カタログやアシスタントの設定を調整するかどうかを判断できます。

### 検索とフィルタリング <a href="#search-and-filter" id="search-and-filter"></a>

* **キーワード検索**：入力/出力メッセージまたはユーザー名を検索します
* **LLM フィルタリング**：特定の言語モデルを選択し、異なるモデルのパフォーマンスを比較します
* **AI アシスタントフィルタリング**：特定のアシスタントを選択し、その運用状況を追跡します
* **期間**：直近 7 日間、30 日間、90 日間、またはカスタム日付を選択します
* **エクスポート**：監視データを Excel または CSV 形式でエクスポートします

### ダッシュボード指標とエラー率 <a href="#dashboard-metrics" id="dashboard-metrics"></a>

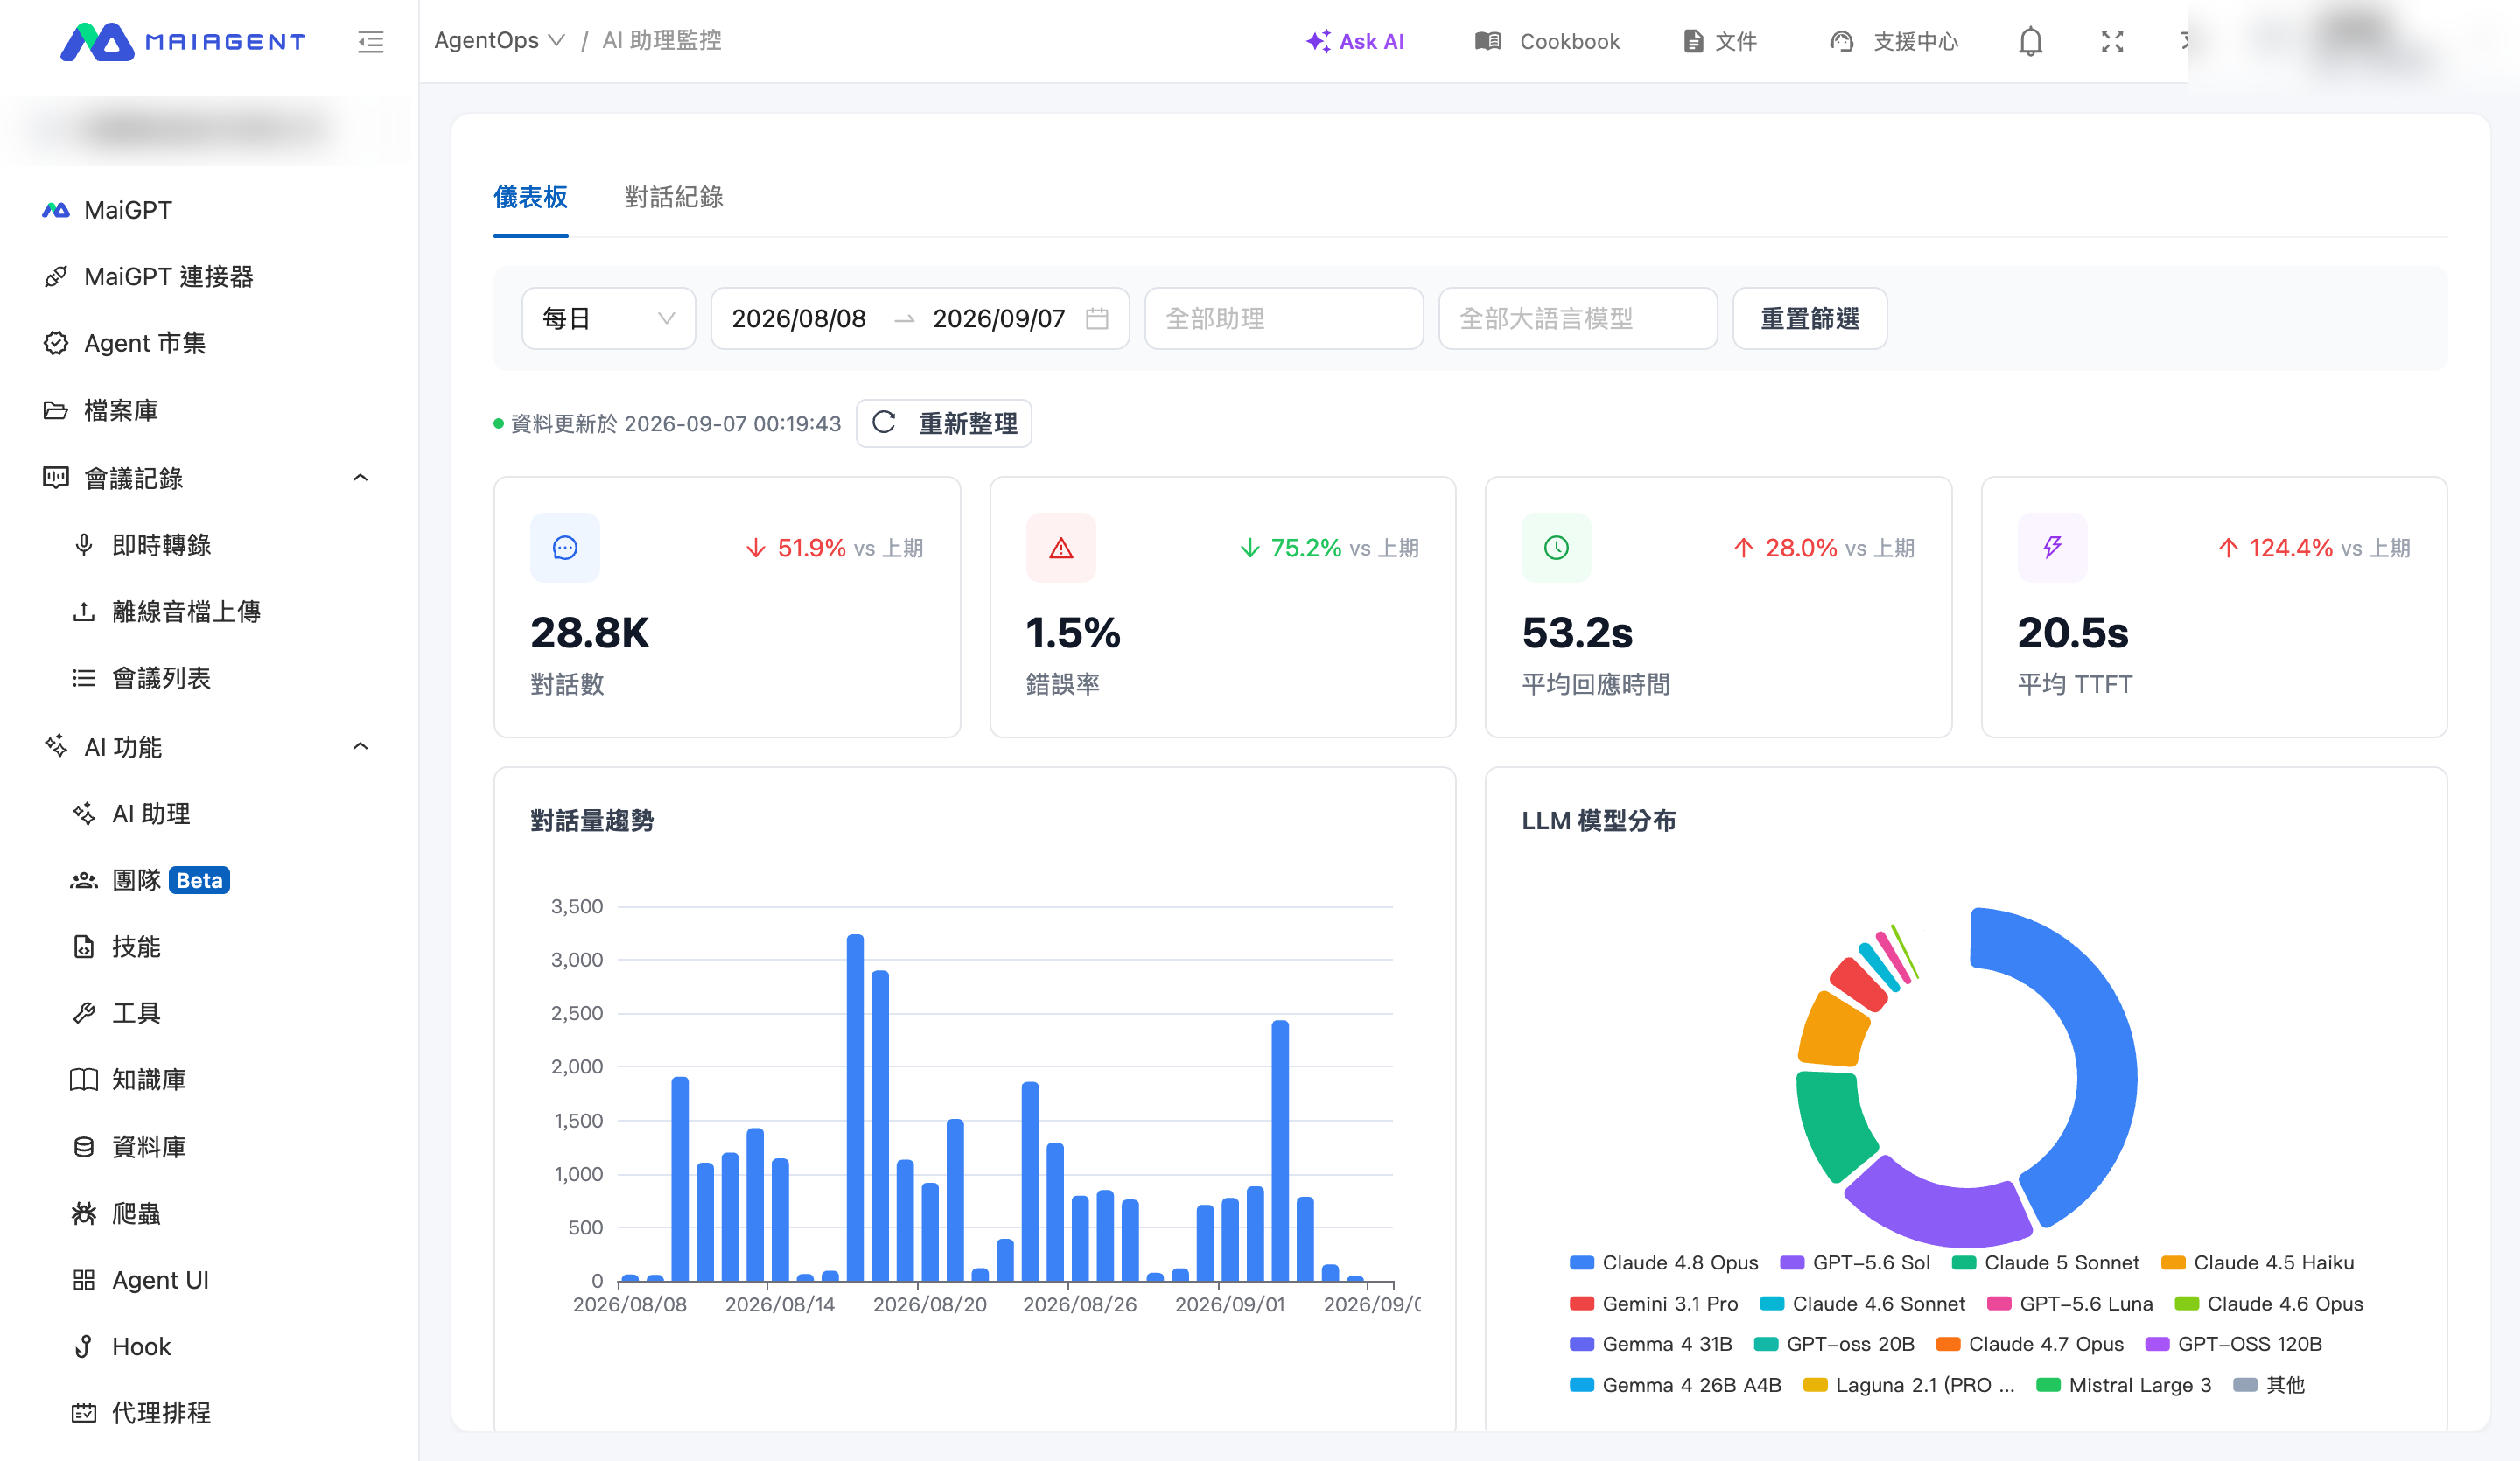
「<mark style="color:blue;">ダッシュボード</mark>」タブに切り替えると、サービス全体の指標と、直前の同じ長さの期間と比較した変化率を確認できます：

| 指標      | 説明                                                                                                                       |
| ------- | ------------------------------------------------------------------------------------------------------------------------ |
| 対話数     | 期間内に AI アシスタントが**応答した回数**です。同じ対話内でも AI が応答したターンごとに 1 回として集計します。有人オペレーターが対応した応答と、スケジュールによる自動実行は集計されません（定義の詳細は以下を参照してください） |
| エラー率    | システムエラーが発生した応答の割合（計算方法は以下を参照）                                                                                            |
| 平均応答時間  | メッセージを受信してから応答が完了するまでの平均時間                                                                                               |
| 平均 TTFT | ユーザーがメッセージを送信してから最初の文字が表示されるまでの平均時間                                                                                      |

対話数、応答時間、エラー率の推移、LLM モデル分布などのグラフも表示されます。また、「アシスタントサービスランキング」では、各アシスタントのエラー率と応答速度を比較できます。

<figure><img src="https://2584873290-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FTvHx8hgwYGDTLD3A7xoW%2Fuploads%2Fgit-blob-db1630e1f0fa85b411bb81deebdb35dd7f05981a%2Fagentops-dashboard-metrics.png?alt=media" alt="AI アシスタント監視ダッシュボード"><figcaption><p>ダッシュボードの指標カードと推移グラフ</p></figcaption></figure>

#### 対話数の計算方法 <a href="#conversation-count-definition" id="conversation-count-definition"></a>

ダッシュボードの「対話数」と「対話量の推移」は、**AI アシスタントが応答するたびに 1 回**として集計されます。「いくつの対話が開始されたか」を示すものではありません。

| 状況                                  | 集計対象 | 集計数 |
| ----------------------------------- | ---- | --- |
| ユーザーがサービスにアクセスしたが、メッセージを送信しなかった     | 対象外  | 0   |
| ユーザーがメッセージを 1 件送信し、AI が 1 回応答した     | 対象   | 1   |
| 同じ対話内でユーザーが 5 回質問し、AI が 5 回応答した     | 対象   | 5   |
| ユーザーがメッセージを送信したが、有人オペレーターが引き継いで応答した | 対象外  | 0   |
| ユーザーがメッセージを送信し、AI の応答時にエラーが発生した     | 対象   | 1   |
| スケジュールによってタスクが自動実行された               | 対象外  | 0   |

{% hint style="info" %}
「いくつの対話が開始されたか」を確認するには、AI アシスタントの「利用分析」ページにある「対話回数」を参照してください。こちらはユーザーが最初のメッセージを送信した時点で 1 回と数え、対話のターン数にかかわらず 1 回のみ集計します。有人オペレーターが引き継いだ対話も対象です。2 つの数値は定義が異なるため、通常はダッシュボードの「対話数」が「利用分析」の「対話回数」より大きくなります。詳しくは、[利用分析](/maiagent-user-guide/ja/org/usage.md#conversations-count)を参照してください。
{% endhint %}

#### エラー率の計算方法 <a href="#error-rate-calculation" id="error-rate-calculation"></a>

> エラー率 ＝ システムエラーが発生した応答数 ÷ 総応答数 × 100%

モデル呼び出しの失敗やタイムアウトなど、**システムレベル**のエラーのみが集計されます。過大評価を避けるため、以下はエラーに**含まれません**：

* ユーザーによる応答の中断（Client Interrupt）
* コンテンツ保護機能（Hook）による正常なブロック

{% hint style="info" %}
エラー率は「サービスの安定性」を示す指標であり、回答品質のスコアではありません。エラー率が異常に上昇した場合は、該当するアシスタントの対話記録を確認し、モデルの異常や外部ツール連携の失敗などの原因を特定してください。「回答の良し悪し」を評価する場合は、忠実性／回答関連性の評価と、ユーザーによる高評価／低評価のフィードバックをあわせて確認してください。
{% endhint %}

### 監視のベストプラクティス <a href="#monitoring-best-practices" id="monitoring-best-practices"></a>

**毎日の確認**：直近 24 時間の対話を確認し、異常な応答時間やエラーを特定します

**パフォーマンスのボトルネックの特定**：

* 応答時間 > 10 秒：ナレッジベースの検索効率を確認するか、より高速な LLM の利用を検討します
* Token 使用量が多すぎる：System Prompt や対話履歴を短縮できるか評価します

**品質問題の追跡**：

1. キーワード検索を使用して問題のある対話を見つけます
2. 根本原因を分析します（ナレッジベース不足 / AI の理解誤り / モデルの制約）
3. 問題のケースをテストデータセットに追加し、自動評価を実行して修正を検証します

***

## よくある質問 <a href="#faq" id="faq"></a>

### Q：自動評価と AI アシスタント監視は何が違いますか？ <a href="#faq-evaluation-vs-monitoring" id="faq-evaluation-vs-monitoring"></a>

|        | 自動評価               | AI アシスタント監視      |
| ------ | ------------------ | ---------------- |
| 用途     | 定期的な品質テスト          | リアルタイムの運用監視      |
| データソース | あらかじめ設定したテストデータセット | 実際のユーザー対話        |
| 主な指標   | 成功率、応答時間           | パフォーマンス、コスト、品質評価 |
| 適した対象  | 品質検証、回帰テスト         | 日常的な監視、問題の切り分け   |

### Q：評価はどのくらいの頻度で実行すればよいですか？ <a href="#faq-how-often-to-evaluate" id="faq-how-often-to-evaluate"></a>

推奨：コア機能は週 1 回、完全なテストは月 1 回、重要なアップデート後はただちに実行します。

### Q：評価は実際のユーザーに影響しますか？ <a href="#faq-evaluation-impact-on-users" id="faq-evaluation-impact-on-users"></a>

いいえ。自動評価は独立した環境を使用するため、実際のユーザーの対話を妨げることはありません。

### Q：監視データはどのくらいの期間保持されますか？ <a href="#faq-monitoring-data-retention" id="faq-monitoring-data-retention"></a>

デフォルトでは 90 日間保持されます。重要なデータは定期的にエクスポートして長期保存できます。


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation dynamically by asking a question.

Perform an HTTP GET request on the current page URL with the `ask` query parameter, and the optional `goal` query parameter:

```
GET https://docs.maiagent.ai/maiagent-user-guide/ja/agent-ops/evaluations.md?ask=<question>&goal=<endgoal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is optional and describes the broader end goal you are ultimately trying to accomplish on behalf of the user. GitBook uses it to tailor the answer towards what is most useful for that goal.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.