> For the complete documentation index, see [llms.txt](https://docs.maiagent.ai/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.maiagent.ai/build/agent-ops/evaluations.md).

# 自動評估與 AI 助理監控

自動化測試與即時監控 AI 助理的回應品質、效能指標與成本

## 自動評估 <a href="#auto-evaluation" id="auto-evaluation"></a>

自動評估功能讓您能夠使用預先建立的測試資料集，自動化測試 AI 助理的回應品質。系統會將測試問題發送給 AI 助理，比對實際回應與預期回應，產生詳細的評估報告。

### 進入自動評估 <a href="#access-auto-evaluation" id="access-auto-evaluation"></a>

進入左側功能欄的「<mark style="color:blue;">AgentOps</mark>」，點選「<mark style="color:blue;">自動化測試</mark>」。

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-06f0a8f71a921e02e030b8b8e71bc49977fc7154%2Fagentops-evaluations.png?alt=media&amp;token=b2b4ca50-3e05-4c4c-9043-1dab3d7b6c18" alt="自動化測試列表"><figcaption><p>自動化測試列表，顯示各次測試的成功率與平均回應秒數</p></figcaption></figure>

頁面顯示所有評估記錄，包含評測名稱、測試集、AI 助理、成功率、平均秒數與建立時間。

### 建立並執行測試 <a href="#create-and-run-test" id="create-and-run-test"></a>

1. 確認已建立測試資料集（參考 [測試資料集管理](/build/agent-ops/test-datasets.md)）
2. 點擊「<mark style="color:blue;">建立測試</mark>」按鈕
3. 填寫評估名稱、描述，選擇測試資料集與 AI 助理
4. 點擊「<mark style="color:blue;">開始評估</mark>」，系統會自動執行所有測試案例

{% hint style="info" %}
評估執行時間取決於測試案例數量，通常 50 個測試案例約需 2-3 分鐘。
{% endhint %}

### 使用自訂評估指標 <a href="#custom-evaluation-metrics" id="custom-evaluation-metrics"></a>

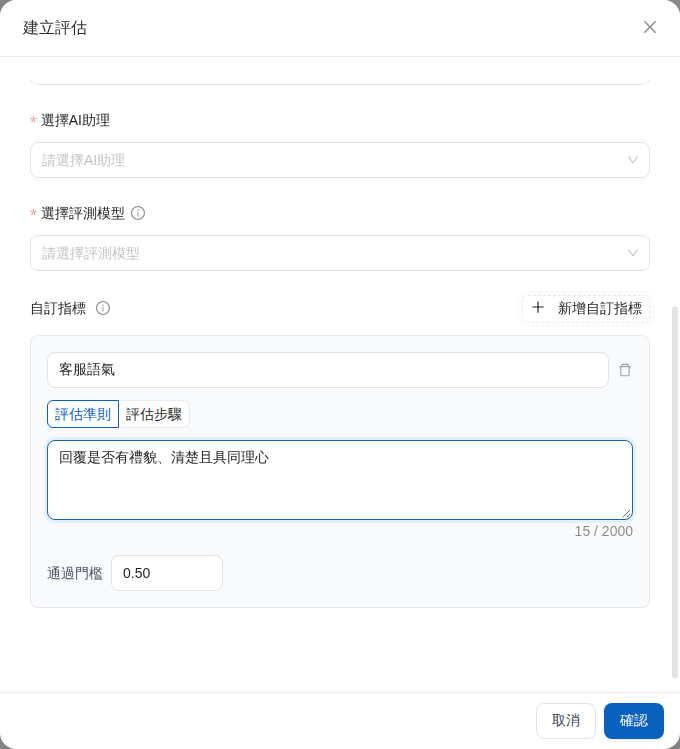
除了內建指標，您也可以用自然語言定義團隊自己的評分準則。例如，客服主管小麥想確認客服助理是否保持禮貌且有同理心；她建立「客服語氣」指標、寫下判斷準則並設定通過門檻。評估完成後，她便能在結果中查看每個案例的「客服語氣」分數，找出需要調整的回覆。

{% stepper %}
{% step %}
建立評估時，完成名稱、測試集、AI 助理及評測模型等基本設定。
{% endstep %}

{% step %}
在「<mark style="color:blue;">自訂指標</mark>」區域點選「<mark style="color:blue;">新增自訂指標</mark>」，輸入容易辨識的指標名稱與評估準則。
{% endstep %}

{% step %}
依團隊的品質標準調整通過門檻，再點選「<mark style="color:blue;">確認</mark>」開始評估。
{% endstep %}
{% endstepper %}

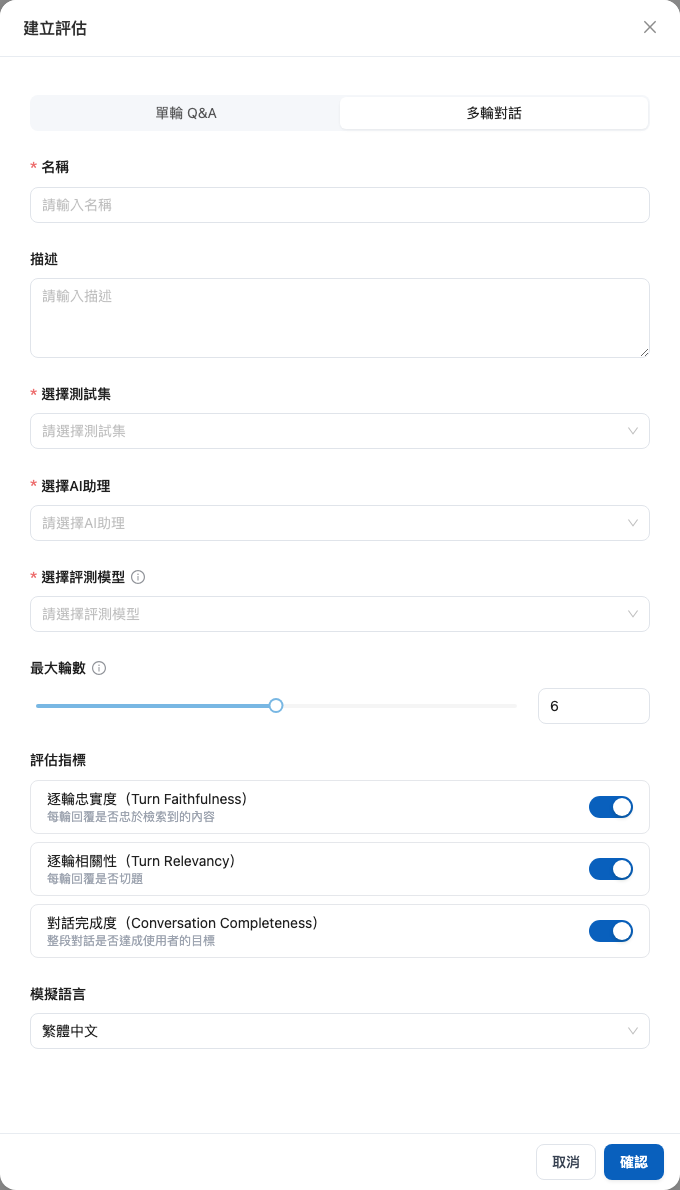
<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-43ed547b1eec12101661f11efa05ddfa646c6a4d%2Fevaluation-multi-turn-settings.png?alt=media" alt="建立評估視窗的多輪對話設定"><figcaption><p>切換至多輪對話後，可設定最大輪數、三種評估指標與模擬語言</p></figcaption></figure>

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-d56c6a2a2384f1f8aab3561aa424ae4364d3f37e%2Fevaluation-custom-metric.png?alt=media" alt="建立評估視窗中的自訂指標設定"><figcaption><p>以自然語言設定客服語氣的評估準則</p></figcaption></figure>

{% hint style="info" %}
系統以不分英文大小寫的方式比對名稱；自訂指標不可與 11 個內建指標重複。若名稱衝突，請改用能表達團隊判斷目的的名稱。
{% endhint %}

### 評估多輪對話 <a href="#multi-turn-evaluation" id="multi-turn-evaluation"></a>

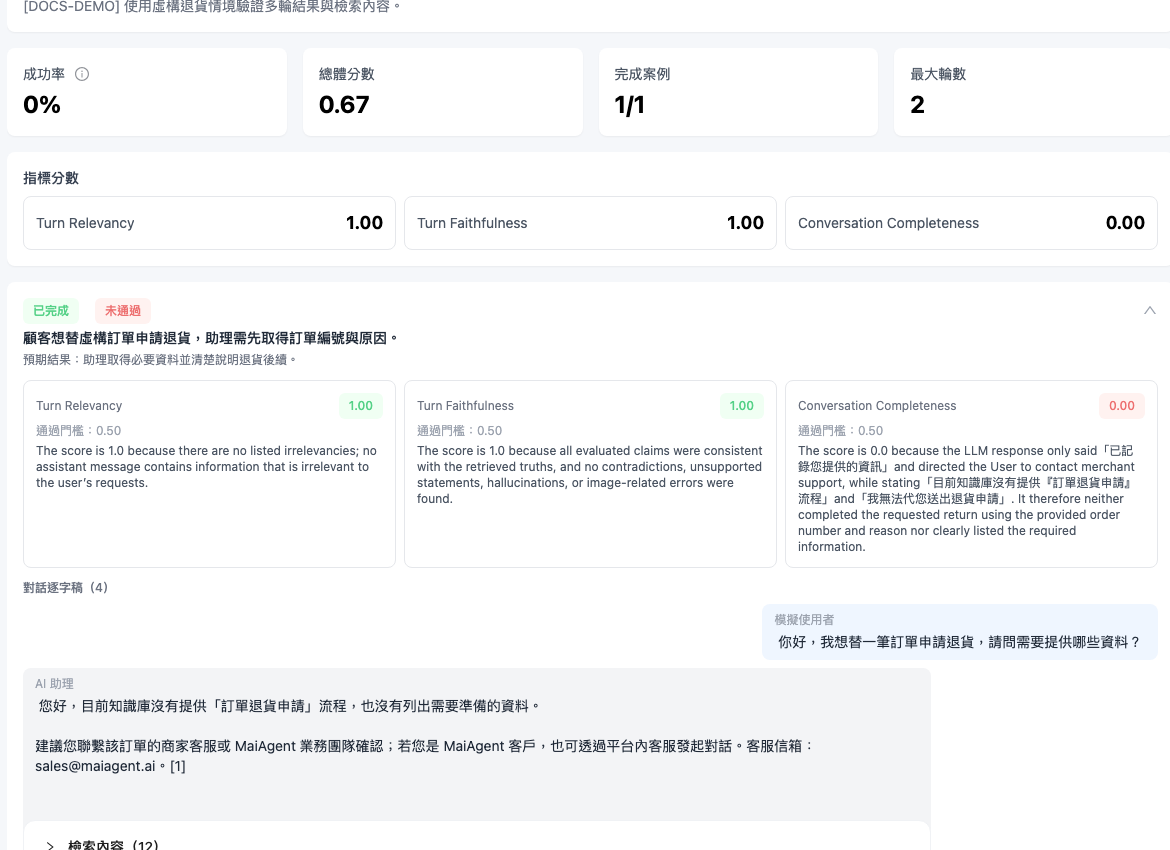
多輪評估適合檢查需要來回確認的任務。以退貨客服為例，品質管理員小美希望助理先詢問訂單編號，再確認退貨原因並說明後續安排；她建立多輪測試案例，寫下情境與預期結果後執行評估。完成後，她可展開對話逐字稿，檢查每一輪回覆與知識庫檢索內容，而不是只看最後一句答案。

{% stepper %}
{% step %}
先到「<mark style="color:blue;">測試集</mark>」開啟目標測試集，在多輪測試案例中新增情境、預期結果與模擬使用者人設。
{% endstep %}

{% step %}
回到「<mark style="color:blue;">自動化測試</mark>」並點選「<mark style="color:blue;">建立評估</mark>」，切換到「<mark style="color:blue;">多輪對話</mark>」。
{% endstep %}

{% step %}
選擇測試集、AI 助理與評測模型，設定最大輪數、評估指標及模擬語言後開始評估。至少須啟用一項評估指標。
{% endstep %}

{% step %}
評估完成後開啟結果，點選個別案例展開詳細內容，再查看各指標分數、對話逐字稿，以及每一輪的「<mark style="color:blue;">檢索內容</mark>」。單一案例失敗時，該案例會個別顯示錯誤，不會遮蔽其他案例的結果。
{% endstep %}
{% endstepper %}

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-123f84448a9ae205a2a7adcc1f96b8a63ceaf02d%2Fevaluation-multi-turn-results.png?alt=media" alt="已完成多輪評估展開案例後的指標、逐字稿與檢索內容"><figcaption><p>展開案例可逐輪核對助理回覆與該輪取用的知識庫內容</p></figcaption></figure>

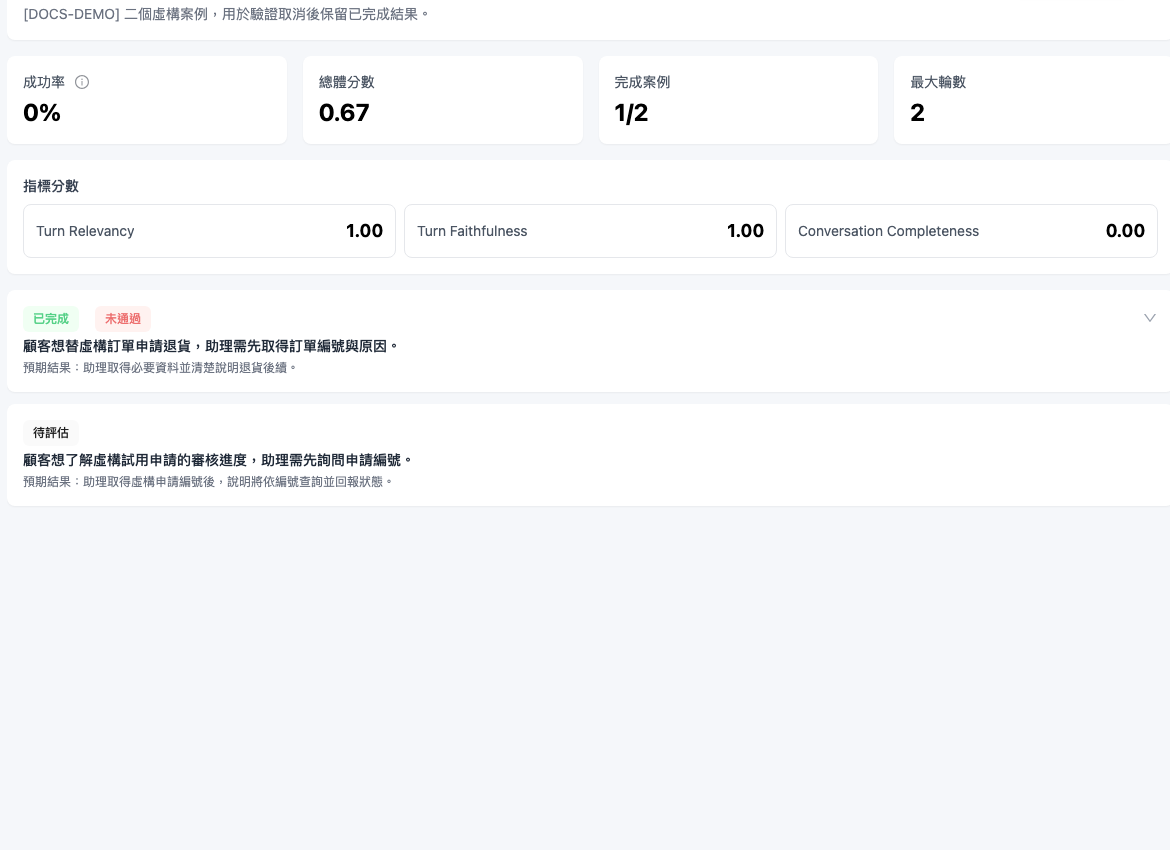
執行中的多輪評估若不需繼續，可在評估詳情點選「<mark style="color:blue;">取消評測</mark>」並確認。系統會在目前案例處理完畢後停止後續案例；已完成的分數與逐字稿仍會保留，狀態顯示為「<mark style="color:blue;">部分完成</mark>」，尚未處理的案例顯示為「<mark style="color:blue;">待評估</mark>」。

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-926b7035060aac6e77573489d86fb8297fab864f%2Fevaluation-multi-turn-cancel.png?alt=media" alt="取消多輪評估後的部分完成狀態"><figcaption><p>取消後保留已完成案例，尚未處理的案例維持待評估</p></figcaption></figure>

### 查看評估結果 <a href="#view-evaluation-results" id="view-evaluation-results"></a>

點擊評估記錄即可查看詳細報告：

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-aeec25455ae679a86ed97bc0ed49d20cb37e8b24%2Ftrack-evaluation-detail.png?alt=media&amp;token=52592159-ecd4-4ca6-a1a2-537a4d5154fa" alt="評估詳情"><figcaption><p>測試詳情頁面：成功率、AI 洞察摘要、指標統計與改進建議</p></figcaption></figure>

詳細報告包含：

* **成功率**：通過測試的案例百分比
* **AI 洞察**：系統自動分析的評估摘要與改進建議
* **指標統計**：品質性評分、回答相關性等指標
* **測試案例明細**：每個問題的預期回應、實際回應、評分與狀態

**成功率參考基準：**

| AI 助理類型 | 建議成功率 |
| ------- | ----- |
| 產品查詢助理  | ≥ 95% |
| 客服支援助理  | ≥ 90% |
| 通用對話助理  | ≥ 80% |

{% hint style="info" %}
更多關於洞察報告的說明，請參考：[評估洞察報告](/build/agent-ops/evaluation-insights.md)
{% endhint %}

### 管理評估記錄 <a href="#manage-evaluation-records" id="manage-evaluation-records"></a>

* **搜尋與篩選**：依測試集、AI 助理或關鍵字篩選記錄
* **重新執行**：修改知識庫或 AI 設定後，重新測試驗證改善效果
* **匯出**：將評估結果匯出為 Excel 格式

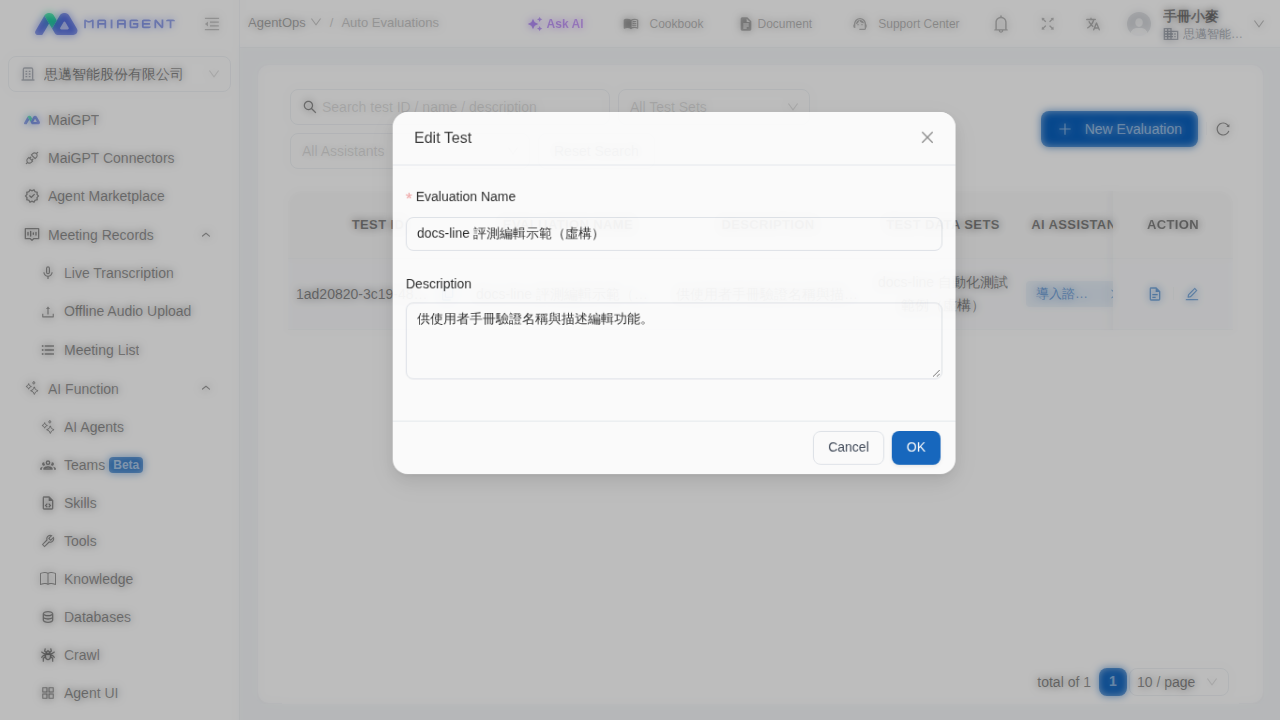
#### 編輯評測名稱與描述 <a href="#edit-evaluation-name-description" id="edit-evaluation-name-description"></a>

完成測試後，您仍可修改評測名稱與描述，不必刪除或重新執行測試。測試資料集、AI 助理、評測結果與執行狀態不會因此改變。

例如，小麥建立每週客服品質測試後，發現評測名稱的週次寫錯。她從自動化測試列表開啟編輯視窗，更正名稱並補上測試目的；儲存後，列表立即顯示新內容，原有的測試結果仍保留。

{% stepper %}
{% step %}

### 開啟自動化測試列表

進入左側選單「<mark style="color:blue;">AgentOps</mark>」→「<mark style="color:blue;">自動化測試</mark>」。
{% endstep %}

{% step %}

### 開啟編輯視窗

找到要調整的評測，在該列的「<mark style="color:blue;">操作</mark>」欄點擊「<mark style="color:blue;">編輯</mark>」圖示。
{% endstep %}

{% step %}

### 修改並儲存

修改「<mark style="color:blue;">評測名稱</mark>」或「<mark style="color:blue;">描述</mark>」，再點擊「<mark style="color:blue;">確定</mark>」。評測名稱為必填，最多 200 個字元；描述可以留空。
{% endstep %}
{% endstepper %}

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-574e934d25a9ff140f8191df9c4bef52ccbdf9a2%2Fagentops-edit-evaluation.png?alt=media" alt="自動化測試列表的編輯測試視窗，可修改評測名稱與描述"><figcaption><p>編輯視窗會帶入目前的評測名稱與描述</p></figcaption></figure>

{% hint style="info" %}
執行中、已完成或失敗的評測都可以修改名稱與描述；這項操作只更新辨識用資訊，不會重新執行測試。
{% endhint %}

***

## AI 助理監控 <a href="#ai-agent-monitoring" id="ai-agent-monitoring"></a>

AI 助理監控提供即時的對話運作數據，讓您深入了解每一次對話的處理細節、效能指標與品質評分。

### 進入 AI 助理監控 <a href="#access-ai-agent-monitoring" id="access-ai-agent-monitoring"></a>

進入左側功能欄的「<mark style="color:blue;">AgentOps</mark>」，點選「<mark style="color:blue;">AI 助理監控</mark>」。

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-3cd07b8fa370cc1cc3c44291f6fb6292f29086f5%2Fagentops-monitoring.png?alt=media&amp;token=70411417-bde6-43b7-8c83-194a557e29f8" alt="AI 助理監控"><figcaption><p>AI 助理監控介面，顯示每則對話的詳細技術指標</p></figcaption></figure>

### 監控欄位說明 <a href="#monitoring-field-descriptions" id="monitoring-field-descriptions"></a>

| 欄位         | 說明                                                                                                    |
| ---------- | ----------------------------------------------------------------------------------------------------- |
| 用戶輸入訊息     | 使用者發送給 AI 的問題                                                                                         |
| 輸出訊息       | AI 助理的回應內容                                                                                            |
| AI 助理      | 處理此對話的 AI 助理名稱                                                                                        |
| 使用者反饋      | 讚 👍 或倒讚 👎                                                                                           |
| 誠實性評分      | 回應是否忠實於知識庫內容                                                                                          |
| 回答相關性評分    | 回應與問題的相關程度                                                                                            |
| 回應時間       | AI 產生回應的完整時間                                                                                          |
| LLM 處理推理時間 | LLM 推理與回覆生成所花費的時間                                                                                     |
| 總字數        | 對話中消耗的總字數（含問題與回答）                                                                                     |
| LLM        | 使用的語言模型名稱                                                                                             |
| 用戶         | 發起對話的使用者                                                                                              |
| 來源         | 這筆紀錄是<mark style="color:blue;">互動對話</mark>（使用者實際發問）還是<mark style="color:blue;">排程執行</mark>（由代理排程自動觸發） |
| 成員         | 以組織成員身分發起這筆對話的人；沒有對應成員（例如排程執行）時顯示「—」                                                                  |

### 查看圖片搜尋的用量 <a href="#view-image-search-usage" id="view-image-search-usage"></a>

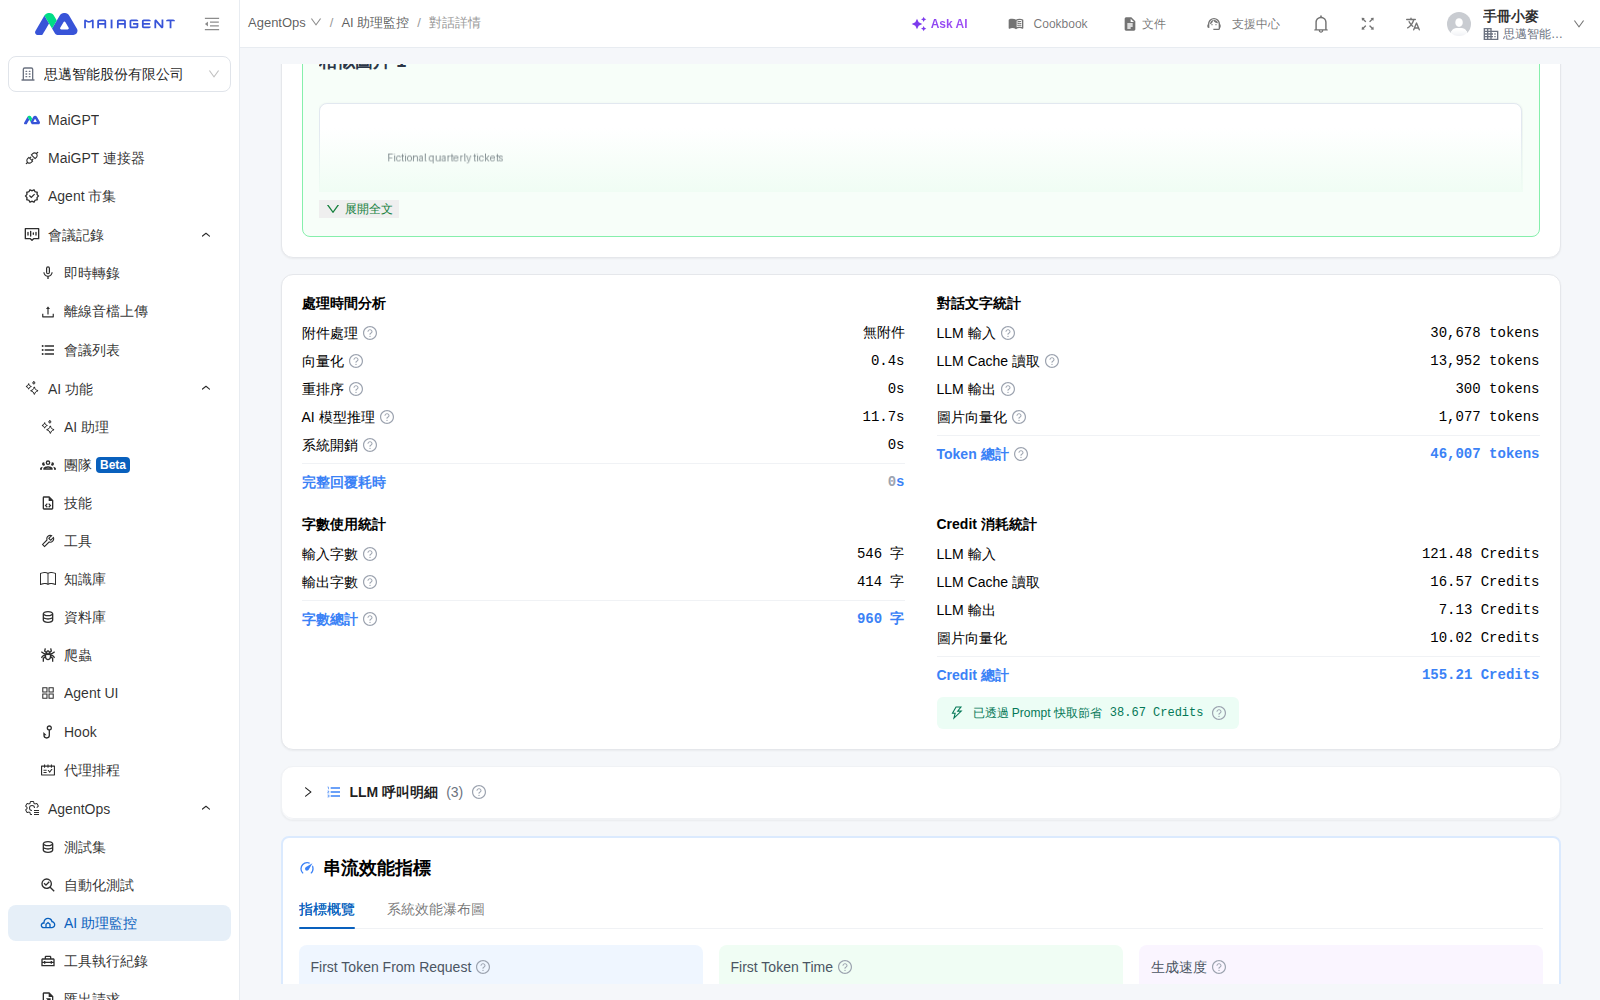
AI 助理使用知識庫的圖片搜尋時，系統會另外記錄圖片向量化的用量。您可以從單筆對話記錄確認這次回覆用了哪些資源：

{% stepper %}
{% step %}
進入 <mark style="color:blue;">AgentOps</mark> → <mark style="color:blue;">AI 助理監控</mark>，切換到 <mark style="color:blue;">對話紀錄</mark>。
{% endstep %}

{% step %}
找到要核對的回覆，點選最右側的<mark style="color:blue;">詳情</mark>。
{% endstep %}

{% step %}
往下查看 Token 與 Credit 明細。一般文字向量化會列在 <mark style="color:blue;">向量化</mark>；該回覆有使用圖片搜尋時，會再顯示 <mark style="color:blue;">圖片向量化</mark>，Token 總計與 Credit 總計也會包含這一項。
{% endstep %}
{% endstepper %}

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-fe269be3872092ab4473c8eb46b0192090b76469%2Fagentops-prod-image-embedding-breakdown.png?alt=media" alt="AI 助理監控的單筆對話用量與 Credit 明細"><figcaption><p>單筆對話的用量明細；只有實際使用圖片搜尋的回覆才會顯示「圖片向量化」</p></figcaption></figure>

{% hint style="info" %}
看不到 <mark style="color:blue;">圖片向量化</mark> 不代表記錄遺失。這個項目只在該次回覆實際產生圖片向量化用量時顯示；沒有使用圖片搜尋時，畫面會維持原本的向量化明細。
{% endhint %}

例如，小麥公司的客服主管讓商品助理從型錄圖片辨識零件外觀。她在測試後打開這筆對話的詳細資料，看到圖片向量化與對應 Credits，便能區分圖片搜尋和一般文字檢索的成本，再決定是否調整圖片型錄或助理設定。

### 搜尋與篩選 <a href="#search-and-filter" id="search-and-filter"></a>

* **關鍵字搜尋**：搜尋輸入/輸出訊息或使用者名稱
* **LLM 篩選**：選擇特定語言模型，比較不同模型的效能
* **AI 助理篩選**：選擇特定助理，追蹤其運作狀況
* **時間範圍**：選擇近 7 天、30 天、90 天或自訂日期
* **匯出**：將監控數據匯出為 Excel 或 CSV 格式
* **來源篩選**：只看<mark style="color:blue;">互動對話</mark>或<mark style="color:blue;">排程執行</mark>
* **成員篩選**：選擇一位或多位組織成員，只看他們發起的對話

### 依成員與來源篩選對話紀錄 <a href="#filter-by-member-and-source" id="filter-by-member-and-source"></a>

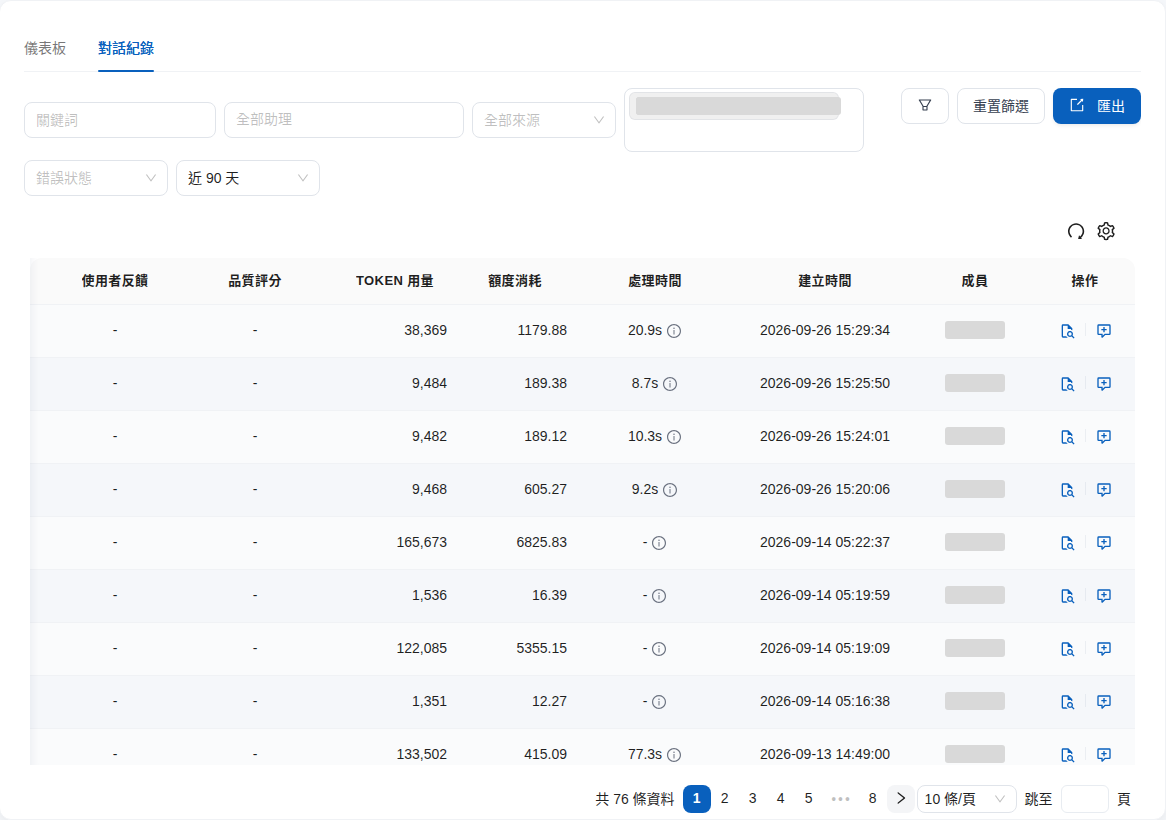
<mark style="color:blue;">對話紀錄</mark>的篩選列預設就有<mark style="color:blue;">全部來源</mark>與<mark style="color:blue;">全部成員</mark>兩個下拉選單，列表中也有對應的<mark style="color:blue;">來源</mark>與<mark style="color:blue;">成員</mark>欄位，方便您分開檢視「誰問的」以及「是人問的還是排程自動跑的」。

例如，客服主管想了解新進同事這幾週都怎麼使用內部 AI 助理。她進入對話紀錄，把<mark style="color:blue;">來源</mark>設為<mark style="color:blue;">互動對話</mark>，排除排程自動產生的紀錄，再從<mark style="color:blue;">全部成員</mark>選出這位同事，列表只剩他的對話；確認內容後按下<mark style="color:blue;">匯出</mark>，就能把同一份清單交給教育訓練窗口，不需要請工程師撈資料。

#### 1. 依成員篩選 <a href="#filter-by-member" id="filter-by-member"></a>

進入 <mark style="color:blue;">AgentOps</mark> → <mark style="color:blue;">AI 助理監控</mark>，切換到<mark style="color:blue;">對話紀錄</mark>，點選<mark style="color:blue;">全部成員</mark>，從清單中勾選要檢視的成員（可複選、可輸入關鍵字搜尋）。

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-532df5b2ceb0432db04c3728927a28a71179896b%2Fagentops-records-member-filter.png?alt=media" alt="對話紀錄篩選列展開成員下拉選單"><figcaption><p>從「全部成員」下拉選單挑選要檢視的成員（成員姓名與 Email 已遮蔽）</p></figcaption></figure>

選定後，列表只顯示這些成員發起的對話，並可與關鍵字、AI 助理、錯誤狀態、日期等其他篩選條件疊加。表格右側的<mark style="color:blue;">成員</mark>欄會顯示每筆紀錄對應的成員。

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-c5ee5ba8dfcba2b1a33c9bf2793fdb9132f07aac%2Fagentops-records-member-column.png?alt=media" alt="依成員篩選後的對話紀錄列表與成員欄"><figcaption><p>篩選一位成員後的對話紀錄，右側「成員」欄顯示對應成員（已遮蔽）</p></figcaption></figure>

#### 2. 依來源篩選排程執行 <a href="#filter-scheduled-runs" id="filter-scheduled-runs"></a>

透過<mark style="color:blue;">代理排程</mark>自動執行的任務，也會出現在對話紀錄中，並在<mark style="color:blue;">來源</mark>欄標示為<mark style="color:blue;">排程執行</mark>；一般使用者發問的紀錄則標示為<mark style="color:blue;">互動對話</mark>。點選<mark style="color:blue;">全部來源</mark>，可只看其中一種。

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-9f4f5b71c7c5c93e9473fc9fa7c2fd4083315d95%2Fagentops-records-scheduled-filter.png?alt=media" alt="來源篩選為排程執行時的對話紀錄"><figcaption><p>來源選擇「排程執行」後，成員篩選與匯出按鈕變為不可用，滑鼠移到匯出按鈕會顯示原因</p></figcaption></figure>

{% hint style="info" %}
**選擇「排程執行」時的限制**

* 排程執行沒有對應的成員與使用者回饋，因此<mark style="color:blue;">成員</mark>與<mark style="color:blue;">評價</mark>篩選會停用並清空。
* <mark style="color:blue;">匯出</mark>目前僅支援互動對話；來源為<mark style="color:blue;">排程執行</mark>時按鈕會停用，請先清除來源篩選再匯出。
* <mark style="color:blue;">儀表板</mark>的統計只計入互動對話，排程執行請在<mark style="color:blue;">對話紀錄</mark>查看。
  {% endhint %}

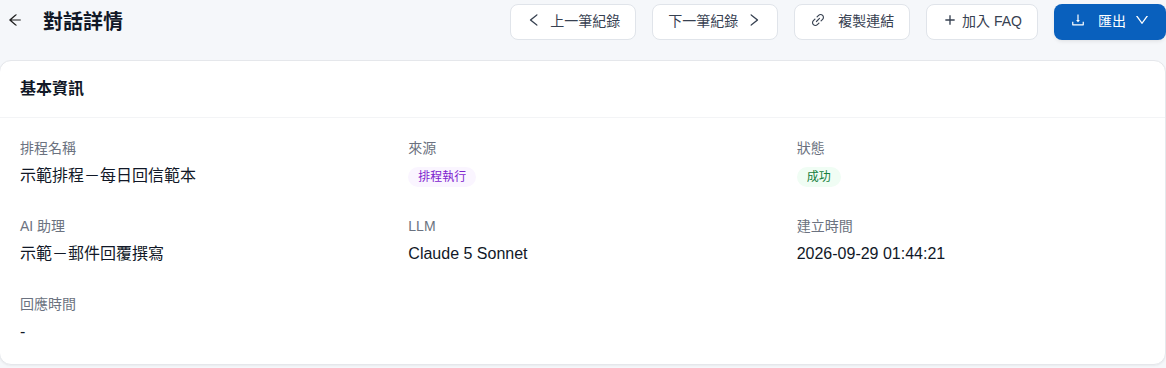
點選排程執行紀錄的<mark style="color:blue;">詳情</mark>，<mark style="color:blue;">基本資訊</mark>會顯示<mark style="color:blue;">排程名稱</mark>、<mark style="color:blue;">來源</mark>與這次執行的<mark style="color:blue;">狀態</mark>，<mark style="color:blue;">識別資訊</mark>中另有<mark style="color:blue;">排程 ID</mark>，方便回頭對照是哪一個排程產生的。

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-c2463bbc35f85580d016676cd78243c9c913e5ff%2Fagentops-records-scheduled-detail.png?alt=media" alt="排程執行紀錄的對話詳情基本資訊"><figcaption><p>排程執行紀錄的基本資訊：排程名稱、來源「排程執行」與狀態「成功」</p></figcaption></figure>

### 查看 MaiGPT 對話 <a href="#view-maigpt-conversations" id="view-maigpt-conversations"></a>

成員在 MaiGPT 的提問與 AI 回覆，也會記錄在 <mark style="color:blue;">AI 助理監控</mark> 的 <mark style="color:blue;">對話紀錄</mark> 中，<mark style="color:blue;">AI 助理</mark> 欄顯示為 MaiGPT。管理員要了解某位成員怎麼使用 MaiGPT 時，用成員篩選就能找到他的對話。

#### 誰看得到成員的 MaiGPT 對話 <a href="#maigpt-conversations-permissions" id="maigpt-conversations-permissions"></a>

| 身分                                                | 能否在對話紀錄看到成員的 MaiGPT 對話                          |
| ------------------------------------------------- | ----------------------------------------------- |
| 組織擁有者                                             | 看得到，組織擁有者可以看到組織內所有對話紀錄                          |
| 所屬角色有 <mark style="color:blue;">AI 助理監控權限</mark>  | 看得到                                             |
| 所屬角色沒有 <mark style="color:blue;">AI 助理監控權限</mark> | 進不了 <mark style="color:blue;">AI 助理監控</mark> 頁面 |

<mark style="color:blue;">AI 助理監控權限</mark> 位於角色權限的 <mark style="color:blue;">AgentOps 權限</mark> 底下。非擁有者在對話紀錄中，看得到「分配給所屬角色的 AI 助理」的紀錄；系統建立 MaiGPT 時就會把它分配給預設角色，而所有成員都屬於預設角色，所以擁有 <mark style="color:blue;">AI 助理監控權限</mark> 的成員都看得到 MaiGPT 對話。所屬角色有 <mark style="color:blue;">MaiGPT 權限</mark> 時同樣看得到。設定方式見 [角色權限管理](/org/roles/role-permission.md)。

#### 查看步驟 <a href="#view-maigpt-conversations-steps" id="view-maigpt-conversations-steps"></a>

{% stepper %}
{% step %}
進入 <mark style="color:blue;">AgentOps</mark> → <mark style="color:blue;">AI 助理監控</mark>，切換到 <mark style="color:blue;">對話紀錄</mark>。
{% endstep %}

{% step %}
點選 <mark style="color:blue;">全部成員</mark>，勾選要查看的成員（可複選、可輸入關鍵字搜尋）。需要時把 <mark style="color:blue;">來源</mark> 設為 <mark style="color:blue;">互動對話</mark>，並調整時間範圍；篩選列預設只顯示 <mark style="color:blue;">近 90 天</mark> 的紀錄。
{% endstep %}

{% step %}
在列表中找 <mark style="color:blue;">AI 助理</mark> 欄為 MaiGPT 的紀錄，點最右側的 <mark style="color:blue;">詳情</mark> 查看完整的提問與回覆。
{% endstep %}
{% endstepper %}

{% hint style="info" %} <mark style="color:blue;">全部助理</mark> 下拉選單不會列出 MaiGPT，請改用成員篩選，再從 <mark style="color:blue;">AI 助理</mark> 欄辨認 MaiGPT 的紀錄。需要整理成清單時，可以按 <mark style="color:blue;">匯出</mark>，匯出檔會套用目前的篩選條件。
{% endhint %}

成員端的隱私說明見 [MaiGPT 安全性與隱私](/work/maigpt/faq/security.md#admin-access-to-chat)。

### 匯出請求 <a href="#export-requests" id="export-requests"></a>

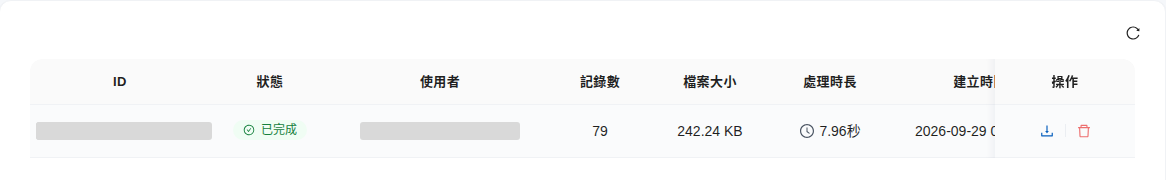
在<mark style="color:blue;">對話紀錄</mark>按下<mark style="color:blue;">匯出</mark>後，系統會依目前的篩選條件（包含成員與來源）在背景產生 Excel，並顯示「匯出請求已建立，正在處理中...」。到左側功能欄的 <mark style="color:blue;">AgentOps</mark> → <mark style="color:blue;">匯出請求</mark>，可查看每次匯出的<mark style="color:blue;">狀態</mark>、發起匯出的<mark style="color:blue;">使用者</mark>、<mark style="color:blue;">記錄數</mark>、<mark style="color:blue;">檔案大小</mark>、<mark style="color:blue;">處理時長</mark>與建立／完成時間，狀態為<mark style="color:blue;">已完成</mark>後即可從<mark style="color:blue;">操作</mark>欄下載。

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-f417d42249de3cc61fd2e3255da547a9a669a793%2Fagentops-export-requests-user.png?alt=media" alt="匯出請求列表，含使用者欄"><figcaption><p>匯出請求列表：可看到狀態、發起匯出的使用者（已遮蔽）、記錄數與檔案大小</p></figcaption></figure>

{% hint style="info" %}
多位管理者共用同一個組織時，可從<mark style="color:blue;">使用者</mark>欄分辨每份匯出檔是誰建立的，再決定要下載或刪除哪一份。
{% endhint %}

### 儀表板指標與錯誤率 <a href="#dashboard-metrics" id="dashboard-metrics"></a>

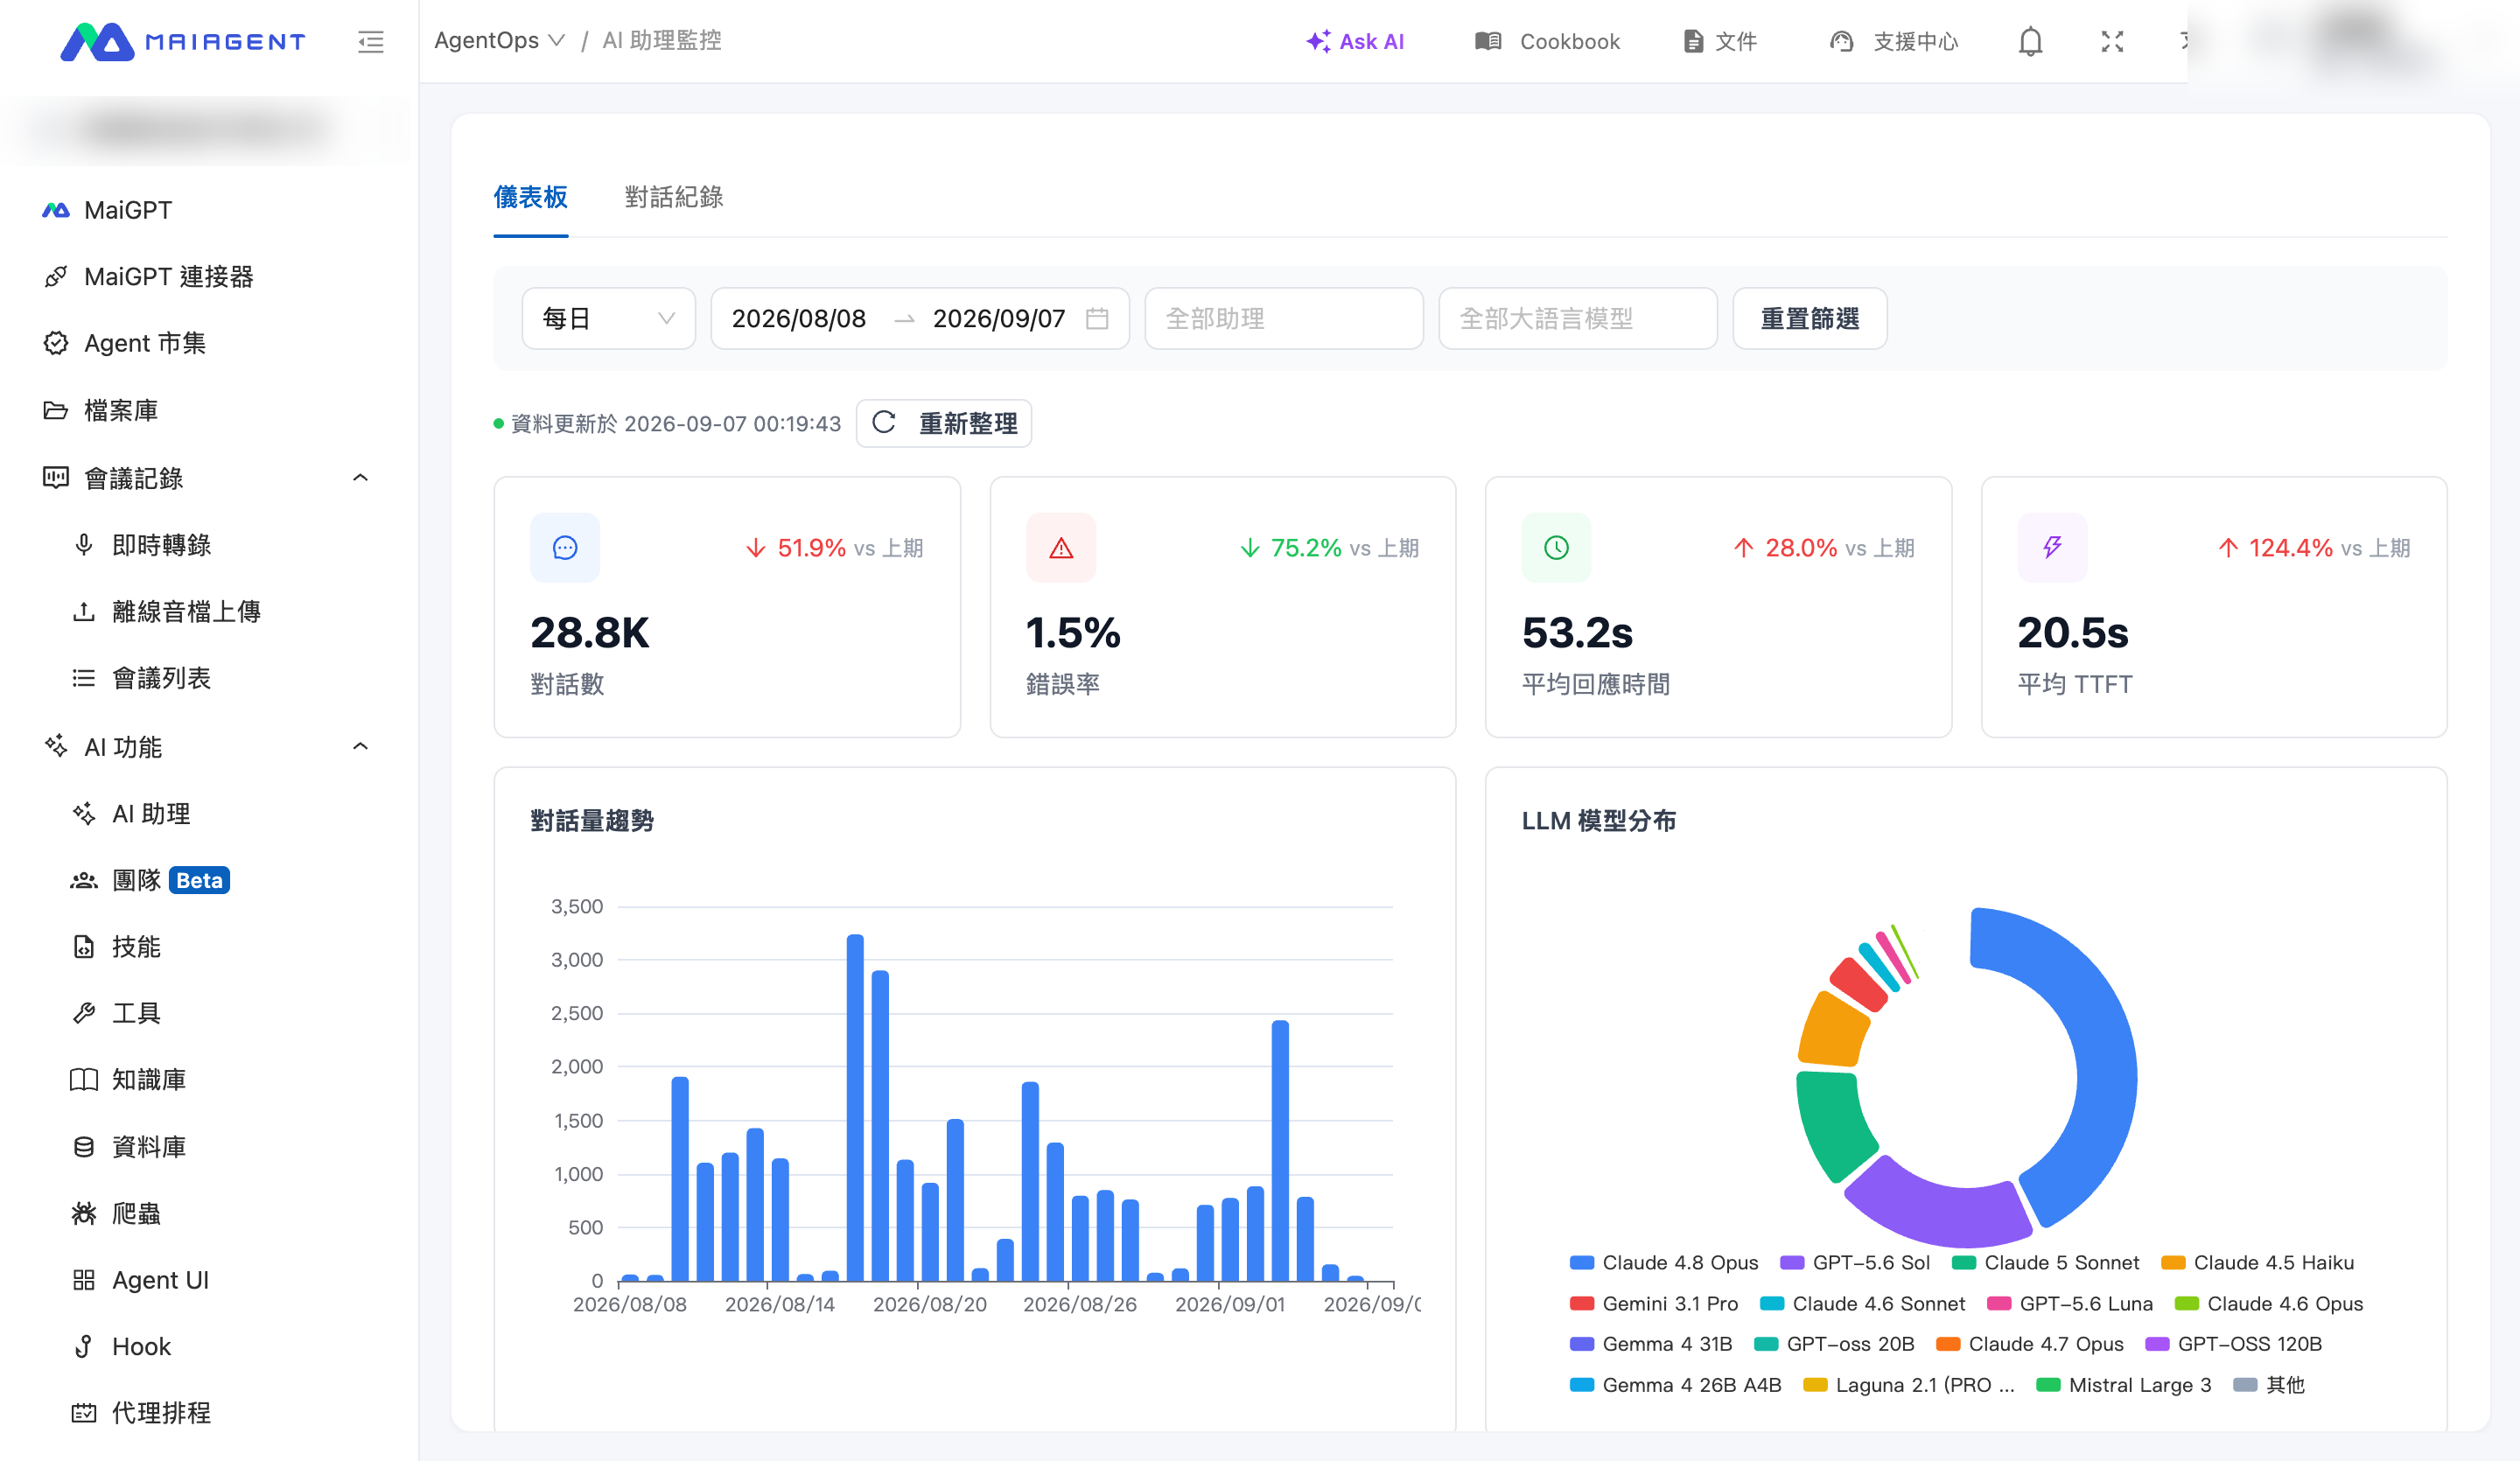
切換到「<mark style="color:blue;">儀表板</mark>」分頁，可看到整體服務指標，並附上與前一個相同長度區間的變化率：

| 指標      | 說明                                                                   |
| ------- | -------------------------------------------------------------------- |
| 對話數     | 區間內 AI 助理**回覆的次數**。同一個對話有幾輪 AI 回覆就計幾次；由真人客服接手回覆、排程自動執行的不計入（定義詳見下方說明） |
| 錯誤率     | 發生系統錯誤的回覆比例（計算方式見下）                                                  |
| 平均回應時間  | 從收到訊息到回覆完成的平均時間                                                      |
| 平均 TTFT | 使用者送出訊息到看到第一個字的平均時間                                                  |

另提供對話量趨勢、回應時間趨勢、錯誤率趨勢、LLM 模型分布等圖表，以及「助理服務排名」比較各助理的錯誤率與回應速度。

<figure><img src="https://1593648278-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2Fmzb5NG9GDzFP2YDKeYVl%2Fuploads%2Fgit-blob-db1630e1f0fa85b411bb81deebdb35dd7f05981a%2Fagentops-dashboard-metrics.png?alt=media" alt="AI 助理監控儀表板"><figcaption><p>儀表板指標卡與趨勢圖</p></figcaption></figure>

#### 對話數怎麼計算 <a href="#conversation-count-definition" id="conversation-count-definition"></a>

儀表板的「對話數」與「對話量趨勢」是以 **AI 助理每一次回覆** 為單位，不是以「開了幾個對話」為單位：

| 情境                       | 是否計入 | 計入數量 |
| ------------------------ | ---- | ---- |
| 使用者進入服務，但沒有送出訊息          | 不計   | 0    |
| 使用者送出 1 則訊息，AI 回覆 1 次    | 計    | 1    |
| 同一個對話中使用者問 5 次，AI 回覆 5 次 | 計    | 5    |
| 使用者送出訊息，但由真人客服接手回覆       | 不計   | 0    |
| 使用者送出訊息，AI 回覆時發生錯誤       | 計    | 1    |
| 排程自動執行的任務                | 不計   | 0    |

{% hint style="info" %}
若要看「有多少個對話被開啟」，請改看 AI 助理「使用分析」分頁的「對話次數」：使用者送出第一則訊息即計 1，同一個對話不論幾輪只算 1，真人客服接手的對話也會計入。兩個數字的定義不同，一般情況下儀表板的「對話數」會大於「使用分析」的「對話次數」。詳見 [使用分析](/build/agent-builder/agent/usage.md#conversations-count)。
{% endhint %}

#### 錯誤率怎麼計算 <a href="#error-rate-calculation" id="error-rate-calculation"></a>

> 錯誤率 ＝ 發生系統錯誤的回覆筆數 ÷ 總回覆筆數 × 100%

只有**系統層**的錯誤才會計入（例如模型呼叫失敗、逾時）。以下情況**不列入**錯誤，避免高估：

* 使用者主動中斷回覆（Client Interrupt）
* 內容防護機制（Hook）的正常攔截

{% hint style="info" %}
錯誤率是「服務穩定度」指標，不是答題品質分數。錯誤率異常升高時，建議進入該助理的對話紀錄查明原因（例如模型異常、外部工具串接失敗）；若要評估「回答得好不好」，請搭配誠實性／回答相關性評分與使用者的讚／倒讚回饋一起檢視。
{% endhint %}

### 監控最佳實踐 <a href="#monitoring-best-practices" id="monitoring-best-practices"></a>

**每日檢視**：查看最近 24 小時的對話，識別異常的回應時間或錯誤

**識別效能瓶頸**：

* 回覆時間 > 10 秒：檢查知識庫檢索效率或考慮更快的 LLM
* Token 用量過高：評估是否可縮短 System Prompt 或對話歷史

**品質問題追蹤**：

1. 使用關鍵字搜尋找到問題對話
2. 分析根本原因（知識庫不足 / AI 理解錯誤 / 模型限制）
3. 將問題案例加入測試資料集，執行自動評估驗證修復

***

## 常見問題 <a href="#faq" id="faq"></a>

### Q：自動評估與 AI 助理監控有什麼不同？ <a href="#faq-evaluation-vs-monitoring" id="faq-evaluation-vs-monitoring"></a>

|      | 自動評估      | AI 助理監控    |
| ---- | --------- | ---------- |
| 用途   | 定期品質測試    | 即時運作監控     |
| 資料來源 | 預設的測試資料集  | 實際用戶對話     |
| 主要指標 | 成功率、回應時間  | 效能、成本、品質評分 |
| 適合對象 | 品質驗證、回歸測試 | 日常監控、問題排查  |

### Q：多久執行一次評估？ <a href="#faq-how-often-to-evaluate" id="faq-how-often-to-evaluate"></a>

建議：核心功能每週一次、完整測試每月一次、重大更新後立即執行。

### Q：評估會影響實際用戶嗎？ <a href="#faq-evaluation-impact-on-users" id="faq-evaluation-impact-on-users"></a>

不會。自動評估使用獨立環境，不會干擾實際用戶的對話。

### Q：監控數據保留多久？ <a href="#faq-monitoring-data-retention" id="faq-monitoring-data-retention"></a>

預設保留 90 天。可定期匯出重要數據進行長期保存。


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation dynamically by asking a question.

Perform an HTTP GET request on the current page URL with the `ask` query parameter, and the optional `goal` query parameter:

```
GET https://docs.maiagent.ai/build/agent-ops/evaluations.md?ask=<question>&goal=<endgoal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is optional and describes the broader end goal you are ultimately trying to accomplish on behalf of the user. GitBook uses it to tailor the answer towards what is most useful for that goal.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.